
Gouverner les comptes de service et agents autonomes
Gouverner les comptes de service et agents autonomes
Section intitulée « Gouverner les comptes de service et agents autonomes »Un compte de service sans propriétaire, sans date de fin et avec des droits accumulés n’est pas une dette technique. C’est une porte d’accès dont personne ne surveille la serrure. La gouvernance des identités machines doit donc entrer dans les mêmes processus de responsabilité, de revue et de retrait que les identités humaines.
→ Lire l’explication complète de la marmotte
Inventaire des comptes de service et propriété
Section intitulée « Inventaire des comptes de service et propriété »Une identité machine est une identité utilisée par un logiciel, une tâche planifiée, un connecteur ou un équipement, plutôt que par une personne. Elle peut prendre la forme d’un compte annuaire, d’un principal cloud, d’un compte de base de données, d’un jeton d’accès ou d’une identité de charge de travail dans un orchestrateur. Le format change. Le problème de gouvernance ne change pas.
Le compromis central est net : imposer un propriétaire nominatif, une finalité et une échéance ralentit la création d’accès ponctuels ; laisser créer librement produit une vitesse locale payée par une exposition durable. La recommandation est de refuser toute identité machine sans responsable métier et responsable technique distincts. Le premier justifie l’accès, le second connaît la dépendance opérationnelle. Une boîte fonctionnelle, une équipe ou un ticket fermé ne sont pas des responsables. Ce sont des cachettes à cadavres administratifs.
L’inventaire doit agréger les plans de contrôle, pas seulement l’annuaire d’entreprise : gestion des identités et des accès, plateformes cloud, annuaires de répertoires, systèmes de gestion de code source, outils d’intégration continue, bases de données, outils de supervision, coffres à secrets et équipements réseau. IAM signifie Identity and Access Management, soit le système qui attribue et contrôle les accès. Une exportation IAM seule rate les jetons créés dans un outil de déploiement ou les comptes locaux hérités d’un progiciel.
Chaque entrée d’inventaire doit contenir au minimum :
- un identifiant immuable et un nom lisible ;
- le type d’exécutant : application, tâche, équipement, intégration, bot ou agent autonome ;
- le propriétaire métier, le propriétaire technique et leur identifiant humain ;
- le système émetteur, les systèmes cibles et l’environnement ;
- la finalité documentée, liée à un service ou une capacité métier ;
- les rôles, groupes et autorisations effectives, pas seulement les droits demandés ;
- la date de création, la dernière authentification observée, la prochaine revue et une date d’expiration ;
- le mécanisme d’authentification et la référence vers le secret, sans jamais y recopier le secret.
L’identité doit être corrélée à l’exécution réelle. Un compte déclaré inactif mais vu dans les journaux d’authentification n’est pas inactif. À l’inverse, un compte sans événement depuis sa période de grâce doit être suspendu avant suppression. La suspension conserve les preuves et révèle les dépendances cachées. La suppression directe transforme une erreur de classement en incident de production, puis en débat métaphysique sur la définition de « critique ».
Les fondations d’identité humaine restent nécessaires : gouverner les identités et distinguer les habilitations des personnes de celles des processus évitent de déguiser un compte partagé en automatisation. Les règles de liaison aux annuaires, notamment l’abandon des authentifications anonymes ou en clair, relèvent aussi du socle décrit dans le durcissement LDAP.
Revues d’accès adaptées aux identités machines
Section intitulée « Revues d’accès adaptées aux identités machines »Une revue d’accès humaine demande généralement : « cette personne a-t-elle encore besoin de ce rôle ? ». Pour une identité machine, la question correcte est : « ce processus existe-t-il encore, exécute-t-il encore cette action, et ce niveau d’autorisation reste-t-il nécessaire ? » La différence est déterminante. Un propriétaire valide trop souvent un nom de compte sans vérifier son graphe de permissions.
La revue trimestrielle convient aux accès privilégiés, aux comptes capables de modifier des identités, de lire des secrets, de déployer du code ou d’accéder à des données sensibles. Une revue semestrielle suffit pour les identités à faible privilège, à condition qu’une détection d’inactivité fonctionne en continu. Une revue annuelle pour un compte de production est une décoration réglementaire avec un tableur. Elle détecte surtout les erreurs déjà anciennes.
Le paquet de revue doit montrer les droits effectifs, les connexions et actions observées depuis la revue précédente, les ressources touchées, le propriétaire, la date de fin et les dépendances déclarées. Une approbation sans ces éléments ne certifie rien. Elle atteste seulement qu’un bouton a été pressé, activité très populaire dans l’industrie de la conformité.
La décision admise doit être limitée à quatre états : conserver sans changement, réduire les droits, suspendre, retirer. Ajouter des droits pendant une campagne de recertification mélange contrôle et demande de changement. Ce raccourci fait gagner une réunion et perdre toute traçabilité de la justification.
Les comptes techniques doivent apparaître dans la campagne classique, mais avec un formulaire différent et un approbateur technique obligatoire. Le responsable hiérarchique d’un propriétaire métier ne peut pas évaluer un rôle de base de données ou une délégation cloud. Une revue à deux signatures est justifiée pour les privilèges élevés : le métier confirme la finalité, l’exploitation confirme la nécessité technique.
Exemple d’inventaire exploitable pour une revue
Section intitulée « Exemple d’inventaire exploitable pour une revue »Un inventaire peut commencer par des exports normalisés, puis être enrichi par les journaux. Un premier tri désigne les comptes qui nécessitent une revue prioritaire : ceux sans propriétaire, sans expiration ou inactifs depuis plus de 90 jours.
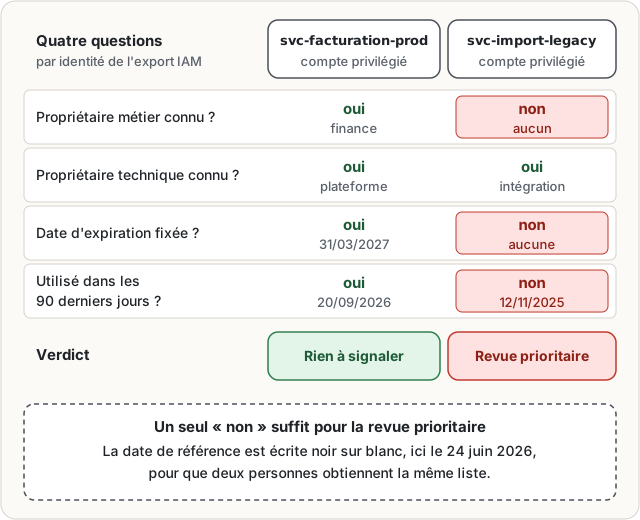
Ce contrôle ne remplace pas les connecteurs vers les sources autoritatives. Il impose surtout un contrat de données : si une plateforme ne peut pas fournir propriétaire, expiration et dernière activité, son identité ne peut pas être gouvernée correctement. Il faut alors corriger l’intégration ou bloquer la création de nouvelles identités sur cette plateforme.
Rotation des secrets et continuité de service
Section intitulée « Rotation des secrets et continuité de service »La rotation réduit la durée pendant laquelle un secret volé reste exploitable. Elle ne détecte pas le vol, ne retire pas les droits excessifs et ne protège pas un processus déjà compromis. Le reste doit venir de droits minimaux, de journaux d’audit centralisés, de détection d’anomalies et du cloisonnement réseau. La rotation n’est pas de l’eau bénite pour mots de passe.
La fréquence dépend de la capacité de renouvellement, pas d’un chiffre décoratif. Un secret à privilège élevé utilisé par un service automatisé doit être roté tous les 30 à 90 jours si le remplacement est automatisé et testé. Un jeton de session doit vivre beaucoup moins longtemps, idéalement quelques minutes ou heures selon le risque et le coût de réauthentification. Un secret statique roté annuellement parce que « l’application est fragile » n’est pas une politique : c’est un constat de dette à traiter.
La rotation manuelle ne doit être acceptée que pour une exception documentée, avec date de retrait, responsable et exercice de remplacement. Toute rotation manuelle finit oubliée, généralement après le départ de la personne qui possédait le mot de passe dans un carnet. L’automatisation doit permettre deux secrets valides pendant une fenêtre limitée : créer le nouveau, distribuer sa référence, redémarrer ou recharger les consommateurs, vérifier les authentifications, puis révoquer l’ancien. Sans chevauchement, une rotation est une coupure planifiée qui prétend être une mesure de sécurité.
Les prérequis sont concrets : coffre à secrets disponible depuis les environnements concernés, autorisation de lecture limitée au processus attendu, rechargement dynamique ou redémarrage maîtrisé, métriques d’échec d’authentification et journalisation de chaque lecture. Les sauvegardes doivent contenir les métadonnées de politique et de propriété, jamais une collection de secrets exportés en clair. La reprise doit inclure un accès de secours contrôlé au coffre, sinon l’incident du coffre devient un arrêt global avec une documentation admirable et inutilisable.
La mécanique de clés, certificats et identités de charge de travail relève des pages cryptographie et PKI et TLS. Ici, le point non négociable reste organisationnel : un mécanisme d’émission parfait ne répond pas à la question de savoir pourquoi cette identité garde un rôle administrateur trois ans plus tard.
Agents autonomes, bots et responsabilité d’action
Section intitulée « Agents autonomes, bots et responsabilité d’action »Un agent logiciel autonome utilise un modèle de langage, des règles ou une planification pour choisir des actions parmi des outils autorisés. LLM signifie Large Language Model, modèle statistique capable de produire et d’interpréter du texte. Un agent LLM n’est pas un compte de service classique : un compte classique exécute un flux déterminé, tandis qu’un agent peut sélectionner une action selon une entrée variable, potentiellement manipulée.
Cette différence impose une identité par agent, par environnement et par finalité. Jamais une identité commune de type bot-prod pour tous les agents. Chaque action doit porter l’identité de l’agent, l’identité humaine ou applicative qui l’a déclenché, l’outil appelé, l’autorisation évaluée et la décision produite. Sans chaîne de responsabilité, l’agent devient un stagiaire invisible avec accès administrateur. Le secteur appelle parfois cela « autonomie augmentée ». Le journal d’incident l’appelle autrement.
La responsabilité de l’action reste portée par un responsable humain désigné, même si l’agent choisit l’appel technique. Ce responsable ne valide pas chaque requête, mais valide le périmètre, les outils disponibles, les données accessibles et les seuils d’escalade. Les actions irréversibles, financières, administratives ou d’exfiltration doivent exiger une approbation humaine séparée. Le fait qu’un agent puisse générer une commande ne crée aucun droit à l’exécuter.
Par défaut, attribuer lecture sur un jeu de données minimal, absence de privilège d’administration, absence d’accès direct aux secrets, quotas d’appels, limites de volume, réseau sortant réduit et durée de vie courte. Séparer strictement l’identité qui lit des données de celle qui déclenche une action modifiante. Les attaques par injection d’instructions cherchent précisément à faire confondre une donnée non fiable avec un ordre. Les permissions doivent survivre à cette confusion, car le modèle ne la détectera pas de manière fiable.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans cette gouvernance, la porte reste entrouverte de façon durable. Une identité sans échéance conserve ses droits bien après l’arrêt du traitement qui la justifiait, et son secret reste valide tant que personne ne le révoque : la fenêtre d’exploitation n’est plus mesurée en jours mais en années. En cas d’alerte, l’absence de propriétaire et de dépendances déclarées empêche de couper un accès sans risquer d’interrompre un flux inconnu, ce qui allonge le temps de confinement. L’attribution devient également impossible : plusieurs traitements partageant un même compte produisent des journaux où aucune action ne se rattache à un déclencheur identifiable, donc aucune reconstitution fiable après coup. Enfin, une restauration réintroduit silencieusement des comptes retirés, faute de métadonnées de propriété et d’expiration conservées avec la sauvegarde.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Les logiciels utilisent des identités pour se connecter à des services, lire des données ou lancer des actions. Chaque identité doit être enregistrée avec son nom, son usage, la personne responsable côté métier, la personne responsable côté technique, les droits accordés et une date de fin. Les informations viennent de plusieurs systèmes, car un compte peut exister dans un annuaire, une plateforme en ligne ou un outil de déploiement.
À intervalles réguliers, les responsables reçoivent la liste des identités dont ils ont la charge. Ils vérifient que le logiciel existe encore, qu’il utilise réellement les droits affichés et que ces droits restent nécessaires. Une identité sans activité ou sans responsable est suspendue, puis retirée après vérification de ses dépendances.
Les mots de passe et jetons utilisés par les logiciels doivent être remplacés automatiquement. Le nouveau secret est d’abord rendu disponible, les logiciels l’utilisent, puis l’ancien est retiré. Si le remplacement échoue, les connexions échouent aussi : il faut donc surveiller les erreurs et pouvoir revenir temporairement en arrière.
Les agents autonomes demandent plus de restrictions. Ils peuvent choisir des actions à partir de textes ou de données reçues. Ils reçoivent donc peu de droits, gardent une trace de chaque action et demandent une validation humaine avant toute action dangereuse ou impossible à annuler.
À lire aussi
- Comment auditer les comptes orphelins après un départDétecter, désactiver et prouver la suppression des comptes qui survivent au départ de leur titulaire.
- Comment automatiser la recertification des accès sensiblesGuide pratique pour mettre en place une revue d'accès périodique, du premier cycle manuel à la désactivation automatisée des droits non recertifiés.
- Mettre en œuvre les revues d’accès IGA et la SoDGouverner le cycle de vie des identités, les revues d’accès, les modèles RBAC, ABAC et ReBAC, ainsi que la séparation des tâches.
- Comment gouverner les coûts cloud contre un compte compromisLa gouvernance des coûts cloud limite l'impact financier d'un compte compromis en complétant la détection, les identités et la réponse à incident.
Pages voisines
La citent
- Comment auditer les comptes orphelins après un départ
- Auditer les comptes orphelins Active Directory
- Comment bloquer les requêtes côté serveur et la désérialisation
- Culture de sécurité dans une équipe produit
- EBPF pour observabilité et enforcement Linux
- EBPF pour observer et bloquer dans le noyau Linux
- Gestion des secrets applicatifs distribués avec rotation
- Gouvernance d'un data lake et copie des données
- Guide d'hygiène informatique ANSSI en 42 mesures, mode d'emploi
Gouverner les comptes de service et agents autonomes
Elle cite