
Backend Foundry Local expliqué et comparé à LM Studio
Backend Foundry Local expliqué et comparé à LM Studio
Section intitulée « Backend Foundry Local expliqué et comparé à LM Studio »« Foundry » désigne chez Microsoft deux choses qui n’ont pas le même modèle de menace : une plateforme cloud de modèles, et un moteur d’inférence qui tourne sur le poste, Foundry Local. Seul le second se compare à LM Studio, et la comparaison se joue sur le format des modèles, le matériel visé et la façon d’exposer une API (Application Programming Interface) sur la machine. La page décrit le mécanisme, ses angles morts, puis tranche.
→ Lire l’explication complète de la marmotte
Backend Foundry : un nom, deux architectures
Section intitulée « Backend Foundry : un nom, deux architectures »Le mot traîne dans les fichiers de configuration des outils d’agents et des clients de LLM (Large Language Model), généralement sans précision. Il recouvre deux cibles distinctes.
Microsoft Foundry (anciennement Azure AI Foundry, et Azure AI Studio avant cela, le renommage étant une discipline olympique) est la plateforme cloud : un catalogue de modèles hébergés, des déploiements, une facturation à l’usage, une authentification par clé ou par identité Entra ID. Choisir ce backend dans un outil, c’est envoyer les prompts vers un point de terminaison Azure. Les questions à poser sont celles de tout fournisseur hébergé : rétention, région, contrat, gestion des clés.
Foundry Local est un moteur d’inférence exécuté sur la machine. Pas d’abonnement Azure, pas de clé, pas de trafic sortant pendant l’inférence. C’est ce produit que la suite de la page appelle « backend Foundry », parce que c’est lui qui occupe la même case qu’LM Studio.
Deux homonymes sans rapport (la plateforme de données de Palantir, la chaîne d’outils Ethereum forge/anvil) complètent le tableau. Avant toute revue d’architecture, la première question est donc : lequel ? Une ligne backend: foundry dans une configuration ne dit pas si les données restent sur le poste ou partent dans un centre de données. C’est un peu gênant pour une analyse de risque.
Architecture du backend Foundry Local
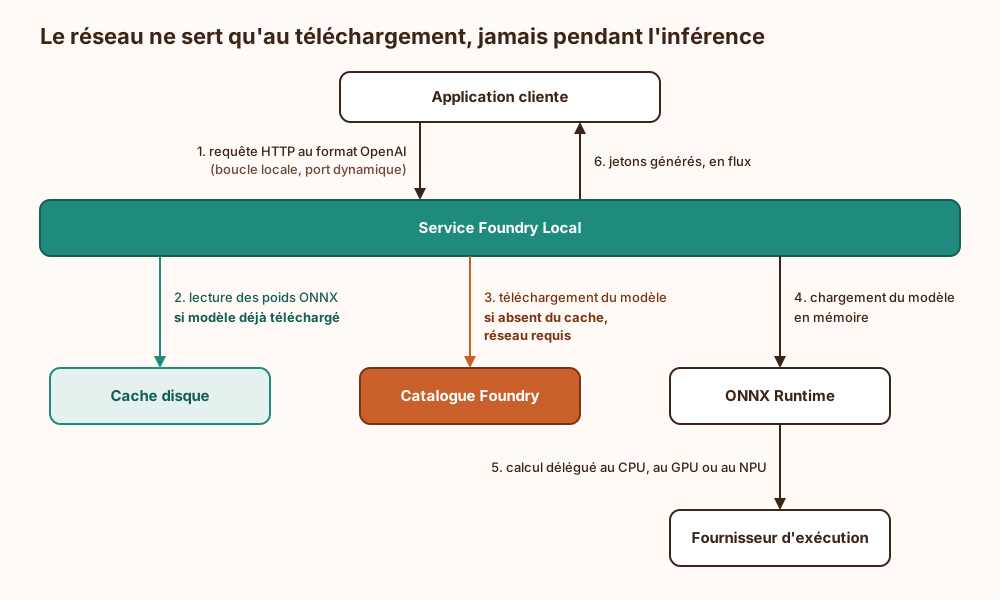
Section intitulée « Architecture du backend Foundry Local »Foundry Local s’articule autour de quatre briques :
- un service local qui expose une API HTTP compatible avec celle d’OpenAI (
/v1/chat/completions,/v1/models) sur l’interface de bouclage ; - ONNX Runtime, le moteur qui exécute des modèles au format ONNX (Open Neural Network Exchange) ;
- des fournisseurs d’exécution (execution providers), les greffons qui traduisent le calcul pour un matériel donné : CPU (Central Processing Unit), GPU (Graphics Processing Unit) via CUDA ou une couche générique, NPU (Neural Processing Unit) Qualcomm, Intel ou AMD ;
- un catalogue et un cache : les modèles sont téléchargés depuis le catalogue Foundry, stockés sur disque, puis chargés en mémoire à la demande.
Le schéma montre le point clé : le réseau n’intervient qu’au téléchargement, jamais pendant l’inférence.
Trois particularités conditionnent l’intégration.
L’alias n’est pas un modèle. Demander phi-4-mini ne désigne pas un fichier : le service résout l’alias vers la variante jugée la meilleure pour le matériel détecté (CPU, GPU, NPU), avec une quantification différente selon le cas. Deux postes d’un même parc exécutent donc, sous le même alias, deux artefacts distincts, aux sorties distinctes. C’est commode pour déployer, pénible pour reproduire un comportement.
Le port est dynamique. Le service choisit son port au démarrage. Le coder en dur dans un client finit en ticket de support. Le SDK (Software Development Kit) fourni sert précisément à découvrir le point de terminaison et l’identifiant exact du modèle chargé.
Le catalogue est fermé. Seuls les modèles convertis et optimisés en ONNX y figurent (familles Phi, Qwen, Mistral, DeepSeek, quelques autres). Un modèle hors catalogue doit être converti avec Olive, l’outil d’optimisation de Microsoft, ce qui relève du projet et non du glisser-déposer.
Prérequis de plateforme
Section intitulée « Prérequis de plateforme »Windows 10/11 (x64 ou ARM) ou macOS sur Apple silicon dans les versions initiales ; la prise en charge d’autres systèmes et le statut (préversion ou version stable) évoluent d’une livraison à l’autre et se vérifient sur la version installée. Compter 8 Go de mémoire vive au minimum et 16 Go pour travailler confortablement, plus quelques gigaoctets de disque par modèle. Les pilotes GPU ou NPU doivent être à jour : un fournisseur d’exécution qui ne se charge pas provoque un repli silencieux sur CPU, et le symptôme visible est « le modèle est lent », pas une erreur. Le premier lancement exige un accès réseau au catalogue (et, sur Windows, au téléchargement de certains fournisseurs d’exécution) ; le dimensionnement se raisonne comme pour tout moteur local, voir dimensionner le matériel d’inférence.
Foundry Local face à LM Studio : ce qui diffère vraiment
Section intitulée « Foundry Local face à LM Studio : ce qui diffère vraiment »LM Studio est une application de bureau propriétaire, pensée d’abord autour de son interface graphique. Ses moteurs sont llama.cpp, qui lit le format GGUF (GPT-Generated Unified Format), et MLX, le cadre de calcul d’Apple pour ses puces. Elle embarque aussi un serveur compatible OpenAI (port 1234 par défaut) et une CLI (Command Line Interface), lms. Le détail du produit est traité dans la page dédiée à LM Studio sur poste de travail.
| Critère | Foundry Local | LM Studio |
|---|---|---|
| Format des modèles | ONNX | GGUF, MLX |
| Moteur | ONNX Runtime | llama.cpp, MLX |
| Source des modèles | Catalogue Foundry, fermé et préoptimisé | Hugging Face, ouvert |
| Choix de la variante | Automatique selon le matériel | Manuel (fichier et quantification choisis) |
| NPU | Oui, via fournisseurs d’exécution dédiés | Non visé |
| Forme du produit | Service et CLI, conçu pour être embarqué | Application graphique, serveur en option |
| Port de l’API | Dynamique | 1234 par défaut |
| Déploiement de parc | winget, donc gestionnaire de parc Windows | Installeur de bureau |
| Continuité vers le cloud | Même forme d’API que Microsoft Foundry | Aucune offre hébergée associée |
Le compromis central tient en une phrase. Foundry Local échange la liberté contre la prévisibilité du déploiement : catalogue restreint et format unique, en contrepartie d’une sélection automatique du matériel et d’une installation scriptable. LM Studio fait l’échange inverse : n’importe quel modèle publié en GGUF le matin est testable l’après-midi, mais le choix du fichier, de la quantification et des couches déportées sur GPU repose sur la personne devant l’écran. Sur les formats eux-mêmes, voir le comparatif des formats de quantification.
La recommandation en découle :
- Embarquer de l’inférence dans une application distribuée sur un parc Windows hétérogène, notamment avec des NPU : Foundry Local. C’est le seul des deux qui traite la diversité matérielle comme son problème.
- Explorer, comparer, évaluer des modèles sur un poste : LM Studio. Le catalogue fermé de Foundry Local devient un mur dès que le modèle voulu n’y est pas.
- Servir plusieurs utilisateurs depuis une machine partagée : aucun des deux. Ce sont des moteurs de poste, sans gestion d’identités, sans quotas, sans journal d’audit. Ce besoin relève d’un serveur d’inférence placé derrière une passerelle d’API.
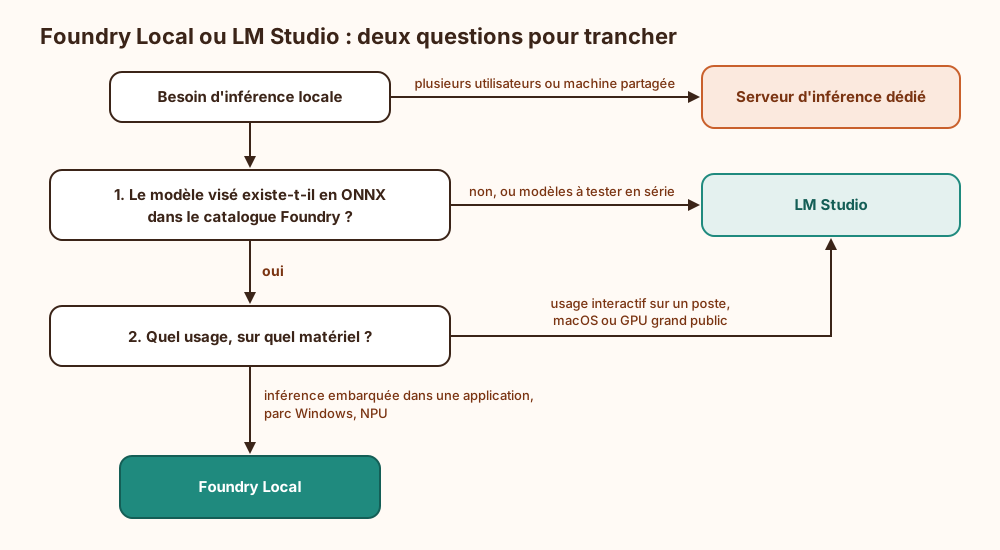
L’arbre se lit de haut en bas : la disponibilité du modèle élimine d’abord, l’usage (embarqué ou interactif) décide ensuite.
Surface d’attaque d’un backend d’inférence local
Section intitulée « Surface d’attaque d’un backend d’inférence local »Les deux produits partagent le même défaut de naissance : une API HTTP sans authentification par défaut, à l’écoute sur la boucle locale. Le mot « local » rassure beaucoup, et protège peu.
Tout processus local est un client légitime. N’importe quel programme exécuté sous n’importe quel compte de la machine peut interroger le service, charger un modèle, saturer la mémoire. Sur un poste mono-utilisateur, le risque est faible ; sur une machine multi-utilisateur ou un hôte de sessions distantes, c’est un service partagé sans contrôle d’accès.
Le navigateur est un pont vers localhost. Une page web malveillante peut tenter d’atteindre le service, soit directement si la politique CORS (Cross-Origin Resource Sharing) du serveur est permissive, soit par réassociation DNS (Domain Name System), qui fait passer une origine distante pour l’adresse locale. Contre-mesures : laisser l’option CORS désactivée quand aucun client navigateur n’en a besoin, et vérifier que le serveur contrôle l’en-tête Host.
L’écoute sur le réseau local se décide en un clic. LM Studio propose une option d’exposition sur le réseau ; le service écoute alors sur toutes les interfaces. Sans jeton d’accès ni pare-feu, tout le segment réseau dispose d’un modèle gratuit et d’un vecteur d’épuisement de ressources. Les versions récentes de LM Studio proposent une authentification par jeton, à activer dès que l’écoute quitte la boucle locale ; à défaut, un proxy inverse avec authentification devant le port.
Le modèle est un artefact exécutable, pas une donnée inerte. Un fichier GGUF embarque un gabarit de conversation interprété au chargement, et l’analyse de fichiers de poids a un historique de défauts mémoire dans les moteurs natifs ; un graphe ONNX décrit des opérations que le moteur exécute. Le catalogue fermé de Foundry réduit ce risque par construction ; la bibliothèque ouverte de LM Studio le déplace vers la personne qui clique sur « télécharger ». Dans les deux cas, la règle est d’épingler une version précise, de vérifier une empreinte et de tenir un inventaire, comme l’expose le poids du modèle comme artefact.
Les outils branchés au modèle héritent de ses faiblesses. Dès qu’un client relie le backend à des fonctions (lecture de fichiers, appels réseau), une injection de prompt dans un document devient une exécution d’action. Le backend n’y est pour rien et n’y peut rien : la validation se fait côté appelant.
Ce que l’inférence locale ne garantit pas
Section intitulée « Ce que l’inférence locale ne garantit pas »- La confidentialité de bout en bout. Le moteur ne transmet pas les prompts pendant l’inférence, mais le client qui l’appelle peut le faire, l’historique des conversations est stocké en clair sur disque, et la télémétrie de chaque produit se vérifie dans sa configuration, pas dans sa plaquette. Le raisonnement complet figure dans modèle local et confidentialité.
- Le fonctionnement hors ligne dès l’installation. Tant que le cache est vide, il faut le réseau. Un environnement isolé exige un cache préalimenté et transporté.
- La reproductibilité entre machines. Avec la résolution d’alias de Foundry Local, le même appel donne des sorties différentes selon le matériel. Toute évaluation doit noter l’identifiant exact de la variante, pas l’alias.
- La qualité du modèle. Une variante quantifiée pour tenir sur un NPU n’a pas le comportement du modèle d’origine. La compatibilité d’API masque cet écart au lieu de le signaler.
- L’isolation, la traçabilité et les quotas. Rien de tout cela n’existe dans le moteur ; ces fonctions viennent du système d’exploitation, d’un proxy ou de l’application.
Exemple : interroger Foundry Local puis LM Studio avec le même client
Section intitulée « Exemple : interroger Foundry Local puis LM Studio avec le même client »L’exemple montre la seule différence d’intégration qui compte : la découverte du point de terminaison et de l’identifiant du modèle.
# Installation sur Windows (macOS : brew tap microsoft/foundrylocal && brew install foundrylocal)winget install Microsoft.FoundryLocal
# Catalogue disponible pour ce matériel, puis téléchargement et chargement par aliasfoundry model listfoundry model download phi-4-minifoundry model load phi-4-mini
# Le port est dynamique : l'URL du service se lit ici, jamais dans une documentationfoundry service status
# Valeur relevée dans la sortie de la commande précédenteexport FOUNDRY_URL="http://127.0.0.1:5273"
# L'API attend l'identifiant complet de la variante, pas l'alias : il se lit icicurl -s "$FOUNDRY_URL/v1/models"
# Appel au format OpenAI, avec l'identifiant renvoyé par /v1/modelscurl -s "$FOUNDRY_URL/v1/chat/completions" \  -H "Content-Type: application/json" \  -d '{        "model": "Phi-4-mini-instruct-generic-cpu",        "messages": [{"role": "user", "content": "Expliquer AES-GCM en deux phrases."}],        "max_tokens": 120      }'
Côté LM Studio, la même requête part vers un port fixe, après démarrage du serveur en ligne de commande :
# Démarrage du serveur local (port 1234 par défaut) et liste des modèles chargéslms server startcurl -s http://127.0.0.1:1234/v1/modelsLe corps de la requête chat/completions est identique ; seuls changent l’URL et le nom du modèle. C’est l’intérêt réel de la compatibilité OpenAI : le client ne sait pas quel moteur répond. C’est aussi sa limite, puisque le client ne sait pas non plus quelle quantification répond.
Exploitation : cache, versions et supervision des deux backends
Section intitulée « Exploitation : cache, versions et supervision des deux backends »Secrets. Aucun en fonctionnement local par défaut : la clé d’API attendue par les clients OpenAI est une valeur factice. Cela change dès qu’un jeton d’accès est activé (LM Studio en écoute réseau) ou qu’un proxy authentifié est placé devant ; ce jeton se gère alors comme n’importe quel secret applicatif, rotation comprise.
Versions. Trois objets évoluent séparément : l’application, les moteurs ou fournisseurs d’exécution, les modèles. Une mise à jour du moteur change les performances et parfois les sorties à modèle constant. Pour un usage embarqué, figer les trois et qualifier les montées de version ; laisser les mises à jour automatiques sur un poste d’exploration seulement.
Cache. Les poids occupent plusieurs gigaoctets par modèle et s’accumulent sans bruit. foundry cache list et foundry cache location côté Foundry Local, lms ls côté LM Studio donnent l’état réel. Le cache ne se sauvegarde pas, il se reconstruit ; ce qui se conserve, c’est la liste des identifiants exacts et leurs empreintes. En environnement isolé, cette reconstruction suppose une copie interne des poids, à prévoir avant le jour où le réseau manque.
Supervision. Trois signaux suffisent : l’état du service (foundry service status, lms status), la mémoire consommée par les modèles chargés, et le fournisseur d’exécution effectivement utilisé. Ce dernier est le plus négligé : un repli sur CPU après une mise à jour de pilote multiplie les temps de réponse sans lever d’erreur. Une requête témoin chronométrée au démarrage détecte ce cas mieux que n’importe quel tableau de bord.
Reprise. Un service local qui tombe ne prévient personne. L’application cliente doit traiter l’indisponibilité du point de terminaison comme un cas nominal : redécouverte du port côté Foundry Local, délai d’attente court, message explicite plutôt qu’un sablier éternel.
Foundry Local nécessite-t-il un compte Azure ?
Section intitulée « Foundry Local nécessite-t-il un compte Azure ? »Non. L’inférence locale fonctionne sans abonnement ni authentification. Le compte Azure concerne Microsoft Foundry, la plateforme cloud, qui partage le nom et la forme d’API mais pas le lieu d’exécution.
Un modèle GGUF peut-il tourner dans Foundry Local ?
Section intitulée « Un modèle GGUF peut-il tourner dans Foundry Local ? »Pas directement. Foundry Local exécute de l’ONNX ; un modèle hors catalogue doit être converti et optimisé avec Olive à partir des poids d’origine. Si le besoin est de lancer un GGUF existant, LM Studio ou un autre moteur fondé sur llama.cpp (voir déployer Ollama sur un poste) répond sans conversion.
Peut-on exposer l’un ou l’autre comme serveur d’équipe ?
Section intitulée « Peut-on exposer l’un ou l’autre comme serveur d’équipe ? »Techniquement oui, raisonnablement non. Aucun des deux ne gère d’identités, de quotas par appelant ni de journal d’audit. L’exposition réseau sans proxy authentifié revient à publier un service de calcul anonyme sur le segment.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans backend local choisi et cadré, l’inférence ne disparaît pas : elle se disperse. Chaque application embarque son propre moteur et ses propres poids, plusieurs fois les mêmes gigaoctets sur le même disque, sans inventaire de ce qui s’exécute. Les prompts que l’on voulait garder sur le poste repartent vers une API hébergée dès qu’un outil ne trouve pas de point de terminaison local, sans que personne l’ait décidé. Faute d’identifiant de variante consigné, un écart de comportement entre deux machines devient impossible à attribuer au modèle, au moteur ou au matériel. Et un port ouvert sur le réseau par commodité reste ouvert, puisque rien ne recense les services d’inférence du parc.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Le mot Foundry désigne deux produits de Microsoft. Le premier fait tourner des intelligences artificielles sur des ordinateurs distants : les questions posées y sont envoyées par Internet. Le second, Foundry Local, les fait tourner sur l’ordinateur de l’utilisateur. LM Studio fait la même chose que ce second produit, autrement.
Dans les deux cas, le logiciel télécharge d’abord un gros fichier qui contient l’intelligence artificielle. Cette étape demande Internet. Ensuite, il charge ce fichier en mémoire et attend des questions. Un autre programme de la même machine lui envoie un texte, et il répond mot après mot, sans connexion.
Foundry Local choisit seul la version du fichier qui convient aux composants de l’ordinateur, parmi une liste limitée. LM Studio laisse choisir n’importe quel fichier publié, à la main.
Plusieurs choses peuvent mal tourner. Tout programme de la machine peut poser des questions au logiciel, car celui-ci ne demande aucun mot de passe. Si on l’ouvre au réseau, les ordinateurs voisins le peuvent aussi. Un fichier téléchargé depuis une source douteuse peut être piégé. Enfin, si le composant rapide de l’ordinateur n’est pas reconnu, tout fonctionne encore, mais très lentement, sans message d’erreur.
À lire aussi
- Fenêtre de contexte et mémoire d’un LLM localChoisir, dimensionner et exploiter la fenêtre de contexte d’un LLM local sans sacrifier inutilement la performance, la sécurité ou la continuité des conversations.
- Calculer le coût d’un LLM local à grande échelleMéthode de dimensionnement et d’optimisation économique d’un déploiement local de modèles de langage à grande échelle.
- Relier FinOps et MLOps pour piloter le coût de l'IA en productionComment articuler FinOps et MLOps en IA pour attribuer, plafonner et contrôler le coût d'un modèle de l'entraînement à l'inférence, avec la surface d'attaque et les limites de l'approche.
- Fine-tuning local ou RAG pour données internesComparer le fine-tuning local et le RAG pour exploiter des données internes sans augmenter inutilement le risque de fuite.
Pages voisines
La citent
Backend Foundry Local expliqué et comparé à LM Studio
Elle cite
- Lien dans les deux sens :LM Studio utilité, éditeur et limites sur poste de travail
- Comparer GGUF GPTQ et AWQ pour LLM local
- Déployer Ollama sur un poste de travail et dimensionner la mémoire
- Dimensionner GPU et RAM pour un LLM local
- Comment fonctionne l'inférence d'un modèle de langage
- Comment valider le function calling d’un LLM
- Faire tourner un modèle chez soi
- Les poids d'un modèle sont un artefact logiciel
- Sécuriser la télémétrie et les données d’usage produit
- Sécuriser une API gateway comme point de contrôle
: les deux pages se citent l’une l’autre.