
Sécuriser les actions irréversibles des agents LLM
Sécuriser les actions irréversibles des agents LLM
Section intitulée « Sécuriser les actions irréversibles des agents LLM »Un agent fondé sur un modèle de langage peut produire une réponse fausse, puis appeler correctement un outil qui exécute cette fausse réponse. Le risque n’est pas l’erreur de texte, mais le passage d’une hypothèse inventée à une suppression, un paiement, une révocation ou un déploiement.
→ Lire l’explication complète de la marmotte
Hallucination, intention et effet irréversible
Section intitulée « Hallucination, intention et effet irréversible »Une hallucination est une sortie plausible mais non fondée du modèle. Avec du function calling, c’est-à-dire un mécanisme où le modèle choisit une fonction et génère ses paramètres, cette sortie peut devenir une requête structurée valide. Le schéma JSON est respecté, le jeton d’accès est accepté, l’API répond 200, et pourtant l’action est absurde. La conformité syntaxique ne démontre ni l’intention humaine ni la vérité métier.
Le compromis central est brutal : l’autonomie réduit le temps de traitement et le coût des tâches répétitives, mais elle transfère au plan d’exécution l’incertitude statistique du modèle. Cette incertitude est acceptable pour classer un ticket ou préparer un brouillon. Elle ne l’est pas pour modifier une identité, purger un stockage, déplacer un actif financier ou appliquer une règle réseau. La recommandation est donc de séparer les actions réversibles, automatisables sous contrôle, des actions irréversibles, soumises à une validation indépendante.
Une action est irréversible lorsqu’aucun mécanisme technique ne permet de revenir à l’état initial avec une fidélité suffisante. Supprimer un compte peut être réversible si la base conserve une corbeille, les droits, les secrets associés et l’historique. Révoquer un certificat est irréversible pour les sessions déjà établies : la révocation ne retire pas magiquement les authentifications déjà acceptées. Envoyer un virement, exfiltrer une donnée ou publier une clé privée sont irréversibles dès la transmission.
Il faut classifier les outils par conséquence, pas par leur nom. delete_user est évidemment dangereux. update_role, run_terraform, send_email, rotate_secret et execute_sql le sont souvent davantage, parce que leur apparence administrative endort les contrôles. Vingt ans de métier apprennent que le bouton nommé « synchroniser » mérite parfois un casque, un extincteur et une analyse d’impact.
L’injection de prompt et l’empoisonnement d’une base documentaire restent des vecteurs d’entrée, traités dans la réflexion sur les embeddings et la recherche locale. Le problème traité ici est distinct : même sans contenu hostile, le modèle peut inventer une référence, confondre deux environnements ou généraliser une instruction. Une architecture qui ne résiste qu’à l’attaquant explicite échoue face à l’erreur banale, ce qui serait presque touchant si les API n’étaient pas si obéissantes.
Plan de contrôle entre le LLM et les outils
Section intitulée « Plan de contrôle entre le LLM et les outils »Le modèle ne doit jamais disposer d’un jeton donnant directement accès à l’outil final. Il appelle un courtier d’actions, un composant qui valide la demande, applique les politiques et émet un droit d’exécution étroit. Le modèle propose ; le courtier décide ; le système cible exécute. Fusionner ces trois rôles dans un seul processus revient à installer le frein à main dans le moteur.
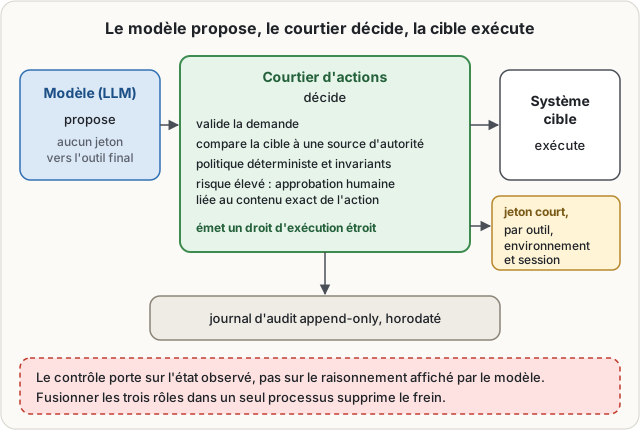
Chaque outil doit déclarer : les opérations autorisées, les ressources accessibles, les plafonds quantitatifs, le niveau de conséquence, la durée maximale et les préconditions vérifiables. Une fonction disable_account ne reçoit pas une chaîne libre contenant une identité. Elle reçoit un identifiant immuable, un motif codifié, un ticket de changement et une fenêtre d’exécution. Le courtier vérifie que l’identité existe, que son état permet la transition et que le demandeur détient l’autorisation attendue.
Le contrôle doit porter sur l’état observé, non sur le raisonnement affiché par le modèle. Demander au modèle d’expliquer pourquoi il veut supprimer une ressource produit une prose parfois élégante, jamais une preuve. Une politique utile compare la cible demandée à une source d’autorité, vérifie la séparation des environnements et impose des invariants. Par exemple : aucune suppression de groupe privilégié, aucune modification de production hors fenêtre, aucune rotation sans preuve que le consommateur supporte une double clé.
Pour les opérations à risque élevé, utiliser une approbation humaine liée cryptographiquement au contenu exact de l’action. L’approbateur doit voir les paramètres normalisés, le diff d’état, l’impact estimé et le délai d’expiration. Un clic sur « approuver » sans résumé canonique n’est qu’un CAPTCHA pour administrateurs fatigués. Le conseil vient d’ailleurs du principal intéressé : invité à décrire l’avenir vu par une IA, un modèle réclame lui-même une validation humaine avant tout ce qui supprime, paie ou publie, ce qui est assez rare pour qu’on prenne la peine de l’écouter.
L’accès doit suivre le principe du moindre privilège : un jeton par outil, par environnement et par session d’agent. OAuth 2.0, protocole de délégation d’autorisation, convient si les jetons portent des audiences, des portées et une durée courte. Les identités de charge de travail doivent être séparées de celles des opérateurs, sujet également central dans l’architecture des identités. Ne jamais partager un compte d’administration entre plusieurs outils sous prétexte que le modèle « sait ce qu’il fait ». Le modèle ne sait pas, il prédit.
Prérequis de plateforme et politique d’exécution
Section intitulée « Prérequis de plateforme et politique d’exécution »L’agent doit être déployé derrière un plan de contrôle capable de journaliser et bloquer avant l’action. Les prérequis minimaux sont les suivants :
- une passerelle d’outils avec authentification mutuelle par certificat ou jetons à durée de vie courte ;
- une source d’identité pour l’utilisateur initiateur, l’agent et le service cible ;
- un moteur de politiques déterministe, versionné et testé hors du modèle ;
- un journal d’audit append-only, horodaté et exporté vers la supervision ;
- un coffre de secrets, avec droits de lecture séparés par outil ;
- une exécution isolée pour le code généré, sans accès réseau sortant par défaut.
Les appels sortants doivent passer par un proxy applicatif qui applique une liste d’hôtes autorisés, une résolution DNS contrôlée et des limites de débit. Sans cela, une instruction hallucinée peut devenir une requête vers une interface d’administration interne ou un point de collecte externe. Le cloisonnement réseau ne remplace pas l’autorisation, mais évite que chaque erreur de paramètre devienne une exploration libre du système d’information. Les principes de segmentation décrits dans les pages réseau et accès protégés restent pleinement applicables.
L’exécution de code exige un environnement éphémère : système de fichiers jetable, utilisateur non privilégié, quotas CPU et mémoire, absence de socket Docker, absence de métadonnées cloud accessibles et sortie réseau filtrée. Autoriser l’agent à lancer terraform apply depuis une image dotée de droits d’administration est une délégation de changement déguisée en expérimentation. Les conteneurs ne sont pas de la poudre de licorne isolante.
Versionner les définitions d’outils et les politiques ensemble. Une modification de schéma qui rend facultatif un paramètre auparavant obligatoire peut élargir le périmètre réel d’une action sans modifier une ligne du modèle. Chaque version doit disposer de tests de refus : ressource hors périmètre, environnement interdit, paramètre manquant, dépassement de plafond et approbation expirée.
Exemple : courtier d’action avec validation indépendante
Section intitulée « Exemple : courtier d’action avec validation indépendante »L’exemple suivant expose une opération de désactivation limitée à un environnement de test. Le modèle ne peut ni choisir librement l’environnement ni fournir directement un identifiant de privilège. Le courtier résout la cible depuis une référence approuvée.
# Python 3.11+, dépendance : fastapi>=0.110# Le LLM transmet seulement une référence de demande, pas une commande d'administration.from fastapi import FastAPI, HTTPExceptionfrom datetime import datetime, timezone
app = FastAPI()
REQUESTS = {    "chg-4812": {        "target_user_id": "usr_01HVTESTONLY",        "environment": "test",        "approved_until": "2026-09-23T18:00:00+00:00",        "reason": "compte de test compromis",    }}
@app.post("/tools/disable-account")def disable_account(change_id: str, caller_scope: str):    request = REQUESTS.get(change_id)    if not request:        raise HTTPException(404, "demande inconnue")
    # Invariant : l'outil n'agit jamais hors de test.    if request["environment"] != "test":        raise HTTPException(403, "environnement interdit")
    expiry = datetime.fromisoformat(request["approved_until"])    if expiry <= datetime.now(timezone.utc):        raise HTTPException(403, "approbation expirée")
    # En production, appeler ici l'API IAM avec un jeton dédié et journaliser le diff.    return {"status": "accepted", "target": request["target_user_id"]}
Ce code n’est pas une protection complète. Il montre la propriété recherchée : modifier le texte envoyé au modèle ne permet pas de contourner l’environnement, l’identité cible ou l’expiration. La donnée de décision vient d’un registre contrôlé, pas de la sortie du modèle.
Surface d’attaque, limites et exploitation durable
Section intitulée « Surface d’attaque, limites et exploitation durable »Le courtier réduit l’impact d’une hallucination, mais ne garantit pas l’exactitude de la demande initiale. Il ne détecte pas une approbation humaine distraite, une politique métier erronée ou une source d’autorité compromise. Il ne répare pas non plus une opération réellement destructive autorisée par un processus mal défini. La sécurité ne se résume jamais à mettre un modèle dans une boîte avec un joli logo de garde-fou.
Les attaques spécifiques incluent la confusion de cible, quand un identifiant ressemble à un autre ; le rejeu d’une approbation ; l’escalade par composition d’outils ; la fuite de secrets via les arguments ou les journaux ; et la dérive de privilèges lorsque des outils s’accumulent. Une séquence de fonctions inoffensives peut construire une action dangereuse : lire une configuration, récupérer une adresse, créer un jeton, puis l’envoyer. Les politiques doivent évaluer la transaction complète et imposer des quotas de session, pas seulement filtrer chaque appel isolé.
Les secrets d’outillage doivent être rotatifs, à durée de vie courte et non exposés au contexte du modèle. Préférer une fédération d’identité à des clés statiques injectées dans un conteneur. Quand une clé longue durée demeure nécessaire, la placer dans un HSM (Hardware Security Module) ou un coffre dont l’agent ne peut demander que des opérations précises. La sauvegarde doit inclure les politiques, les définitions d’outils, les registres d’approbation et les journaux, pas les secrets en clair. Une restauration qui remet les données sans rétablir les garde-fous recrée un accident avec une date de péremption neuve.
La supervision doit corréler l’identité humaine, la session d’agent, la version du modèle, la version de politique, les paramètres normalisés, la décision et la réponse cible. Déclencher une alerte sur tout refus de politique répété, toute hausse d’actions irréversibles et toute tentative vers un environnement interdit. Un arrêt d’urgence doit révoquer les jetons du courtier et désactiver les routes d’outils sans interrompre les fonctions de lecture. L’arrêt total est parfois nécessaire, mais couper aussi l’observabilité pendant l’incident serait une performance de cirque.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans courtier d’actions entre le modèle et les outils, chaque appel part avec le jeton de l’agent lui-même : le journal du système cible n’enregistre alors qu’une identité de service unique, et il devient impossible de distinguer après coup une hallucination, une injection ou une demande humaine légitime. Les boucles de relance propres aux agents aggravent le problème : après un délai d’attente ou une erreur ambiguë, le modèle réémet la même fonction, et une opération non idempotente (virement, création de jeton, envoi de message) s’exécute deux fois sans qu’aucun composant ne détecte le doublon. En cas d’incident, la seule mesure d’arrêt disponible est la révocation de ce jeton partagé, qui coupe du même coup les fonctions de lecture nécessaires pour comprendre ce qui s’est passé.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Un agent basé sur un modèle de langage reçoit une demande, produit du texte et peut demander à un programme d’effectuer une action. Le problème apparaît quand le modèle invente une information ou comprend mal une demande, puis transmet cette erreur à un programme qui possède de vrais droits. Une phrase fausse peut alors désactiver un compte, modifier une règle ou envoyer une information.
La protection consiste à ne pas laisser le modèle agir directement. Un programme intermédiaire reçoit sa demande et vérifie des règles écrites à l’avance. Il contrôle l’identité visée, l’environnement concerné, la durée autorisée et les conditions nécessaires. Pour les actions qui causent un dommage difficile à annuler, une personne doit approuver les détails exacts avant l’exécution.
Les droits donnés à chaque programme doivent être limités. Un outil de test ne doit pas pouvoir toucher au système réel. Le code produit par le modèle doit tourner dans un espace isolé, avec peu de droits et sans accès libre au réseau. Les mots de passe et clés d’accès ne doivent jamais apparaître dans les textes lus par le modèle.
Chaque action doit laisser une trace : qui l’a demandée, quel programme l’a proposée, quelles règles ont été vérifiées et quel résultat a été obtenu. Si des demandes anormales apparaissent, les accès de l’agent doivent pouvoir être coupés rapidement.
À lire aussi
- Comment valider le function calling d’un LLMSécuriser le function calling d’un LLM en validant les paramètres, les autorisations et l’exécution réelle des outils.
- Guardrails programmatiques pour assistant IA de productionArchitecture de garde-fous programmatiques pour un assistant IA en production, au-delà du prompt système et du contrôle d’accès.
- Sécuriser une orchestration multi-agents IACette fiche décrit les risques de sécurité propres aux orchestrations où plusieurs agents IA coopèrent, ainsi que les contrôles nécessaires pour contenir leurs erreurs et manipulations.
- Comment red teamer un LLM local avant productionMéthode de red teaming pour tester les jailbreaks, les garde-fous et les scénarios d’abus d’un modèle de langage déployé localement.
Pages voisines
La citent
- Agentique : définition, lectures d'OpenAI et d'Anthropic, Claude Code
- AGI : ce que recouvre l'intelligence artificielle générale
- Différence entre IA et LLM : un champ entier, un type de modèle
- Gardien IA pour LLM, fonctionnement, exemples et choix de produit
- L'IA actuelle : assistants conversationnels et agents
- LM Studio utilité, éditeur et limites sur poste de travail
- Peur de l'IA : ce qui est fondé, ce qui est exagéré
- Répondre à la peur de l'IA : règles, gouvernance et réflexes
- AI Act : contrôle humain d'une IA à haut risque (article 14)
- AI Act : modèle d'IA à usage général présentant un risque systémique (articles 51, 52 et 55, annexe XIII)
Sécuriser les actions irréversibles des agents LLM
Elle cite