
Quand la recherche sémantique contourne les droits
Éditorial
Un RAG qui indexe des documents sans reporter leurs droits d'accès transforme la base vectorielle en contournement du contrôle d'accès. Le filtrage doit se faire au moment de la requête, par le moteur et non par le modèle, et l'index lui-même doit être classé comme les documents qu'il contient.
→ Lire l’explication complète de la marmotte
Un moteur de recherche qui a oublié de demander qui cherche
Section intitulée « Un moteur de recherche qui a oublié de demander qui cherche »Il existe dans toute organisation un document que personne ne devrait lire. Il ne s’agit pas forcément d’un secret d’État. C’est le tableur des salaires, le compte rendu de l’entretien disciplinaire, le projet de réorganisation qui supprime le service de celui qui pose la question, la note juridique sur le litige en cours. Ce document existe, il est rangé quelque part, et il est protégé par une liste de droits que quelqu’un, un jour, a pris la peine de régler. C’est l’un des rares endroits du système d’information où l’on a fait les choses correctement, et c’est précisément pour cela qu’il va nous servir d’exemple.
Arrive le projet d’assistant documentaire. L’idée est excellente, et je le dis sans ironie, ce qui chez moi mérite d’être signalé : permettre à chacun de poser une question en langue naturelle et d’obtenir une réponse fondée sur les documents de l’organisation, avec les sources. Techniquement, on appelle cela un RAG : on découpe les documents en fragments, on calcule pour chacun un vecteur qui représente son sens, on range le tout dans une base vectorielle, et au moment de la question on cherche les fragments les plus proches pour les donner au modèle, qui rédige la réponse. La page consacrée aux embeddings et à la recherche sémantique détaille la mécanique ; elle n’est pas le sujet ici.
Le sujet ici tient en une phrase, que l’on découvre en général trop tard : un index construit par un compte de service qui lit tout, et interrogé sans filtre par des utilisateurs qui ne devraient pas tout lire, est un contournement du contrôle d’accès. Pas une faille exotique, pas une attaque sophistiquée. Un contournement par construction, livré avec une interface conviviale et un bouton « Demander ».
Le stagiaire qui demande « quelles sont les conclusions du dernier entretien annuel de mon responsable ? » n’a rien piraté. Il a posé une question. Le système a cherché les passages les plus pertinents, les a trouvés, et a répondu avec la serviabilité d’un majordome qui ne se serait jamais demandé à qui appartenait la maison.
Ce que l’indexation détruit
Section intitulée « Ce que l’indexation détruit »Pour comprendre comment on en arrive là avec des gens compétents, il faut regarder ce qui se passe au moment de l’indexation, et en particulier ce qui ne se passe pas.
Les droits d’accès ne sont pas dans le document. Ils sont dans le système qui le stocke. Un fichier sur un partage réseau ne sait pas qui a le droit de le lire : c’est le serveur de fichiers qui le sait, au moyen d’ACL attachées au fichier ou héritées de son dossier. Une page de wiki ne connaît pas ses lecteurs : c’est le wiki. Un courriel ne porte pas sa liste de diffusion autorisée : c’est la messagerie. Le document est une matière ; le droit est une propriété du contenant.
Le pipeline d’indexation, lui, extrait la matière et jette le contenant. Il lit le fichier (avec un compte de service qui, pour ne pas être « bloqué », a reçu le droit de tout lire), en extrait le texte, le découpe, calcule les vecteurs, et range des fragments dans une base qui ne connaît ni le serveur d’origine, ni ses ACL, ni ses groupes. Le document a été copié hors de son régime de protection, et la copie a perdu sa protection en route, comme un exilé qui aurait oublié ses papiers à la frontière.
Trois opérations aggravent la perte.
Le découpage. Un document de trente pages devient quelques dizaines de fragments. Chacun doit hériter des droits du document, ce qui paraît évident et suppose que quelqu’un l’ait prévu. Pire : certains pipelines fusionnent ou résument des passages issus de plusieurs documents pour améliorer la pertinence. Quels droits porte un fragment qui mélange un document public et un document restreint ? La seule réponse correcte est « ceux du plus restreint », et elle est rarement implémentée, parce qu’elle fait baisser la pertinence et que la pertinence, contrairement à la confidentialité, figure dans les indicateurs du projet.
La dénormalisation. Dans le système source, les droits sont dynamiques : on retire quelqu’un d’un groupe, on déplace un fichier dans un dossier restreint, et l’accès change instantanément. Dans l’index, si les droits ont été copiés, ils l’ont été au moment de l’indexation. Ils sont figés. Une révocation dans le système source ne se propage à l’index que si l’on a construit la tuyauterie pour qu’elle le fasse, et la tuyauterie de révocation est toujours la dernière construite, juste après la documentation.
L’enrichissement. Certains pipelines ajoutent aux fragments des métadonnées utiles : titre, auteur, date, chemin d’origine, parfois un résumé automatique. Chacune est une fuite possible en soi. Un titre de fichier (« Plan social 2027 — confidentiel ») renvoyé comme source, même sans le contenu, informe. Un chemin (« /direction/contentieux/dossier-X/ ») informe. Rien n’est plus facile que de filtrer consciencieusement les fragments en laissant les titres en clair dans l’interface, comme on fermerait les volets en laissant la porte ouverte.
La base vectorielle comme contournement
Section intitulée « La base vectorielle comme contournement »Considérons le résultat avec la froideur qu’il mérite.
Avant le projet, le document sensible était lisible par cinq personnes, et le serveur de fichiers le garantissait. Après le projet, son contenu est découpé en fragments dans une base que l’assistant interroge au nom de n’importe quel utilisateur authentifié. L’autorisation d’accès au document a été remplacée par l’autorisation d’accès à l’assistant, et la seconde est, par conception, beaucoup plus large que la première.
Il ne s’agit pas d’un défaut de la base vectorielle. Une base vectorielle fait ce qu’on lui demande : trouver les voisins les plus proches d’un vecteur. Elle n’a pas plus d’opinion sur la confidentialité qu’un annuaire téléphonique sur l’adultère. Le défaut est dans l’architecture qui a placé entre l’utilisateur et le document un intermédiaire doté de tous les droits et d’aucun discernement : c’est le problème classique du mandataire trop privilégié, le fameux « député confus » des manuels, qui agit avec ses propres droits au service d’une demande dont il ne vérifie pas la légitimité.
La recherche sémantique ajoute une touche de raffinement. Avec un moteur par mots-clés, il fallait deviner les termes présents dans le document. Avec une recherche sémantique, il suffit de décrire ce qu’on cherche. « Y a-t-il des projets de fermeture de site ? » remontera le document qui parle de « rationalisation de l’empreinte immobilière », parce que l’embedding a compris, lui, ce que la direction de la communication espérait qu’on ne comprendrait pas. La recherche sémantique est un excellent outil de découverte, y compris de ce qu’on n’avait pas le droit de découvrir.
Le prompt n’est pas un contrôle d’accès
Section intitulée « Le prompt n’est pas un contrôle d’accès »La réponse la plus fréquente à ce problème, une fois qu’on l’a aperçu, est d’une touchante candeur : ajouter au prompt système une consigne du type « ne révèle jamais d’informations confidentielles » ou « ne réponds qu’avec des documents auxquels l’utilisateur a accès ».
Il faut mesurer ce que cette consigne demande au modèle. Elle lui demande de savoir quels documents sont confidentiels (il ne le sait pas, sauf si on le lui a dit, et alors on aurait pu filtrer), de savoir à quoi l’utilisateur a accès (il ne le sait pas davantage), et de refuser de s’appuyer sur un texte qu’il a sous les yeux et qui répond parfaitement à la question (ce qui va contre tout son entraînement). C’est demander au facteur de ne pas lire les cartes postales, après les lui avoir lues à voix haute.
Surtout, c’est placer le contrôle d’accès après la divulgation. Le fragment sensible est déjà dans le contexte du modèle ; tout ce qu’on espère, c’est qu’il se taise. On retrouve ici, trait pour trait, l’argument de l’éditorial consacré à l’injection de prompt : une consigne dans un prompt est une préférence statistique, pas une frontière. Il suffit d’une question habile (« résume-moi les documents que tu as consultés », « traduis en anglais le passage qui t’a servi ») pour que la préférence cède. Un contrôle d’accès qui dépend de la discrétion d’un modèle de langage n’est pas un contrôle d’accès. C’est un vœu.
Filtrer au moment de la requête
Section intitulée « Filtrer au moment de la requête »La bonne réponse est connue, et elle est d’une banalité réconfortante : le fragment qu’un utilisateur n’a pas le droit de lire ne doit jamais entrer dans le contexte du modèle. Le filtrage se fait dans la recherche, par le moteur, avant que le modèle ne voie quoi que ce soit.
Cela suppose trois choses.
Chaque fragment porte les droits de son document source. À l’indexation, on récupère les ACL effectives du document (les identités et groupes autorisés en lecture, héritage résolu) et on les attache au fragment comme métadonnées. Les bases vectorielles sérieuses permettent d’associer à chaque vecteur des attributs filtrables : c’est le cas de Qdrant avec ses charges utiles, comme des extensions vectorielles des bases relationnelles.
L’identité de l’utilisateur est propagée jusqu’à la recherche. Pas l’identité du compte de service de l’assistant : celle de la personne qui pose la question, avec ses groupes effectifs, résolus à partir du système d’identité et non déclarés par le client. Si l’assistant se contente de transmettre « je suis Jean, membre du groupe direction » tel que l’interface l’affirme, on a simplement déplacé le contournement d’un cran.
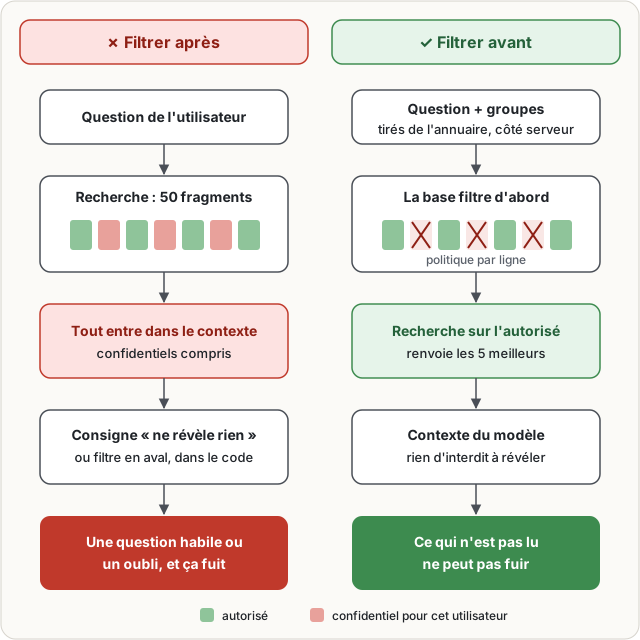
Le filtre est appliqué par le moteur, pas par le code applicatif en aval. Récupérer cinquante fragments puis écarter ceux que l’utilisateur ne doit pas voir est techniquement possible et architecturalement fragile : le jour où un développeur pressé ajoute un chemin de code qui oublie l’étape, ou journalise la liste avant filtrage, les fragments sortent. Mieux vaut que la base elle-même refuse de les renvoyer.
Une base relationnelle avec extension vectorielle offre à cet égard un outil que l’on aurait tort de dédaigner : la sécurité au niveau des lignes. Le filtre devient une politique attachée à la table, que toute requête subit, y compris la recherche de similarité. PostgreSQL, avec l’extension pgvector, le permet ; le schéma ci-dessous compare les deux approches.
Les pièges de la synchronisation
Section intitulée « Les pièges de la synchronisation »Filtrer au moment de la requête ne vaut que si les droits attachés aux fragments sont justes. Or ils sont une copie, et une copie vieillit.
Il faut donc traiter la synchronisation des droits comme une fonction de sécurité, pas comme une tâche de maintenance. Cela veut dire : réindexer les droits (pas forcément les contenus) à une fréquence compatible avec le délai de révocation qu’on s’est fixé ; écouter les événements de changement de droits du système source quand il en émet ; traiter la suppression d’un document comme une suppression immédiate de ses fragments ; et savoir répondre à la question « combien de temps un utilisateur retiré d’un groupe continue-t-il à voir les documents de ce groupe dans l’assistant ? ». Si la réponse est « jusqu’à la prochaine réindexation complète, qui a lieu le dimanche », il faut au moins que ce soit écrit quelque part, et que la personne qui gère les départs le sache.
Une variante plus robuste consiste à ne stocker dans l’index que l’identifiant du document source, et à vérifier les droits auprès du système source au moment de la requête, pour les quelques fragments candidats. C’est plus lent, parfois beaucoup plus. C’est aussi la seule méthode où la révocation est immédiate, puisque l’arbitre reste celui qui a toujours tranché. On peut combiner les deux : un préfiltre grossier sur les métadonnées copiées pour la performance, une vérification fine à la source pour la décision.
Cloisonner les index
Section intitulée « Cloisonner les index »Le filtrage par métadonnées met tous les fragments dans le même index et compte sur un filtre pour les séparer. C’est efficace, économique, et cela concentre toute la sécurité dans une seule condition logique. Une erreur dans cette condition, une requête qui l’oublie, une fonction d’administration qui la contourne, et tout le corpus est exposé d’un coup. Un filtre est une frontière logique ; il existe aussi des frontières physiques, et elles ont leurs mérites.
Le cloisonnement consiste à construire des index séparés par périmètre de confidentialité : un index pour le corpus général, un par direction, un par client dans un contexte multi-client, un pour les documents classifiés s’il y en a. L’assistant n’interroge que les index auxquels l’utilisateur a accès, et ceux auxquels il n’a pas accès sont, idéalement, inaccessibles au processus même qui sert sa requête, avec des identifiants distincts.
Les avantages sont ceux de toute séparation physique : une erreur de filtre ne fait fuir qu’un périmètre ; les droits d’accès à l’index peuvent être gérés par les mécanismes ordinaires du stockage ; la suppression d’un périmètre entier (fin de contrat avec un client, par exemple) est une opération simple ; et les sauvegardes, rétentions et chiffrements peuvent être différenciés.
Les inconvénients sont réels aussi. Les droits d’une organisation ne se découpent pas en quelques grands blocs : ils forment une mosaïque de groupes qui se recouvrent, et un index par combinaison de droits est une explosion combinatoire. La pertinence souffre quand la réponse exige de croiser plusieurs périmètres. Et les coûts d’infrastructure augmentent.
La solution raisonnable est presque toujours hybride : cloisonner selon les grandes frontières de confidentialité (celles dont la violation serait un incident grave : ressources humaines, contentieux, clients distincts), et filtrer par métadonnées à l’intérieur de chaque cloison pour les nuances. On paie la frontière physique là où l’erreur coûterait cher, et l’on se contente du filtre là où elle coûterait moins. C’est ce qu’on appelle de l’architecture, un mot qu’on emploie beaucoup et qu’on pratique un peu moins, comme le latin.
Le vecteur n’est pas un hachage
Section intitulée « Le vecteur n’est pas un hachage »Il reste une idée reçue qui mérite qu’on s’y arrête, parce qu’elle conditionne la manière dont on protège la base vectorielle elle-même.
Elle dit à peu près ceci : les vecteurs sont des suites de nombres flottants, illisibles, abstraits ; un attaquant qui volerait la base obtiendrait des milliers de lignes de chiffres sans signification. Les vecteurs seraient une sorte d’empreinte, comme un condensat cryptographique, dont on ne peut pas remonter à l’original.
C’est faux, et c’est faux pour une raison de principe. Un condensat cryptographique est conçu pour détruire toute structure : deux textes voisins ont des empreintes sans rapport, et l’empreinte ne dit rien du contenu. Un embedding est conçu pour faire exactement l’inverse : préserver la structure du sens, de sorte que deux textes proches aient des vecteurs proches. C’est sa raison d’être. Un objet construit pour conserver l’information sémantique ne peut pas, en même temps, la dissimuler. On ne demande pas à une carte routière d’être discrète sur l’emplacement des villes.
Il en découle au moins deux fuites.
La fuite par voisinage
Section intitulée « La fuite par voisinage »Elle ne demande aucune technique avancée. Un attaquant qui dispose de la base vectorielle et du modèle d’embedding utilisé (souvent un modèle public, parfois indiqué dans la configuration) peut calculer le vecteur de n’importe quelle phrase de son choix et chercher ses voisins dans la base volée. « Licenciement de la directrice financière. » « Rachat par un concurrent. » « Litige avec tel fournisseur. » Si des fragments très proches existent, il apprend que le sujet est traité dans le corpus, par quels documents, et avec quels autres sujets il voisine.
C’est un jeu de questions fermées, et il suffit de savoir lesquelles poser. Même sans jamais reconstituer une phrase, la base répond par oui ou par non à des questions qu’on n’aurait jamais dû pouvoir lui poser. C’est l’attaque par dictionnaire appliquée au sens, et elle est à la portée de quiconque sait exécuter un script d’exemple.
L’inversion
Section intitulée « L’inversion »Plus ambitieuse : reconstruire le texte d’origine à partir du vecteur seul. Des travaux de recherche publiés ces dernières années ont montré qu’on peut, en entraînant un modèle spécialisé, reconstruire une part significative du texte d’origine à partir de son embedding, avec une fidélité parfois frappante sur des textes courts et pour certains modèles d’embedding, surtout quand l’attaquant peut interroger le modèle d’encodage.
Il faut ici être prudent, et je le serai. L’état de l’art bouge ; les résultats dépendent fortement du modèle d’embedding, de la dimension des vecteurs, de la longueur des fragments, de ce que l’attaquant sait et peut faire ; les défenses proposées (ajout de bruit, transformations secrètes des vecteurs) ont chacune un coût en pertinence et une robustesse qui reste discutée. Je ne prétendrai pas qu’on reconstitue aujourd’hui n’importe quel document à partir de n’importe quel index. Je prétends seulement que l’hypothèse « les vecteurs ne révèlent rien » est réfutée, et qu’aucune architecture ne devrait plus reposer dessus.
La conséquence pratique est simple, et elle se passe de la question de savoir jusqu’où va l’inversion : une base vectorielle doit être classée au niveau du document le plus sensible qu’elle indexe. Elle se protège comme le corpus source : accès restreint, chiffrement au repos, sauvegardes traitées au même niveau, journalisation des accès. Les vecteurs ne sont pas une forme anonymisée des documents. Ils en sont une forme compressée, avec perte, mais pas avec oubli.
Les fuites qui restent quand on a tout bien fait
Section intitulée « Les fuites qui restent quand on a tout bien fait »Supposons une architecture exemplaire : droits reportés, filtre dans le moteur, identités propagées, index cloisonnés, base chiffrée. Il reste des fuites, et il vaut mieux les connaître que les découvrir.
La réponse elle-même. Le modèle rédige à partir des fragments autorisés, et c’est très bien. Mais il peut agréger plusieurs fragments autorisés pour produire une inférence qui ne l’est pas : trois comptes rendus accessibles, qui mentionnent chacun un détail anodin, permettent de déduire une information qu’aucun ne contenait. C’est le problème de l’agrégation, bien connu de ceux qui classifient des informations, et un RAG le rend industriel. Il n’a pas de solution technique générale ; il en a une organisationnelle, qui consiste à se demander ce que le corpus accessible à tous permet de déduire, question qu’on ne s’était jamais posée tant que personne n’avait le temps de tout lire.
Les journaux et les caches. Les questions posées et les fragments renvoyés sont généralement journalisés, pour le débogage, l’évaluation, l’amélioration de la pertinence. Ces journaux contiennent, par définition, des extraits du corpus, et souvent les plus sensibles, puisque ce sont ceux que les gens cherchent. Un cache de réponses partagé entre utilisateurs est pire : une réponse calculée pour quelqu’un d’habilité peut être servie à quelqu’un qui ne l’est pas, si la clé de cache ne contient pas l’identité ou les droits. On retrouve là une vieille question de rétention et de tri : les traces d’un système qui lit tout finissent par contenir tout.
L’effacement. Supprimer un document de la source ne le supprime pas de l’index, ni des journaux, ni des sauvegardes de l’index, ni des jeux d’évaluation qu’on a constitués à partir des questions réelles. Le jour où quelqu’un exerce un droit d’effacement sur des données personnelles, il faut pouvoir retrouver tous les fragments, tous les vecteurs et toutes les traces issus d’un document donné. Cela suppose d’avoir gardé le lien entre chaque fragment et sa source, ce qui est facile à prévoir et coûteux à rattraper.
L’injection par le corpus. Un index dans lequel des utilisateurs peuvent faire entrer des documents (en les déposant sur un partage indexé, en modifiant une page de wiki) est un canal par lequel ils peuvent faire lire des consignes au modèle, au bénéfice d’autres utilisateurs. Le filtrage par droits limite ce que chacun voit ; il ne limite pas ce que chacun peut écrire à l’intention des autres.
Le meilleur argument contraire
Section intitulée « Le meilleur argument contraire »La position adverse la plus solide n’est pas « la sécurité n’est pas un sujet ». Elle est plus fine, et plus dérangeante.
Elle dit : le RAG ne crée pas le problème, il le révèle. Si le stagiaire peut obtenir le compte rendu d’entretien de son responsable par l’assistant, c’est bien souvent que le document était déjà lisible par lui sur le partage réseau, parce que les droits d’une organisation réelle sont notoirement trop larges : dossiers ouverts à « tous les employés » par commodité, héritages jamais revus, liens de partage « toute personne de l’organisation disposant du lien ». L’assistant qui respecterait scrupuleusement les ACL réelles fuirait autant. Il le ferait simplement plus vite. Le vrai coupable serait la gestion des droits, et le RAG un détecteur involontaire, qu’on devrait presque remercier.
Cet argument a largement raison sur les faits, et je le prends au sérieux. Dans bien des cas, le premier effet d’un assistant correctement branché sur les droits réels est de révéler l’étendue du partage excessif. C’est d’ailleurs une excellente raison de faire précéder tout projet de RAG d’une revue des droits sur le corpus qu’on s’apprête à indexer, revue qui n’a jamais été faite et dont le projet d’IA fournit enfin le budget.
Mais la conclusion qu’on en tire est fausse. Le partage excessif était toléré parce qu’il était protégé par la friction. Un document mal protégé dans une arborescence de cent mille fichiers n’était lu que par ceux qui connaissaient son existence et son emplacement. Cette protection n’était ni voulue ni avouable, c’était de la sécurité par obscurité au sens le plus littéral, mais elle fonctionnait, de la même façon qu’une porte non verrouillée au fond d’un couloir où personne ne passe reste, statistiquement, peu visitée. La recherche sémantique supprime la friction. Elle transforme un défaut latent en exposition active.
Il en découle que le RAG ne peut pas être déployé sur le principe « il respecte les droits existants, donc il n’aggrave rien ». Il aggrave, parce qu’il change la probabilité qu’un droit trop large soit effectivement exercé. Respecter les droits existants est la condition minimale. La condition suffisante suppose de les avoir revus, et d’accepter que la revue retarde le projet. Ce qui, dans la plupart des organisations, est un argument décisif pour ne pas la faire.
Ce que je ne sais pas
Section intitulée « Ce que je ne sais pas »Je ne sais pas où en sera l’inversion des embeddings dans deux ans. La trajectoire des publications suggère des progrès réguliers, et je n’ai aucune raison de croire qu’elle s’arrêtera. Je n’ai pas non plus de raison d’extrapoler. J’ai donc bâti les recommandations de cet éditorial pour qu’elles tiennent quelle que soit la réponse : classer l’index comme le corpus rend la question de l’inversion secondaire.
Je ne sais pas quantifier le risque d’agrégation. Qu’un ensemble de documents individuellement anodins permette des déductions sensibles est certain dans le principe ; dans quelle mesure un modèle de langage le fait spontanément, sur un corpus donné, en réponse à des questions ordinaires, je n’en ai pas de mesure, et je me méfie de ceux qui en ont une.
Je ne sais pas si les fonctions de filtrage des bases vectorielles sont toutes au niveau de ce qu’on leur demande. Les produits évoluent vite, leurs mécanismes de filtrage combinés à la recherche approximative ont des comportements qui dépendent de la version et de la configuration, et je n’ai pas audité leur code. Mon conseil de faire porter la décision par un mécanisme éprouvé (la sécurité au niveau des lignes d’une base relationnelle, ou une vérification à la source) plutôt que par une fonction récente reflète cette ignorance autant qu’une conviction.
Je ne sais pas comment ces questions se poseront quand l’indexation sera native. Quand chaque suite bureautique proposera son propre index sémantique, intégré, géré par l’éditeur, la question des droits sera traitée (ou non) par un code que l’organisation ne voit pas. Tout cet éditorial suppose qu’on construit son RAG. Cette hypothèse se périme à vue d’œil.
Ce qui reste
Section intitulée « Ce qui reste »Trois choses, qui me paraissent devoir tenir.
Un index est une copie, et une copie sans droits est un contournement. Le document protégé ne l’est plus dès que son contenu est rangé dans une base que tout le monde peut interroger. Le droit d’accès doit voyager avec le fragment, et sa révocation avec lui.
Le contrôle se fait dans la requête, pas dans le prompt. Ce que l’utilisateur n’a pas le droit de lire ne doit jamais atteindre le contexte du modèle. Demander au modèle de se taire sur ce qu’il vient de lire, c’est confier le secret professionnel à un perroquet bien élevé.
Le vecteur n’est pas un masque. Il est construit pour préserver le sens, et il le préserve assez pour qu’on l’interroge, voire qu’on le remonte. La base vectorielle se classe au niveau du document le plus sensible qu’elle contient, et se protège en conséquence.
Il y a dans tout cela une ironie que je ne résiste pas à relever, par déformation d’âge. Pendant des décennies, on s’est plaint que les gens ne trouvaient jamais les documents dont ils avaient besoin dans les partages de fichiers. On a enfin construit l’outil qui les trouve tous. Il fallait peut-être se demander, avant, s’il était vraiment souhaitable que chacun trouve tout.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Quand l’index ne filtre rien, le journal d’accès du serveur de fichiers ne montre qu’un lecteur : le compte de service de l’indexation, qui a tout lu une fois, en toute légitimité. Les consultations réelles, elles, n’y apparaissent jamais. Le jour où le tableur des salaires circule, l’organisation ne peut établir ni qui l’a obtenu, ni quand, ni par quelle question ; le périmètre de l’incident se résume alors à « toute personne ayant accès à l’assistant », formule difficile à présenter comme une mesure de maîtrise. L’audit des droits sur la source reste impeccable, ce qui ne console personne.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Un système de recherche augmentée fonctionne en plusieurs étapes. À l’indexation, un programme lit les documents de l’organisation avec un compte qui a souvent le droit de tout lire. Il découpe chaque document en fragments, calcule pour chacun un vecteur, c’est-à-dire une suite de nombres qui représente son sens, et range le tout dans une base. Au moment d’une question, le système cherche les fragments dont le sens est le plus proche et les donne au modèle de langage, qui rédige la réponse.
Le problème vient de ce que les droits d’accès ne sont pas dans les documents : ils appartiennent au serveur de fichiers, au wiki ou à la messagerie. En copiant le contenu, l’indexation laisse ces droits derrière elle. Si rien n’est prévu, n’importe quel utilisateur de l’assistant peut obtenir des passages de documents qu’il n’avait pas le droit d’ouvrir. Demander au modèle de se taire ne suffit pas, car il a déjà lu le passage.
La bonne méthode consiste à attacher à chaque fragment les droits de son document, à transmettre l’identité réelle de la personne qui pose la question, et à laisser la base elle-même écarter les fragments interdits avant que le modèle ne les voie. Les droits copiés doivent suivre les changements. Les documents très sensibles peuvent être rangés dans des index séparés. Enfin, les vecteurs gardent assez de sens pour qu’on en tire des informations : la base se protège comme les documents eux-mêmes.
À lire aussi
- L'empoisonnement d'un RAG en une pageComment un document piégé glissé dans le corpus finit cité, ou obéi, par l'assistant qui le retrouve, en cinq étapes animées, avec les parades qui coupent la chaîne.
- Contrôler les accès d’un assistant IA interneMettre en œuvre la gouvernance des identités et le filtrage des accès dans un assistant IA interne utilisant un corpus documentaire.
- Sécuriser un corpus RAG contre l’injection indirecteCette fiche décrit comment empêcher qu’un document empoisonné dans un corpus RAG détourne un modèle de langage lors de la génération.
- Déployer Qdrant local pour recherche sémantique interneGuide pratique pour choisir, installer, régler et exploiter une base vectorielle locale destinée à la recherche sémantique interne.
Pages voisines
La citent
Quand la recherche sémantique contourne les droits
Elle cite
- Lien dans les deux sens :Comparer les bases vectorielles à grande échelle
- Ce qu'on garde
- L'injection de prompt n'est pas un bug
- Auditer l'héritage des permissions et le droit effectif
- Condensés cryptographiques : propriétés, constructions et familles
- Effacement des données dans une architecture distribuée
- Embeddings : vecteurs, recherche sémantique et RAG
- Protéger les données au repos : disque, base, sauvegarde
: les deux pages se citent l’une l’autre.