
EDR : fonctionnement, angles morts et contournements
EDR : fonctionnement, angles morts et contournements
Section intitulée « EDR : fonctionnement, angles morts et contournements »Un EDR (Endpoint Detection and Response) est un agent installé sur chaque poste et chaque serveur. Il enregistre en continu ce qui s’y passe, détecte les comportements suspects et permet d’agir à distance depuis une console centrale. Son utilité dépend moins de la qualité de l’agent que de trois conditions : un parc couvert, un agent dont on surveille l’état, et des alertes que quelqu’un lit vraiment.
→ Lire l’explication complète de la marmotte
Ce qu’un EDR fait de plus qu’un antivirus
Section intitulée « Ce qu’un EDR fait de plus qu’un antivirus »L’antivirus classique répond à une question : « ce fichier est-il connu comme malveillant ? ». Il compare des signatures et des heuristiques au moment de l’écriture ou de l’exécution, puis rend un verdict. Une fois le verdict rendu, il oublie tout. Un binaire légitime qui fait des choses illégitimes passe donc sans encombre, et c’est exactement ce que font la plupart des intrusions sérieuses.
L’EDR travaille sur des événements, pas sur des fichiers. Sa télémétrie couvre au minimum :
- les processus et leurs arbres de parenté : qui a lancé quoi, avec quelle ligne de commande, sous quel compte, avec quel niveau d’intégrité ;
- les fichiers : création, modification, renommage, suppression, avec empreinte du binaire ;
- le réseau : connexions sortantes et entrantes rattachées au processus qui les ouvre, résolutions DNS (Domain Name System) ;
- le registre sous Windows : clés de démarrage automatique, services, associations de fichiers ;
- les modules chargés : DLL (Dynamic Link Library) injectées dans un processus, pilotes chargés dans le noyau.
Trois capacités en découlent. D’abord la détection comportementale, qui juge une séquence plutôt qu’un objet : un traitement de texte qui lance un interpréteur de commandes, lequel télécharge un fichier puis contacte une adresse jamais vue sur le parc. Aucun de ces éléments n’est malveillant isolément ; la chaîne, si. Ensuite l’historique : quand une alerte tombe, l’analyste remonte la chaîne sur plusieurs jours, ce qui alimente directement la reconstruction de timeline d’une attaque. Enfin la réponse à distance : tuer un processus, mettre un fichier en quarantaine, isoler la machine du réseau en ne laissant ouvert que le canal vers la console, collecter des artefacts.
L’historique compte plus que la détection. Vingt ans de métier apprennent que la première alerte d’une intrusion arrive rarement au début de l’intrusion. Sans télémétrie conservée, l’analyste sait qu’il y a un problème, sans savoir depuis quand ni par où l’attaquant est entré.
Architecture d’un EDR : agent noyau, agent utilisateur, console
Section intitulée « Architecture d’un EDR : agent noyau, agent utilisateur, console »Un EDR se compose de trois couches, et chacune a ses propres contraintes.
Le composant noyau. Sous Windows, c’est un pilote qui s’abonne aux notifications du système (création de processus et de threads, chargement d’images, accès aux handles de processus, opérations de registre) et un pilote de filtrage du système de fichiers. Il consomme aussi ETW (Event Tracing for Windows), y compris le fournisseur de télémétrie réservé aux produits de sécurité. Sous Linux, la collecte passe par eBPF (extended Berkeley Packet Filter) sur les noyaux qui le permettent, sinon par un module noyau à recompiler ou requalifier à chaque mise à jour du noyau. Sous macOS, les extensions noyau sont dépréciées : les agents passent par le framework Endpoint Security, en espace utilisateur, avec des droits accordés par le système.
Le service en espace utilisateur. Il agrège les événements, applique les règles locales, parle à la console, et sur Windows s’appuie sur AMSI (Antimalware Scan Interface) pour inspecter les scripts après désobfuscation. Certains agents posent aussi des « hooks » dans les bibliothèques système des processus surveillés. Ce point compte pour la suite : un hook posé en espace utilisateur vit dans la mémoire du processus qu’il surveille, donc à la portée de ce processus.
La console centrale, généralement en SaaS. Elle reçoit la télémétrie, exécute les détections qui demandent du contexte (corrélation entre machines, rareté d’un binaire sur le parc), pousse les mises à jour de règles et de modèles, et émet les ordres de réponse.
Le schéma suivant montre qui envoie quoi à qui. Le point à retenir : la console envoie autant de choses vers les postes qu’elle n’en reçoit.
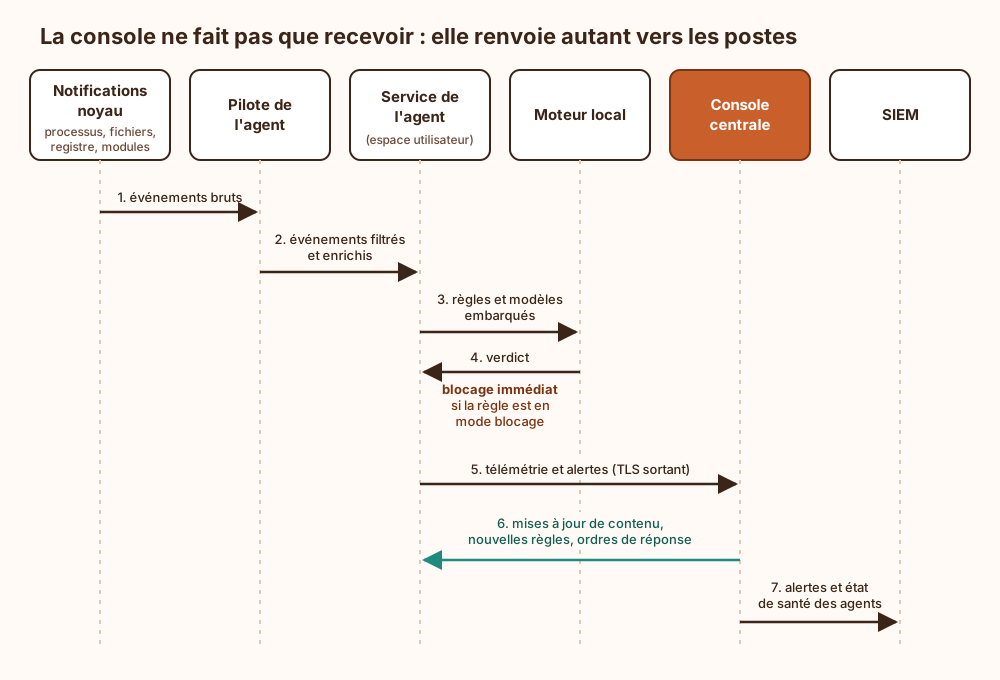
Une conséquence d’architecture s’impose : la console est un outil d’exécution de code à distance sur tout le parc. La fonction de « réponse en direct » ouvre un shell sur n’importe quelle machine. Un compte administrateur de console compromis vaut donc un compte d’administration du domaine, voire mieux, puisqu’il atteint aussi les machines hors domaine. On la traite comme un actif de tier 0 : MFA (Multi-Factor Authentication) résistante à l’hameçonnage, RBAC (Role-Based Access Control) qui sépare la lecture des alertes de la réponse active, journalisation des actions de console exportée hors de la console, comptes nominatifs.
Prérequis de plateforme
Section intitulée « Prérequis de plateforme »Avant le déploiement, plusieurs choses doivent exister :
- un inventaire fiable, par exemple une CMDB (Configuration Management Database), sans lequel personne ne peut mesurer la couverture ;
- la matrice de compatibilité de l’éditeur, confrontée aux versions réelles du parc : versions de noyau Linux, distributions, systèmes en fin de support ;
- des flux sortants vers la console, avec un proxy qui ne casse pas le TLS (Transport Layer Security) de l’agent (beaucoup d’agents épinglent leur certificat et refusent l’interception) ;
- un jeton d’installation traité comme un secret : il permet d’enrôler une machine dans le tenant, donc d’y injecter de la fausse télémétrie s’il fuit dans un script public ;
- une méthode de désinstallation contrôlée, puisque la protection contre l’altération impose un code ou une autorisation de console pour retirer l’agent.
EDR, XDR, NDR et SIEM : qui voit quoi
Section intitulée « EDR, XDR, NDR et SIEM : qui voit quoi »Les acronymes se multiplient plus vite que les capacités. Ramenés à ce qu’ils observent, ils se répartissent ainsi.
| Outil | Source | Force | Angle mort |
|---|---|---|---|
| EDR | Agent sur le terminal | Contexte processus, réponse sur la machine | Tout ce qui n’a pas d’agent |
| NDR (Network Detection and Response) | Copie du trafic réseau | Voit les équipements sans agent, les flux latéraux | Trafic chiffré, aucun contexte de processus |
| SIEM (Security Information and Event Management) | Journaux de toutes sources | Corrélation large, rétention longue | Dépend de ce qu’on lui envoie, pas de réponse native |
| XDR (Extended Detection and Response) | EDR plus d’autres sources du même éditeur | Corrélation préintégrée | Périmètre limité à ce que l’éditeur sait ingérer |
L’XDR n’est pas une nouvelle catégorie de capteur : c’est un EDR auquel on a branché la messagerie, l’identité et le cloud, avec des corrélations livrées toutes faites. La différence avec un SIEM tient au modèle de données (imposé par l’éditeur, contre un modèle qu’on construit soi-même) et à la capacité de réponse. Le choix dépend d’une question : les sources critiques sont-elles majoritairement chez le même éditeur ? Si oui, l’XDR fait gagner des mois d’ingénierie. Si non, le SIEM reste le point de corrélation, et l’EDR une source parmi d’autres (voir la théorie de la détection en SIEM). Dans les deux cas, l’état de santé des agents doit atterrir dans un outil qui ne dépend pas de l’EDR.
Angles morts de l’EDR et ce qu’il ne garantit pas
Section intitulée « Angles morts de l’EDR et ce qu’il ne garantit pas »Les équipements sans agent. Imprimantes, caméras, équipements OT (Operational Technology) et automates, appliances réseau (VPN, pare-feu, équilibreurs de charge), hyperviseurs : aucun agent ne s’y installe, ou alors pas un agent pris en charge. Or les appliances de bordure figurent parmi les points d’entrée les plus exploités. Un attaquant qui s’installe sur une passerelle VPN est invisible pour l’EDR jusqu’à ce qu’il touche un poste équipé. Pour ces zones, la visibilité vient du réseau (NDR, journaux de flux) et de la segmentation, pas de l’EDR.
Les environnements non pris en charge. Distributions Linux exotiques, noyaux trop anciens ou trop récents par rapport à la matrice de l’éditeur, conteneurs éphémères, systèmes en fin de support qui hébergent justement l’application que personne n’ose toucher. Un agent installé en mode dégradé remonte souvent moins de télémétrie sans le signaler clairement dans la console.
Le « living off the land ». Un attaquant qui utilise PowerShell, WMI (Windows Management Instrumentation), les outils d’administration à distance déjà déployés ou les commandes natives du système produit des événements identiques à ceux d’un administrateur. L’EDR voit tout, et ne peut rien conclure seul : la détection repose sur le contexte (ce compte lance-t-il habituellement cet outil, depuis cette machine, à cette heure ?), donc sur une connaissance du parc que l’éditeur n’a pas. C’est le terrain du threat hunting par hypothèses, et la raison pour laquelle les promesses de détection autonome par apprentissage automatique méritent une lecture critique.
Le bruit. Un EDR réglé par défaut sur un parc réel produit des alertes sur les outils d’administration, les scripts de déploiement, les logiciels métier qui injectent du code dans d’autres processus. Chaque alerte non qualifiée coûte du temps d’analyste, et l’accumulation produit l’effet décrit dans la page sur la fatigue d’alerte en SOC : la vraie alerte se noie dans le flot.
Ce que l’EDR ne garantit pas, en résumé : ni la détection d’un attaquant qui n’a jamais touché un terminal équipé, ni la détection d’un attaquant qui se comporte comme un administrateur, ni la détection de sa persistance quand elle vit dans l’annuaire ou le cloud plutôt que sur le disque. L’identité, le réseau et les journaux applicatifs doivent couvrir le reste.
Contournement de l’EDR et surveillance de l’agent
Section intitulée « Contournement de l’EDR et surveillance de l’agent »Neutraliser l’EDR fait partie de la routine des opérateurs de rançongiciel, et des outils prêts à l’emploi circulent sur les forums. Les techniques connues tombent dans trois familles.
La désactivation avec des droits administrateur. Avec un compte administrateur local, ou mieux SYSTEM, l’attaquant tente d’arrêter le service, de désinstaller l’agent, d’ajouter une exclusion, ou de bloquer ses flux vers la console par une règle de pare-feu local. Contre-mesure : protection contre l’altération activée et verrouillée par la console, désinstallation soumise à un code par machine, et surtout réduction des comptes administrateurs locaux. Un EDR ne compense pas un mot de passe d’administrateur local identique sur tout le parc.
Le pilote vulnérable apporté par l’attaquant, dit BYOVD (Bring Your Own Vulnerable Driver). L’attaquant charge un pilote légitime, signé, mais porteur d’une vulnérabilité qui donne lecture et écriture en mémoire noyau. Depuis le noyau, il retire les abonnements de l’EDR aux notifications système ou termine ses processus protégés. La signature du pilote est valide, donc le système l’accepte. Contre-mesures : liste de blocage des pilotes vulnérables maintenue par Microsoft, activée et à jour ; HVCI (Hypervisor-protected Code Integrity), qui applique cette liste et durcit l’intégrité du noyau ; politique de contrôle des applications qui restreint les pilotes autorisés ; alerte sur tout chargement de pilote rare sur le parc. La liste de blocage a toujours un temps de retard sur les pilotes découverts, ce qui rend l’alerte sur la rareté indispensable.
Le décrochage des points d’observation. Les hooks posés en espace utilisateur peuvent être retirés par le processus qu’ils surveillent, ou contournés en appelant directement le noyau sans passer par les bibliothèques instrumentées. La télémétrie ETW émise dans le processus peut aussi être neutralisée depuis ce processus. Contre-mesure : privilégier les agents dont la collecte principale passe par les notifications noyau et la télémétrie ETW émise côté noyau, que le processus ne contrôle pas, et traiter toute altération détectée des bibliothèques système comme une alerte de haute sévérité.
Surveiller l’agent lui-même
Section intitulée « Surveiller l’agent lui-même »Un EDR neutralisé ne déclenche pas d’alerte : il se tait. La surveillance doit donc porter sur le silence.
- Battement de cœur : chaque agent signale sa présence à intervalle régulier. Une machine qui cesse de remonter alors qu’elle reste visible ailleurs (authentifications dans l’annuaire, baux DHCP, flux réseau) est le signal le plus fiable d’une désactivation.
- Rapprochement d’inventaire : comparer chaque jour la liste des agents actifs à l’inventaire. L’écart couvre les machines jamais équipées, les agents désinstallés et les clones de modèle qui partagent le même identifiant.
- Intégrité : version de l’agent, état de la protection contre l’altération, mode (audit ou blocage), politique appliquée. Un agent passé silencieusement en mode audit est un agent désarmé.
- Export vers le SIEM : ces signaux doivent partir dans un outil indépendant de la console EDR, puisqu’un attaquant qui tient la console tient aussi ses tableaux de bord.
Agent noyau et risque d’exploitation : la mise à jour du 19 juillet 2024
Section intitulée « Agent noyau et risque d’exploitation : la mise à jour du 19 juillet 2024 »Un agent qui s’exécute dans le noyau partage le sort du noyau. Le 19 juillet 2024, CrowdStrike a diffusé une mise à jour de contenu de détection (un fichier de configuration, pas une nouvelle version du capteur) pour son agent Windows. Selon l’analyse publiée ensuite par l’éditeur, un décalage entre le nombre de champs attendus par un modèle de détection et le nombre de champs fournis par le capteur a provoqué une lecture mémoire hors limites dans le pilote. Les machines Windows concernées ont planté au démarrage, en boucle. Microsoft a estimé à environ 8,5 millions le nombre d’appareils Windows touchés.
La remédiation demandait le plus souvent une intervention sur chaque machine (démarrage en mode sans échec ou en environnement de récupération, suppression du fichier fautif), et donc les clés de récupération BitLocker des disques chiffrés. Les organisations dont les clés étaient stockées sur un serveur lui-même en boucle de redémarrage ont découvert la dépendance circulaire au pire moment.
Les leçons d’exploitation sont générales, et valent pour tout produit de ce type :
- les mises à jour de contenu sont du code : un fichier de règles interprété par un pilote noyau a le même pouvoir de nuisance qu’un nouveau pilote. Exiger de l’éditeur qu’il les déploie par anneaux, et vérifier ce que le contrat permet de piloter (certains contenus de détection ne suivent pas la politique de version choisie pour le capteur) ;
- les clés de récupération du chiffrement de disque doivent rester accessibles sans le parc qu’elles protègent : copie hors ligne ou dans un coffre indépendant ;
- le plan de reprise doit prévoir une panne simultanée de tous les postes, pas seulement la perte d’un datacenter ;
- l’accès à la console de gestion de parc et aux procédures d’intervention à distance ne doit pas dépendre des postes eux-mêmes.
L’incident ne plaide pas contre l’EDR. Il rappelle que l’EDR est un logiciel privilégié présent partout, donc un point de défaillance commun, à gérer comme tel.
Déploiement et exploitation d’un EDR
Section intitulée « Déploiement et exploitation d’un EDR »La position défendue ici : un EDR sur 100 % du parc compatible, en mode blocage, avec protection contre l’altération, battement de cœur surveillé dans le SIEM et une équipe qui lit les alertes à toute heure. Le compromis central est explicite : on gagne une visibilité et une capacité de réponse qu’aucun autre capteur ne fournit sur le terminal ; on paie un composant noyau sur chaque machine, un flux d’alertes à absorber et une console qui vaut les clés du royaume. Si l’une des quatre conditions manque, l’investissement rapporte une fraction de ce qu’il coûte.
Couverture. La couverture se mesure en pourcentage de l’inventaire, pas en nombre de licences. Les serveurs passent souvent en dernier, parce que les équipes applicatives redoutent l’impact ; ce sont pourtant eux que l’attaquant vise pour le déploiement final d’un rançongiciel. Les contrôleurs de domaine sont prioritaires, pas facultatifs.
Mode audit, puis blocage. Le mode audit sert à mesurer le bruit et à construire les exclusions sur quelques semaines, par groupe de machines représentatif. Il a une date de fin écrite dès le départ. Un parc resté en audit « le temps de stabiliser » est la configuration la plus répandue et la plus inutile du secteur : toute la facture, aucune protection.
Exclusions. Chaque exclusion est un endroit où l’attaquant sait qu’on ne regarde pas, et les outils offensifs vérifient d’ailleurs les exclusions configurées. Règles :
- exclure par signataire et empreinte plutôt que par chemin ; une exclusion de répertoire inscriptible par un utilisateur revient à offrir un dossier où déposer n’importe quoi ;
- exclure de la prévention sans exclure de la télémétrie quand le produit le permet ;
- donner à chaque exclusion un propriétaire, une justification et une date de révision ;
- interdire les exclusions de processus d’interpréteurs (PowerShell, shells, moteurs de script).
Qui lit les alertes. Trois modèles : SOC (Security Operations Center) interne en 24/7, SOC interne en heures ouvrées complété par un prestataire de nuit, ou MDR (Managed Detection and Response) entièrement externalisé. Le choix dépend d’une question : qui a le droit d’isoler une machine de production à trois heures du matin ? Si la réponse est « personne sans réveiller le directeur informatique », le prestataire ne fera que notifier, et les rançongiciels se déploient de préférence la nuit et le week-end. On écrit à l’avance quelles actions de réponse sont autorisées sans validation, sur quels périmètres. Les mêmes règles alimentent le déroulé des premiers gestes forensiques, puisqu’une isolation précipitée peut faire perdre de l’état mémoire (voir l’analyse mémoire et réseau).
Conservation de la télémétrie. La rétention dans la console est fixée par l’offre souscrite et souvent plus courte que le délai qui sépare l’intrusion de sa découverte. Exporter la télémétrie brute, ou au moins les événements de processus, de réseau et d’authentification, vers un stockage maîtrisé (SIEM ou lac de données, voir l’ingénierie de la donnée de sécurité) permet de remonter au-delà. La volumétrie se dimensionne sur un échantillon réel, pas sur la fiche commerciale.
Secrets et sauvegarde. Jetons d’installation renouvelés et jamais publiés dans un dépôt ; codes de désinstallation par machine ; clés d’API (Application Programming Interface) de la console à portée minimale et en rotation ; export régulier des politiques et des exclusions, pour reconstruire une configuration après une erreur ou une compromission du tenant.
Exemple : flux télémétrie, détection, alerte, réponse
Section intitulée « Exemple : flux télémétrie, détection, alerte, réponse »Le scénario : un utilisateur ouvre une pièce jointe, le traitement de texte lance un interpréteur de commandes avec une commande encodée, qui télécharge une charge et ouvre une connexion vers une adresse inconnue. Le schéma suit la donnée de l’événement brut à l’action de réponse, avec les deux embranchements qui comptent : le blocage local et le faux positif.
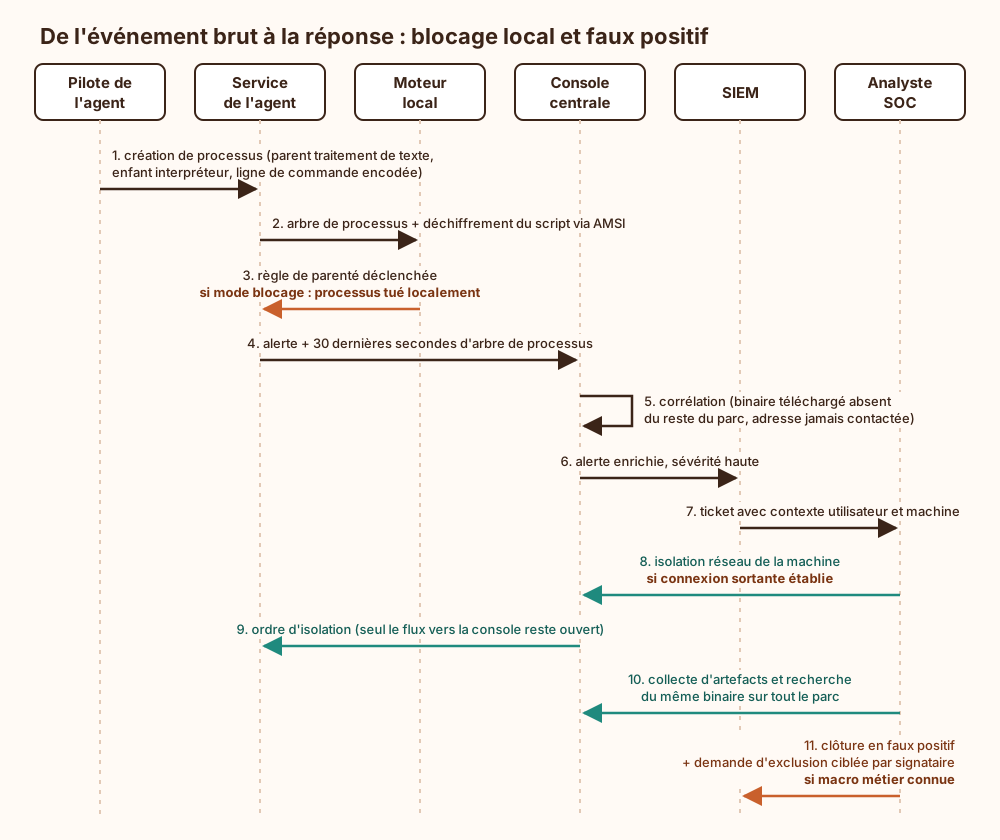
Ce qu’il faut lire : la détection se fait à deux niveaux. Le moteur local juge seul et vite, sur la seule machine ; la console juge avec le contexte du parc (rareté du binaire, nouveauté de la destination). L’isolation n’est pas automatique ici, elle est conditionnée à un signe de communication établie, ce qui limite la casse en cas de faux positif. Enfin, la clôture en faux positif ne crée pas d’exclusion directement : elle produit une demande qui suit le circuit de révision décrit plus haut.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans agent EDR, l’ouverture d’un accès à la mémoire du processus LSASS (Local Security Authority Subsystem Service, qui garde les secrets des sessions ouvertes) pour voler des identifiants n’est observée par aucun composant actif par défaut : un antivirus centré sur les fichiers ne voit pas un outil d’extraction chargé directement en mémoire. Pendant un incident, chercher une empreinte de binaire ou une adresse de destination sur tout le parc demande une collecte manuelle, machine par machine. Le périmètre de la compromission reste donc inconnu, et la remédiation doit traiter l’ensemble du parc comme compromis : réinstallation large et rotation de tous les secrets. Pour confiner une machine, il faut alors couper le réseau au niveau du commutateur ou du pare-feu. Cette coupure isole des segments entiers au lieu d’une seule machine et supprime aussi tout accès à distance pour collecter les artefacts.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Sur chaque ordinateur d’une entreprise, on installe un petit programme de surveillance. Une partie de ce programme tourne au cœur du système, là où tout passe : chaque fois qu’un logiciel démarre, ouvre un fichier ou se connecte à Internet, le système le prévient. Il garde ces informations, les trie, et les envoie à un serveur central.
Ensuite viennent les règles. Un seul geste ne prouve rien, mais certaines suites de gestes sont typiques d’une attaque : un document qui lance un programme caché, lequel télécharge autre chose puis contacte une adresse inconnue. Quand une règle reconnaît une telle suite, le programme peut bloquer tout de suite et prévient une équipe humaine. Cette équipe regarde l’historique pour comprendre ce qui s’est passé, puis peut couper la machine du réseau à distance.
Ça échoue de plusieurs façons. Les appareils sans ce programme, comme les imprimantes ou les boîtiers réseau, restent invisibles. Un pirate qui utilise les outils normaux des administrateurs ressemble à un administrateur. Un pirate avec tous les droits peut éteindre le programme, d’où l’importance de remarquer une machine qui se tait soudain. Trop d’alertes inutiles fatiguent l’équipe. Et comme le programme tourne au cœur du système, une mauvaise mise à jour peut faire planter des millions d’ordinateurs d’un coup, ce qui est arrivé en juillet 2024.
À lire aussi
- SOC centre des opérations de sécurité : rôle, organisation, mesureCe qu'est un SOC (centre des opérations de sécurité), comment il s'organise, quel modèle choisir et comment juger s'il détecte vraiment les attaques.
- Menaces réseau, détection et réponse opérationnelleRelier attaques réseau, détection, triage, réponse à incident, DDoS et exploitation SOC sans transformer le site en manuel offensif.
- IoC ou TTP pour détecter une compromissionComprendre la durée de vie limitée des indicateurs de compromission, leur partage et le basculement de la détection vers les TTP.
- Python pour l'automatisation défensive, usages et garde-fousCe que Python apporte à une équipe de défense et les règles qu'un script de défense doit respecter pour ne pas devenir lui-même une faille.
Pages voisines
La citent
EDR : fonctionnement, angles morts et contournements
Elle cite
- Lien dans les deux sens :Détecter la persistance d’un attaquant après incident
- Lien dans les deux sens :Comment formuler une hypothèse de threat hunting
- Collecter et fiabiliser les logs de sécurité
- Comment calibrer les alertes d’un SIEM sans noyer le SOC
- Pourquoi le ML échoue à détecter les menaces
- Réduire la fatigue d’alerte dans un SOC
- Analyse mémoire et réseau après un incident
- Comment limiter le mouvement latéral après compromission
- Forensics numérique et chaîne de conservation après incident
- Ransomware-as-a-Service et double extorsion
- Reconstruire une timeline d'attaque après incident
: les deux pages se citent l’une l’autre.