
Conteneurs, Kubernetes, CNI et service mesh
Conteneurs, Kubernetes, CNI et service mesh
Section intitulée « Conteneurs, Kubernetes, CNI et service mesh »Le réseau d’un conteneur n’a rien de magique : ce sont des briques du noyau Linux, interfaces virtuelles, ponts, règles de traduction d’adresses, assemblées automatiquement. Kubernetes ajoute par-dessus un modèle d’adressage, des adresses de service stables, un DNS (Domain Name System) interne et des règles de filtrage qu’un module tiers doit appliquer. Cette fiche descend de l’hôte vers le cluster, puis du cluster vers la sécurité des flux entre services, avec à chaque étage la question qui sert au diagnostic : qui voit quoi, et qui applique la règle.
→ Lire l’explication complète de la marmotte
Conteneurs et réseau Linux
Section intitulée « Conteneurs et réseau Linux »Namespace, paire veth et bridge
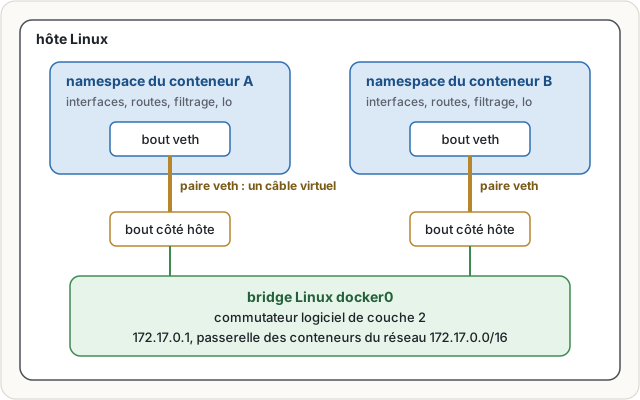
Section intitulée « Namespace, paire veth et bridge »Un namespace réseau Linux est une pile réseau complète et séparée : ses propres interfaces, sa table de routage, ses règles de filtrage, sa boucle locale. Un processus placé dans un namespace neuf ne voit que lo, éteinte. Pour le relier au reste, on crée une paire veth (virtual Ethernet), deux interfaces reliées comme les deux bouts d’un câble : ce qui entre par l’une sort par l’autre. Un bout reste sur l’hôte, l’autre est déplacé dans le namespace.
ip netns add demoip link add veth-hote type veth peer name veth-ctip link set veth-ct netns demoip netns exec demo ip addr add 172.30.0.2/24 dev veth-ctip netns exec demo ip link set veth-ct upQuand plusieurs conteneurs cohabitent, leurs bouts côté hôte sont rattachés à un bridge Linux, commutateur logiciel de couche 2. Docker crée ainsi docker0, avec par défaut le réseau 172.17.0.0/16 et l’adresse 172.17.0.1 comme passerelle des conteneurs.
NAT et publication de ports
Section intitulée « NAT et publication de ports »Pour sortir, les conteneurs passent par une NAT (Network Address Translation) de source : une règle MASQUERADE remplace leur adresse privée par celle de l’hôte. Pour être joints, il faut publier un port : docker run -p 8080:80 nginx ajoute une traduction de destination qui envoie le port 8080 de l’hôte vers le port 80 du conteneur, sur toutes les interfaces de l’hôte. Deux détails piègent régulièrement. D’une part, ces règles sont insérées par Docker dans ses propres chaînes iptables, évaluées avant celles d’un pare-feu local comme ufw : un port publié est joignable même si le pare-feu de l’hôte semble l’interdire. D’autre part, la forme -p 127.0.0.1:8080:80 limite la publication à la boucle locale, ce qui est presque toujours ce que voulait l’auteur d’un environnement de développement.
Les réseaux définis par l’utilisateur (docker network create) ajoutent une résolution de noms entre conteneurs et une isolation entre réseaux. Pour relier plusieurs hôtes, les overlays encapsulent les trames entre machines, typiquement en VXLAN (Virtual eXtensible Local Area Network) sur UDP (User Datagram Protocol) port 4789.
Ce que voit l’hôte
Section intitulée « Ce que voit l’hôte »Depuis l’hôte, tout est visible : ip link liste les paires veth, bridge link leurs rattachements, iptables -t nat -L -n ou nft list ruleset les traductions, et nsenter -t <pid> -n ss -tlnp les ports écoutés dans le namespace d’un conteneur. L’isolation réseau protège les conteneurs les uns des autres, pas du root de l’hôte. Un conteneur lancé avec --network host partage d’ailleurs la pile de l’hôte et renonce à toute isolation réseau.
Kubernetes réutilise exactement ces briques. La différence tient à l’échelle et à l’automatisation : ce n’est plus Docker mais un plugin réseau qui crée namespaces, veth et routes, sur des dizaines de nœuds, en faisant en sorte que tous se joignent.
Le modèle Kubernetes
Section intitulée « Le modèle Kubernetes »Pod IP et CNI
Section intitulée « Pod IP et CNI »Le Pod est l’unité de déploiement : un ou plusieurs conteneurs qui partagent le même namespace réseau, donc la même adresse et le même espace de ports. Le modèle réseau de Kubernetes impose trois règles : chaque pod a sa propre adresse, tout pod peut joindre tout autre pod sans NAT, et les agents d’un nœud peuvent joindre les pods de ce nœud. Ces règles sont réalisées par le plugin CNI (Container Network Interface), spécification de la CNCF (Cloud Native Computing Foundation) qui définit comment le moteur de conteneurs demande à un plugin de brancher un pod. Selon le plugin, les pods de nœuds différents communiquent par encapsulation (VXLAN), par routage direct, éventuellement annoncé en BGP (Border Gateway Protocol), ou par intégration au réseau du fournisseur de nuage, où chaque pod reçoit une adresse du VPC (Virtual Private Cloud).
La Pod IP n’est donc pas l’IP du nœud. La première appartient à une plage dédiée aux pods, change à chaque recréation et n’est en général pas routée hors du cluster ; la seconde est l’adresse de la machine sur le réseau de l’entreprise ou du nuage (voir réseau cloud et VPC). Quand un pod sort du cluster, c’est le plus souvent l’adresse du nœud qui apparaît dans les journaux de la destination, après une NAT de source.
Services et DNS de cluster
Section intitulée « Services et DNS de cluster »Les pods étant éphémères, un Service fournit un point d’accès stable devant un ensemble de pods choisis par étiquettes. Ses types se superposent :
| Type | Accessible depuis | Mécanisme |
|---|---|---|
| ClusterIP | l’intérieur du cluster | adresse virtuelle, traduite vers un pod par chaque nœud |
| NodePort | toute machine joignant un nœud | port de la plage 30000 à 32767 ouvert sur chaque nœud, plus une ClusterIP |
| LoadBalancer | l’extérieur | répartiteur provisionné par le fournisseur, vers les NodePort ou directement vers les pods |
La ClusterIP n’est portée par aucune interface : kube-proxy (en mode iptables, IPVS pour IP Virtual Server, ou nftables) ou un CNI à base d’eBPF (extended Berkeley Packet Filter) traduit au vol cette adresse vers celle d’un pod. Un ping vers une ClusterIP échoue donc souvent alors que le service fonctionne parfaitement, ce qui a causé plus d’une fausse alerte.
CoreDNS publie chaque Service sous le nom <service>.<namespace>.svc.cluster.local. Le fichier resolv.conf des pods contient par défaut ndots:5 et plusieurs domaines de recherche : un nom externe comme api.exemple.com est d’abord essayé avec chaque suffixe interne, ce qui multiplie les requêtes DNS. Écrire le nom avec un point final supprime ces essais.
Ingress et Gateway API
Section intitulée « Ingress et Gateway API »Un Service de type LoadBalancer crée un répartiteur par service, ce qui coûte vite cher et n’offre aucun routage HTTP (Hypertext Transfer Protocol). L’objet Ingress décrit des règles de routage par hôte et par chemin, appliquées par un contrôleur d’Ingress (NGINX, Traefik, HAProxy, ou celui d’un fournisseur) qui lui-même est exposé par un seul LoadBalancer. L’API Ingress n’évolue plus ; son successeur, Gateway API, publié en version stable 1.0 en octobre 2023, sépare la GatewayClass (l’implémentation), la Gateway (le point d’entrée, gérée par l’équipe plateforme) et les routes comme HTTPRoute (gérées par les équipes applicatives). Cette séparation des rôles est son principal apport de sécurité.
Le chemin complet d’une requête se dessine ainsi :
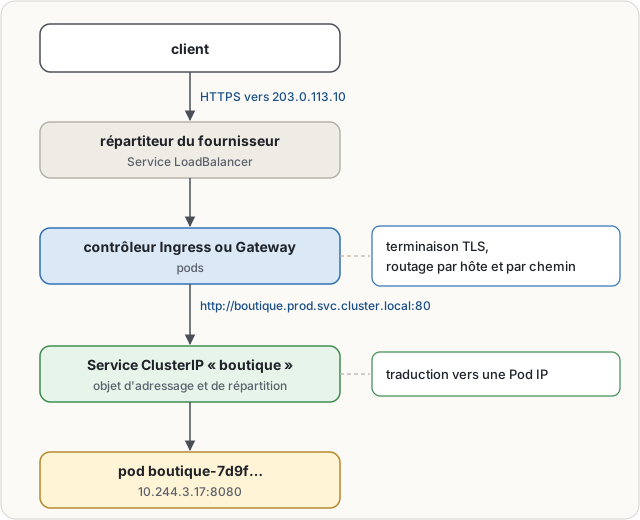
Un Service Kubernetes n’est donc pas un service applicatif : c’est un objet d’adressage et de répartition, qui peut pointer vers zéro pod sain sans broncher. Et un Ingress n’est pas un load balancer cloud : c’est une configuration de routage, que le contrôleur traduit, éventuellement en provisionnant ce répartiteur.
NetworkPolicy, une intention
Section intitulée « NetworkPolicy, une intention »Par défaut, tout pod joint tout pod. Une NetworkPolicy restreint ce comportement, mais l’API Kubernetes se contente de stocker l’objet : c’est le CNI qui l’applique, ou pas. Calico et Cilium l’appliquent ; Flannel seul ne le fait pas, et une politique déployée sur un tel cluster est acceptée sans erreur puis ignorée sans bruit. Une fois qu’un pod est sélectionné par une politique pour un sens de trafic, tout ce qui n’est pas explicitement autorisé dans ce sens est refusé.
apiVersion: networking.k8s.io/v1kind: NetworkPolicymetadata: name: base-depuis-api namespace: prodspec: podSelector: matchLabels: { app: postgres } policyTypes: [Ingress] ingress: - from: - podSelector: matchLabels: { app: api } ports: - protocol: TCP port: 5432Cette politique se lit : les pods app=postgres de l’espace prod n’acceptent en entrée que TCP (Transmission Control Protocol) 5432 depuis les pods app=api du même espace. Le reste du trafic entrant vers la base est refusé ; la sortie n’est pas concernée. Une politique de refus par défaut (podSelector: {} sans règle) appliquée à chaque espace, suivie d’autorisations ciblées, est la base de toute segmentation ; il faut alors penser à autoriser la sortie vers CoreDNS sur le port 53, faute de quoi plus rien ne résout. Le test ne prend qu’une ligne : kubectl run test --rm -it --image=nicolaka/netshoot -- nc -zv -w 2 postgres.prod 5432 depuis un pod non autorisé doit échouer.
Sécurité et service mesh
Section intitulée « Sécurité et service mesh »Segmenter l’est-ouest
Section intitulée « Segmenter l’est-ouest »Le trafic est-ouest, entre services du cluster, est celui qu’emprunte un attaquant après la compromission d’un pod. Trois couches peuvent le filtrer, et elles ne voient pas la même chose :
| Couche | Critère de décision | Ce qu’elle ne voit pas |
|---|---|---|
| Filtrage cloud (groupes de sécurité) | adresses et ports des nœuds | quel pod parle à quel pod |
| NetworkPolicy (CNI) | étiquettes de pods, espaces, ports | l’identité cryptographique, le contenu HTTP |
| Service mesh | identité de workload, méthode, chemin | le trafic des pods hors mesh |
mTLS, identité de workload et egress gateway
Section intitulée « mTLS, identité de workload et egress gateway »Un service mesh (Istio, Linkerd) place à côté de chaque pod un proxy, ou un agent par nœud dans les architectures sans sidecar, qui intercepte le trafic. Il apporte le mTLS (mutual TLS, Transport Layer Security mutuel) : chaque proxy présente un certificat de courte durée qui porte l’identité de workload, en général au format SPIFFE (Secure Production Identity Framework For Everyone), par exemple spiffe://cluster.local/ns/prod/sa/api. Les règles d’autorisation portent alors sur cette identité, rattachée au compte de service, plutôt que sur une adresse qui change (voir mTLS). Corollaire : la sécurité de l’identité dépend de celle du compte de service, sujet traité dans l’attaque par jeton de service account. La couverture réelle d’un mesh, pods oubliés et mode permissif compris, fait l’objet de service mesh et couverture réelle.
L’egress gateway concentre la sortie du cluster sur des pods dédiés, avec une liste de destinations autorisées et des journaux. Elle n’est efficace que combinée à une NetworkPolicy qui interdit la sortie directe : sinon, un pod compromis contourne le mesh en ouvrant une connexion brute.
eBPF et observabilité
Section intitulée « eBPF et observabilité »Les CNI à base d’eBPF chargent des programmes dans le noyau qui traitent les paquets au plus tôt, remplacent kube-proxy, appliquent les politiques par identité d’étiquettes plutôt que par listes d’adresses et peuvent filtrer en couche 7. Ils rendent aussi le réseau observable : avec Cilium, hubble observe --namespace prod --verdict DROPPED liste les flux refusés en temps réel, avec pod source, pod destination et politique en cause.
Diagnostiquer couche par couche
Section intitulée « Diagnostiquer couche par couche »Une requête qui échoue se diagnostique de l’application vers le nuage. L’application écoute-t-elle sur le bon port et la bonne adresse, pas seulement 127.0.0.1 ? Le Service a-t-il des points de terminaison (kubectl get endpointslices -l kubernetes.io/service-name=boutique) ? Le nom se résout-il depuis le pod appelant ? Une NetworkPolicy ou une règle du mesh refuse-t-elle le flux, et le proxy journalise-t-il une erreur TLS ? Enfin, côté nuage, le groupe de sécurité des nœuds autorise-t-il le trafic entre nœuds et le NodePort ? Chaque couche a ses propres journaux, et le premier réflexe consiste à savoir laquelle a dit non.
Pièges et confusions
Section intitulée « Pièges et confusions »Croire que toute NetworkPolicy est appliquée, alors que le CNI les ignore peut-être ; confondre Service Kubernetes et service applicatif ; exposer des NodePort ou des LoadBalancer sans revue, chaque équipe pouvant créer un point d’entrée Internet par un simple fichier YAML (YAML Ain’t Markup Language). Ce dernier point se gouverne par des politiques d’admission, décrites dans RBAC Kubernetes et contrôle d’admission.
Le CNI et le service mesh ne font pas le même métier : le premier construit la connectivité et applique le filtrage par étiquettes, le second ajoute identité, chiffrement et politique applicative par-dessus une connectivité qu’il suppose existante.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans règles de filtrage réellement appliquées, un seul pod compromis joint tous les autres, bases de données comprises, puisque le réseau d’un cluster laisse par défaut chacun parler à chacun. Sans passerelle de sortie, ce même pod envoie ce qu’il veut vers l’extérieur avec l’adresse de la machine hôte, ce qui rend l’origine difficile à retrouver. Et sans observabilité des flux internes, ce trafic entre services ne laisse aucune trace exploitable : l’attaquant se promène d’une chambre à l’autre, et le registre de la résidence ne note que les entrées par la porte principale.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Un conteneur est un programme isolé du reste de la machine. Sous Linux, un espace de noms réseau lui donne ses propres interfaces. Une paire d’interfaces virtuelles relie le conteneur à la machine hôte, et un pont, qui joue le rôle d’un commutateur logiciel, relie les conteneurs entre eux. Pour sortir, les adresses sont traduites ; pour être joint de l’extérieur, un port de la machine hôte est publié vers le conteneur.
Kubernetes est un orchestrateur : il répartit les conteneurs sur plusieurs machines. Il les regroupe en pods, et chaque pod reçoit sa propre adresse. Comme les pods naissent et disparaissent, un Service offre une adresse stable et répartit les requêtes entre eux : seulement à l’intérieur du cluster, sur un port de chaque machine, ou par un répartiteur externe. Un point d’entrée web, Ingress ou Gateway API, dirige les requêtes venues de l’extérieur. Un service de noms interne permet de trouver les Services par leur nom.
Le réseau lui-même est construit par un module appelé CNI, pour interface réseau de conteneur. Les règles de filtrage, appelées NetworkPolicy, décrivent quels pods peuvent se parler, mais elles ne sont appliquées que si ce module les prend en charge ; sinon, elles restent sans effet. Un maillage de services ajoute à côté de chaque programme un relais qui chiffre les échanges et vérifie l’identité des deux côtés. Une passerelle de sortie contrôle ce qui quitte le cluster, et l’observabilité permet de suivre les flux entre services.
À lire aussi
- Isolation réseau multi-tenant avec VPC et NetworkPolicyPrincipes de segmentation cloud native multi-tenant avec VPC, security groups et network policies, hors service mesh.
- Docker ou Podman en auto-hébergement : root, rootless, isolationChoisir entre Docker et Podman pour un serveur autohébergé en comparant le démon root, le mode rootless et l'isolation réellement obtenue, avec les coûts d'exploitation de chaque option.
- Sécuriser l’auto-scaling des instances éphémèresArchitecture cloud-native d’auto-scaling et sécurité des instances qui apparaissent et disparaissent dynamiquement.
- Virtualisation réseau, NFV et data planes ouvertsComprendre la virtualisation réseau comme abstraction d’équipements, de fonctions et de chemins : isolation, overlays, NFV, data planes accélérés et plateformes open source.
Pages voisines
La citent
- Edge, MEC, Fog, Cloud-RAN et infrastructures distribuées
- Interfaces, pilotes et démarrage par le réseau
- L'entropie au démarrage
- Monolithe ou microservices : choisir sans se mentir
Conteneurs, Kubernetes, CNI et service mesh
Elle cite
- Auditer la couverture réelle du mTLS service mesh
- Réduire RBAC Kubernetes et bloquer les pods dangereux
- Cloud networking, VPC/VNet, CDN et équilibrage
- Déployer des NetworkPolicy Kubernetes pas à pas
- EBPF pour observabilité et enforcement Linux
- Installation locale : guide complet pour déployer un site en local
- Jeton de compte de service Kubernetes monté par défaut
- mTLS