
Isolation des conteneurs Docker : namespaces, cgroups et évasions
Isolation des conteneurs Docker : namespaces, cgroups et évasions
Section intitulée « Isolation des conteneurs Docker : namespaces, cgroups et évasions »Docker est une plateforme qui emballe une application et ses dépendances dans une image, puis l’exécute dans un conteneur isolé. Le mot « isolé » porte toute l’ambiguïté du sujet : un conteneur reste un processus de l’hôte qui partage son noyau, et chaque couche de confinement qu’on lui ajoute ne bouche qu’une partie des trous. La position défendue ici : un conteneur confine du code de confiance, il ne sépare pas des locataires hostiles.
→ Lire l’explication complète de la marmotte
Conteneur Linux : un processus de l’hôte avec une vue restreinte
Section intitulée « Conteneur Linux : un processus de l’hôte avec une vue restreinte »Un conteneur n’existe pas dans le noyau Linux. Aucune structure ne s’appelle « conteneur ». On y trouve un processus ordinaire, visible dans le ps de l’hôte, auquel on a appliqué trois familles de mécanismes :
- Les espaces de noms (namespaces) changent ce que le processus voit.
pidlui donne sa propre numérotation de processus (il se croit PID (Process IDentifier) 1).mountlui donne sa propre table de montages.netlui donne ses propres interfaces, routes et règles de filtrage.uts(UNIX Time-Sharing) isole le nom d’hôte.ipc(Inter-Process Communication) isole files de messages et mémoire partagée System V.cgroupmasque l’arborescence des cgroups de l’hôte.userremappe les identifiants : root dans le conteneur peut correspondre à un utilisateur sans privilège sur l’hôte. Le noyau propose aussi un espacetimedepuis la version 5.6, que Docker n’active pas par défaut. - Les cgroups (control groups) limitent ce que le processus consomme : mémoire, CPU (Central Processing Unit), entrées-sorties, nombre de processus. Docker gère les cgroups v2 depuis la version 20.10. Un détail qui coûte cher : sans
--pids-limit, un conteneur peut lancer une fork bomb et épuiser la table des processus de l’hôte entier. - Les restrictions de privilèges (capacités, seccomp, LSM (Linux Security Modules)) changent ce que le processus a le droit de faire. C’est l’objet de la section suivante.
Docker ne fait lui-même presque rien de tout cela. La chaîne d’exécution passe par plusieurs composants, et chacun a sa propre surface d’attaque :
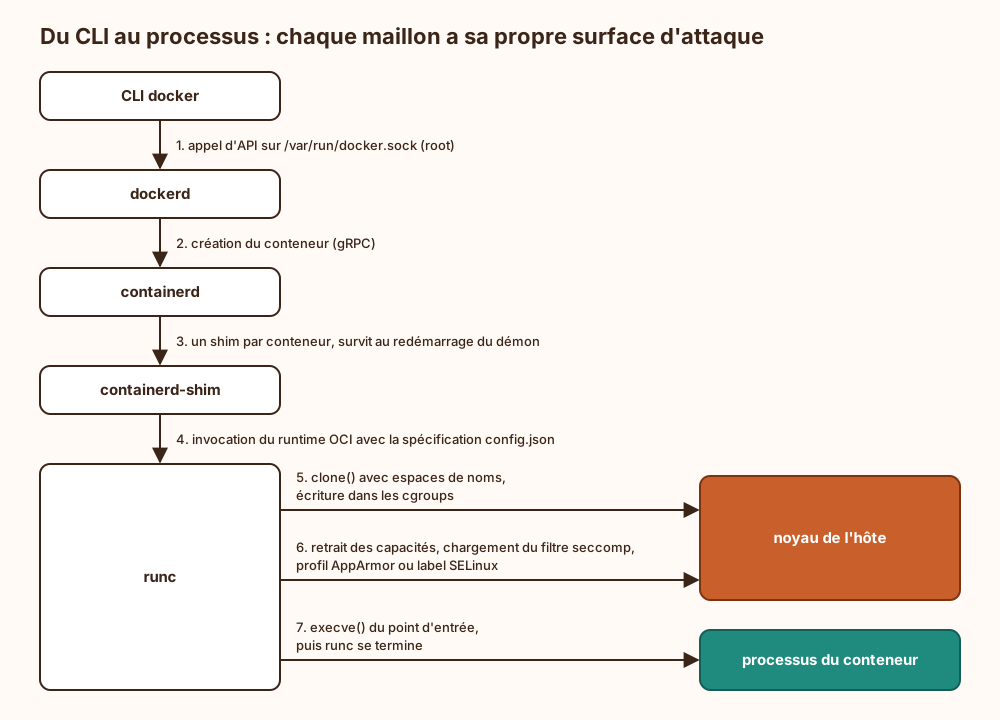
À lire dans l’ordre : le confinement est posé par runc, le runtime de référence de l’OCI (Open Container Initiative), juste avant l’execve(). Tout ce qui se passe avant (le démon, son socket, le shim) tourne en root sur l’hôte. Podman, CRI-O (implémentation de l’interface CRI (Container Runtime Interface) de Kubernetes) ou containerd utilisé seul passent par le même runtime OCI ou un équivalent (crun) : les conclusions de cette page valent pour eux.
La différence avec une machine virtuelle tient en une ligne : une VM (Virtual Machine) exécute son propre noyau au-dessus d’un hyperviseur qui expose une interface matérielle étroite, le conteneur exécute des appels système directement sur le noyau de l’hôte. La page sur les hyperviseurs de type 1 et 2 détaille l’autre modèle.
Couches de confinement : capacités, seccomp, AppArmor, SELinux, user namespace
Section intitulée « Couches de confinement : capacités, seccomp, AppArmor, SELinux, user namespace »Le schéma suivant montre où se situe chaque couche : toutes filtrent l’accès au même noyau, aucune ne le remplace.
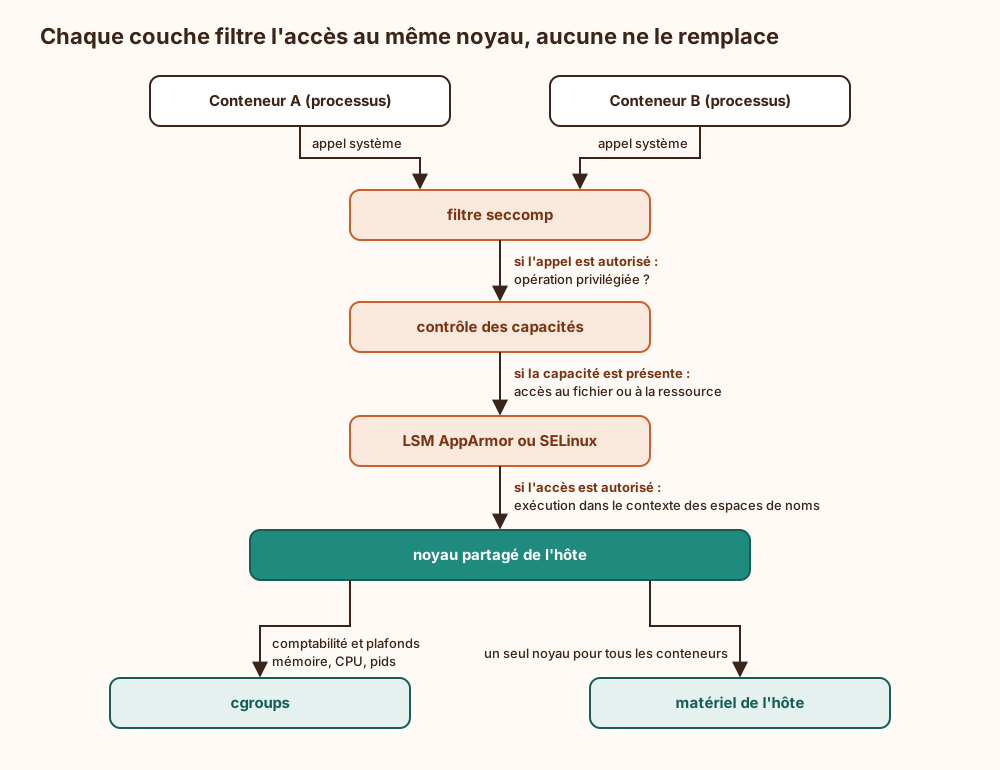
Capacités Linux. Le noyau découpe les pouvoirs de root en une quarantaine de capacités. Docker n’en conserve que 14 par défaut : CHOWN, DAC_OVERRIDE, FSETID, FOWNER, MKNOD, NET_RAW, SETGID, SETUID, SETFCAP, SETPCAP, NET_BIND_SERVICE, SYS_CHROOT, KILL, AUDIT_WRITE. Disparaissent notamment SYS_ADMIN, SYS_MODULE, SYS_PTRACE, NET_ADMIN, SYS_RAWIO, DAC_READ_SEARCH. Cette liste par défaut reste généreuse : NET_RAW permet de forger des paquets (usurpation ARP sur le pont), DAC_OVERRIDE ignore les permissions de fichiers. La bonne pratique tient en une règle : --cap-drop ALL, puis rajouter une à une les capacités dont l’application a réellement besoin. À ne pas confondre avec la notion théorique de sécurité par capacités, qui désigne autre chose.
Profil seccomp par défaut. Seccomp-bpf applique une liste blanche d’appels système. Le profil par défaut de Docker bloque entre autres kexec_load, init_module et finit_module, keyctl et add_key, open_by_handle_at, bpf, userfaultfd, et la création d’espaces de noms utilisateur via unshare ou clone. Ce dernier point a fait ses preuves : la CVE-2022-0185 (débordement de tas dans fs_context) exigeait CAP_SYS_ADMIN dans un user namespace fraîchement créé, et le profil seccomp de Docker empêchait cette création. Les pods Kubernetes, eux, tournaient historiquement en Unconfined : le kubelet n’applique RuntimeDefault que si on le demande (champ seccompProfile ou option seccompDefault). Seccomp est la couche qui réduit le plus la surface du noyau partagé ; la désactiver pour « débloquer » une application revient à retirer l’airbag parce qu’il gênait la vue.
AppArmor ou SELinux. Les LSM ajoutent un contrôle d’accès obligatoire. Sur Debian et Ubuntu, Docker charge le profil docker-default, qui interdit notamment l’écriture dans /proc/sys et /sys ainsi que les montages. Sur la famille Red Hat, SELinux étiquette les processus container_t et sépare les conteneurs entre eux par des catégories MCS (Multi-Category Security) : deux conteneurs compromis ne lisent pas les fichiers l’un de l’autre, même avec le même UID (User IDentifier). Le piège classique : setenforce 0 ou --security-opt label=disable ajoutés lors d’un dépannage, puis jamais retirés.
Espace de noms utilisateur et rootless. Sans user namespace, root dans le conteneur est root sur l’hôte, simplement privé de quelques capacités. Avec --userns-remap sur le démon, ou en mode rootless (Docker rootless, Podman par défaut), l’UID 0 du conteneur correspond à un UID non privilégié de l’hôte. Une évasion aboutit alors chez un utilisateur ordinaire. Le revers : le user namespace donne au processus des capacités « locales » qui ouvrent des chemins de code noyau habituellement réservés à root, d’où l’historique chargé de CVE noyau atteignables via unshare. Le compromis penche malgré tout nettement vers le remappage : mieux vaut un noyau un peu plus exposé qu’un root d’hôte offert en cas d’évasion. Côté Kubernetes, l’équivalent est hostUsers: false dans la spécification du pod.
no-new-privileges et système de fichiers en lecture seule. --security-opt no-new-privileges positionne le drapeau PR_SET_NO_NEW_PRIVS : un binaire setuid ou doté de capacités de fichier n’élève plus les privilèges lors de l’execve(). --read-only monte la racine du conteneur en lecture seule ; avec --tmpfs /tmp, l’attaquant ne peut plus déposer d’outil persistant dans l’image. Aucune des deux options ne casse une application correctement écrite, et toutes deux devraient figurer partout.
Pourquoi le conteneur n’est pas une frontière de sécurité comme une VM
Section intitulée « Pourquoi le conteneur n’est pas une frontière de sécurité comme une VM »Toutes les couches ci-dessus filtrent l’accès à un noyau qui reste unique. Le noyau Linux expose plusieurs centaines d’appels système, des pilotes, des systèmes de fichiers, une pile réseau : chaque faille exploitable dans cette surface depuis un processus non privilégié est potentiellement une évasion. Une VM expose à son invité une interface matérielle virtuelle bien plus étroite (elle n’est pas pour autant infranchissable, voir la page sur l’évasion de VM).
Les évasions documentées se rangent en deux familles.
Failles du runtime.
- CVE-2019-5736 (runc) : un conteneur contrôlé par l’attaquant pouvait écraser le binaire
runcde l’hôte via/proc/self/exelorsqu’un administrateur faisait undocker execdedans, ou au démarrage d’une image piégée. Résultat : exécution de code en root sur l’hôte. Docker 18.09.2 embarquait le correctif. - CVE-2024-21626 (« Leaky Vessels ») :
runcjusqu’à la version 1.1.11 laissait fuir un descripteur de fichier ouvert sur l’arborescence/sys/fs/cgroupde l’hôte. UnWORKDIRpointé sur/proc/self/fd/<n>donnait au processus un répertoire courant situé dans le système de fichiers de l’hôte. Corrigé dansrunc1.1.12. Le même lot de divulgations visait BuildKit (CVE-2024-23651, CVE-2024-23652, CVE-2024-23653) : la construction d’image est elle aussi une surface d’évasion. - CVE-2020-15257 (containerd) : l’API du shim écoutait sur un socket UNIX abstrait, accessible à tout conteneur lancé avec
--network=host.
Failles du noyau.
- CVE-2022-0847 (« Dirty Pipe ») : écriture arbitraire dans le cache de pages de fichiers ouverts en lecture seule, noyaux 5.8 à 5.16.10. Le cache de pages étant partagé par tous les conteneurs, un processus confiné peut modifier des fichiers de couches d’image communes, et des démonstrations publiques ont obtenu une évasion en visant le binaire du runtime. Seccomp, capacités et LSM n’y changeaient rien :
splice()etpipe()sont des appels parfaitement banals. - CVE-2022-0492 : contrôle manquant sur le fichier
release_agentdes cgroups v1, permettant une évasion depuis un conteneur ayant pu monter cgroupfs. Seccomp par défaut et AppArmor bloquaient l’exploitation ; un conteneur qui tournait sans eux était exposé.
La règle qui en découle : contre une faille du runtime, on patche le runtime ; contre une faille du noyau atteignable par des appels autorisés, aucune configuration de conteneur ne protège, seul un noyau à jour ou un noyau séparé le fait. Le cycle de mise à jour du noyau des nœuds devient donc une condition d’exploitation de la sécurité des conteneurs, et pas une affaire de maintenance générale. La page sur le durcissement système traite de cette réduction de surface côté hôte.
Erreurs de configuration qui annulent l’isolation
Section intitulée « Erreurs de configuration qui annulent l’isolation »La plupart des évasions observées n’exploitent aucune CVE : elles exploitent une option. Vingt ans de métier apprennent que l’option la plus dangereuse d’un outil est toujours celle qui fait marcher la démo du premier coup.
--privileged: toutes les capacités, aucun filtre seccomp, aucun profil AppArmor, accès à tous les périphériques de/dev. Monter le disque de l’hôte ou écrire unrelease_agentprend alors quelques lignes de shell. Un conteneur privilégié n’est plus un conteneur, c’est unchrootqui coûte plus cher.- Montage de
/var/run/docker.sock: quiconque parle à l’API Docker lance un conteneur--privilegedqui monte/de l’hôte. C’est un accès root sur l’hôte, sans aucune vulnérabilité. Les outils de supervision et les agents de CI (Continuous Integration) qui réclament ce socket l’obtiennent trop souvent sans discussion ; un proxy filtrant l’API ou un mode rootless dédié limite la casse. - Appartenance au groupe
docker: même conséquence, documentée comme telle par Docker. Ajouter un développeur au groupedockerrevient à lui donnersudosans mot de passe ni journalisation. - Montages de l’hôte :
-v /:/host,/proc,/sys,/etcou/var/lib/dockeren écriture ouvrent l’hôte directement./proc/sysrq-trigger,/sys/kernel/ou lecore_patternse transforment en primitives d’exécution sur l’hôte. - Capacités ajoutées :
CAP_SYS_ADMINest la capacité fourre-tout (montages, nombreux ioctl, opérations sur les espaces de noms) ; l’ajouter équivaut presque à--privileged.CAP_SYS_PTRACEcombinée à--pid=hostpermet d’injecter du code dans les processus de l’hôte.CAP_DAC_READ_SEARCHa permis l’attaque « Shocker » viaopen_by_handle_ataux débuts de Docker. - Espaces de noms de l’hôte partagés :
--pid=hostexpose tous les processus de l’hôte et leurs/proc/<pid>/environ, ce qui rejoint la question des secrets passés en variables d’environnement (voir la pollution de variables d’environnement dans un conteneur).--network=hostdonne accès aux services liés à127.0.0.1de l’hôte et aux sockets UNIX abstraits (cf. CVE-2020-15257).--ipc=hostpartage la mémoire System V. - Exécution en root dans le conteneur : sans user namespace, chaque faille d’isolation part d’un UID 0 réel.
USERdans l’image ou--userau lancement coûte une ligne. La construction d’images de base non root relève de la page sur les images Docker de base.
Publication de ports et contournement du pare-feu de l’hôte
Section intitulée « Publication de ports et contournement du pare-feu de l’hôte »Publier un port avec -p 8080:80 fait poser par Docker une règle DNAT dans la chaîne nat/PREROUTING (chaîne DOCKER), puis une autorisation dans filter/FORWARD. Le paquet n’atteint jamais la chaîne INPUT, là où ufw ou firewalld posent leurs règles. Le schéma suivant montre ce trajet :
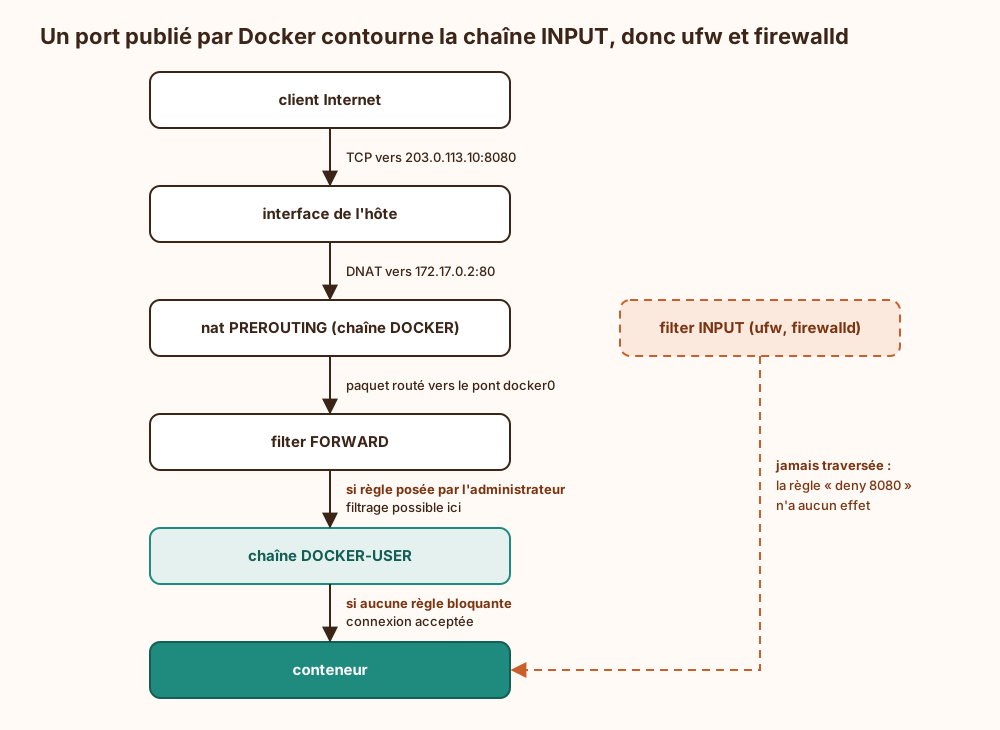
Le pare-feu affiche le port comme fermé pendant que tout Internet s’y connecte : la sécurité par interface graphique dans sa forme la plus pure. Deux contre-mesures : lier la publication à une adresse précise (-p 127.0.0.1:8080:80 derrière un proxy inverse), et placer les règles de filtrage dans la chaîne DOCKER-USER, la seule que Docker laisse intacte.
Exemple : lancer et vérifier un conteneur durci
Section intitulée « Exemple : lancer et vérifier un conteneur durci »Les commandes suivantes lancent un conteneur avec toutes les couches de confinement disponibles sans outil tiers, puis lisent dans /proc ce que le noyau applique réellement. On vérifie l’état effectif, pas l’intention.
# Sur l'hôte : options de sécurité actives du démon (seccomp, apparmor ou selinux, userns, rootless)docker info --format '{{.SecurityOptions}}'
# Conteneur durci : aucune capacité, pas d'élévation setuid, racine en lecture seule,# UID non root, plafonds de processus et de mémoiredocker run --rm -it \  --cap-drop ALL \  --security-opt no-new-privileges \  --read-only --tmpfs /tmp \  --user 10001:10001 \  --pids-limit 100 --memory 256m \  alpine:3.20 sh
# Dans le conteneur : état réel appliqué par le noyaugrep -E 'CapEff|CapBnd|NoNewPrivs|Seccomp:' /proc/self/status# Attendu : CapEff et CapBnd à 0000000000000000, NoNewPrivs à 1,# Seccomp à 2 (mode filtre, profil par défaut chargé)cat /proc/self/attr/current# Profil LSM appliqué, par exemple « docker-default (enforce) » sous AppArmor
Un Seccomp: 0 signale un conteneur qui tourne sans filtre (cas typique : --privileged ou seccomp=unconfined hérité d’un fichier compose). Cette vérification s’intègre à une sonde périodique ; l’observation des appels système à l’exécution relève de l’eBPF (Falco, Tetragon).
gVisor, Kata Containers, microVM : quand renforcer l’isolation
Section intitulée « gVisor, Kata Containers, microVM : quand renforcer l’isolation »Le compromis central se formule ainsi : le conteneur offre densité, démarrage en millisecondes et absence de surcoût de virtualisation ; on le paie par un noyau partagé dont chaque faille concerne tous les locataires. La décision dépend d’une seule question : le code exécuté est-il maîtrisé ?
- Code maîtrisé (applications internes, images construites et signées par sa propre chaîne) : conteneur classique avec le socle de l’exemple ci-dessus, user namespace ou rootless, noyau patché rapidement. C’est suffisant et c’est la recommandation par défaut.
- Code non maîtrisé (exécution de code soumis par des clients, CI ouverte à des contributions externes, plateforme multi-locataire, agents d’IA qui exécutent du code généré) : le conteneur seul ne suffit pas, il faut un noyau séparé.
Trois options pour ce second cas. gVisor (runtime runsc) intercepte les appels système dans un noyau applicatif écrit en Go, le Sentry, qui n’en transmet qu’un sous-ensemble réduit au vrai noyau ; on paie un surcoût sur les charges riches en appels système et quelques incompatibilités. Kata Containers lance chaque pod dans une VM légère (QEMU, Cloud Hypervisor ou Firecracker) avec son propre noyau, derrière une interface OCI ; on revient à la frontière d’un hyperviseur, avec la virtualisation matérielle comme prérequis sur les nœuds. Firecracker utilisé directement fournit des microVM KVM (Kernel-based Virtual Machine) au périmètre de périphériques volontairement minimal. Aucune de ces solutions ne dispense de patcher : elles déplacent la surface critique vers l’hyperviseur ou le Sentry.
Côté Kubernetes, les Pod Security Standards définissent trois niveaux (Privileged, Baseline, Restricted), appliqués par le contrôleur d’admission Pod Security Admission depuis que PodSecurityPolicy a été retirée en version 1.25. Le niveau Restricted impose précisément le socle décrit ici : runAsNonRoot, retrait de toutes les capacités, allowPrivilegeEscalation: false, seccomp RuntimeDefault. Le RBAC (Role-Based Access Control) et le contrôle d’admission sont traités dans la réduction du RBAC Kubernetes, l’audit d’un cluster dans le guide kube-bench : un pod Restricted ne protège rien si un compte de service peut créer des pods Privileged.
Ce que l’isolation des conteneurs ne garantit pas
Section intitulée « Ce que l’isolation des conteneurs ne garantit pas »- Pas de protection contre les failles noyau atteignables par des appels autorisés : seul le correctif ou un noyau séparé y répond.
- Pas de confidentialité face à l’hôte : root sur l’hôte lit la mémoire et les fichiers de tous les conteneurs. Protéger un secret contre l’administrateur de l’hôte relève des enclaves sécurisées ou du calcul confidentiel.
- Pas d’étanchéité aux canaux auxiliaires : cache CPU et ressources matérielles partagées restent observables (voir les attaques par canaux auxiliaires).
- Pas d’isolation réseau entre conteneurs sur le pont par défaut : ils se joignent librement. La segmentation demande des réseaux dédiés ou des politiques réseau.
- Pas d’intégrité de l’image : le confinement s’applique au code qu’on lui donne, qu’il soit légitime ou piégé. La provenance et la signature relèvent de la chaîne de construction.
Conditions d’exploitation : correctifs runc, containerd et noyau suivis comme des correctifs de sécurité critiques ; détection des conteneurs lancés avec --privileged, Seccomp: 0 ou des montages sensibles ; secrets injectés par fichiers montés plutôt que par variables d’environnement ; et inventaire de tous les accès au socket Docker, traités comme des accès root.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans plafond mémoire posé par cgroup, un conteneur qui fuit ou qu’un attaquant fait gonfler volontairement déclenche le tueur de processus OOM (Out Of Memory) du noyau de l’hôte, qui sacrifie un processus quand la mémoire est épuisée. Celui-ci choisit sa victime parmi tous les processus de la machine : le démon Docker, une base de données voisine ou l’agent de supervision peuvent tomber à la place du fautif. Sans comptabilité par cgroup, la consommation CPU d’un mineur de cryptomonnaie déposé dans un conteneur ne se rattache plus à une charge précise, ce qui retarde sa détection. Sans espace de noms utilisateur, root dans le conteneur crée dans un volume monté depuis l’hôte des fichiers qui appartiennent réellement à root. Si ce volume n’est pas monté avec nosuid, un binaire setuid déposé là devient exécutable par tout utilisateur local de l’hôte qui accède au répertoire : un simple partage de dossier devient alors une élévation de privilèges, sans aucune évasion.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Sur un ordinateur Linux, un conteneur est un programme ordinaire que le système lance avec des réglages particuliers. Le cœur du système, appelé noyau, est le logiciel qui contrôle la mémoire, les fichiers et le réseau ; il est le même pour tous les conteneurs de la machine. Au lancement, un petit outil appelé runc fait trois choses dans l’ordre. D’abord, il réduit ce que le programme voit : sa propre liste de programmes, ses propres fichiers, son propre réseau. Ensuite, il fixe des plafonds de mémoire, de calcul et de nombre de programmes. Enfin, il retire des droits : certains pouvoirs de l’administrateur sont supprimés, une liste interdit des demandes dangereuses adressées au noyau, et un module de sécurité refuse l’accès à certains fichiers. Puis le programme démarre. Le point faible vient du noyau partagé : si un pirate trouve une erreur dans ce noyau ou dans runc, il peut sortir du conteneur et prendre le contrôle de toute la machine, ce qui est déjà arrivé plusieurs fois. Le plus souvent pourtant, la sortie vient d’un mauvais réglage : un conteneur lancé avec tous les droits, l’accès donné au programme qui pilote les conteneurs, ou des dossiers de la machine rendus visibles. Pour exécuter du code inconnu, on ajoute un noyau séparé par conteneur, au prix d’un peu de vitesse.
À lire aussi
- Isolation multi-locataire face à un locataire hostileQuelle frontière poser à chaque couche d'une plateforme mutualisée quand l'un des locataires est hostile, du noyau partagé à l'hôte dédié, et ce que chaque palier laisse passer.
- Linux shell, permissions et processus, le modèle de contrôle d'accèsComment un système Linux décide qui a le droit de faire quoi, du shell qui lance les processus aux identités, permissions et capabilities que ces processus portent.
- Virtualisation réseau, NFV et data planes ouvertsComprendre la virtualisation réseau comme abstraction d’équipements, de fonctions et de chemins : isolation, overlays, NFV, data planes accélérés et plateformes open source.
- Écrire un Dockerfile durci avec condensé, multi-étapes et non rootGuide pas à pas pour durcir un Dockerfile naïf avec image de base épinglée par condensé, construction multi-étapes, utilisateur non root, secrets de construction BuildKit et contrôle en intégration continue.
Pages voisines
La citent
- Isolation multi-locataire face à un locataire hostile
- Debian stable sur serveur, mises à jour de sécurité et rétroportages
- Linux shell, permissions et processus, le modèle de contrôle d'accès
- Rowhammer, Spectre et Meltdown, mécanismes et contre-mesures
Isolation des conteneurs Docker : namespaces, cgroups et évasions
Elle cite
- Lien dans les deux sens :Docker ou Podman en auto-hébergement : root, rootless, isolation
- Lien dans les deux sens :Pollution de variable d'environnement héritée dans un conteneur
- Évasion de VM et isolation matérielle des hyperviseurs
- Hyperviseur Type 1 ou Type 2 : lequel choisir
- Attaques par canaux auxiliaires et secrets
- Durcissement Linux et Windows par minimisation de surface
- EBPF pour observer et bloquer dans le noyau Linux
- Sécurité par capacités contre ACL
: les deux pages se citent l’une l’autre.