
Chaîne d'alimentation et refroidissement d'un datacenter
Chaîne d’alimentation et refroidissement d’un datacenter
Section intitulée « Chaîne d’alimentation et refroidissement d’un datacenter »Un serveur hébergé en colocation dépend d’une chaîne électrique d’une dizaine de maillons, d’une boucle de froid qui n’a pas le droit de s’arrêter plus de quelques minutes, et d’une série de fournisseurs qu’aucun contrat d’hébergement ne cite. Cette page suit ces chaînes de bout en bout, montre où se logent les points uniques de défaillance et dit quoi exiger d’un hébergeur. Position défendue : la redondance d’un site se vérifie pièce par pièce, et elle ne remplace jamais un second site.
→ Lire l’explication complète de la marmotte
Chaîne d’alimentation électrique : de l’arrivée haute tension à la double alimentation A/B
Section intitulée « Chaîne d’alimentation électrique : de l’arrivée haute tension à la double alimentation A/B »Le courant entre par une ou plusieurs arrivées HTA (haute tension A, entre 1 et 50 kV, typiquement 20 kV sur le réseau de distribution français). Deux arrivées n’ont de valeur que si elles viennent de deux postes sources par deux tracés distincts : deux câbles issus du même poste, posés dans la même tranchée, forment une seule arrivée et deux factures. Le référentiel de l’Uptime Institute pousse la logique au bout : il traite le réseau public comme une source économique d’appoint, et les groupes électrogènes comme la seule source sur laquelle le site peut compter.
Des transformateurs abaissent la tension vers 400 V et alimentent le TGBT (tableau général basse tension). En tête de tableau, un inverseur de sources choisit entre le réseau et les groupes. Deux technologies existent, et elles ne rendent pas le même service :
- l’ATS (Automatic Transfer Switch) est électromécanique : il bascule avec une coupure perceptible, que les onduleurs en aval doivent absorber ;
- le STS (Static Transfer Switch) commute par semi-conducteurs en quelques millisecondes entre deux sources synchronisées ; on le trouve plutôt en aval, pour donner deux sources à un équipement qui n’a qu’une alimentation.
Dans les deux cas, l’inverseur est par construction le point où deux voies se rejoignent. Partout où deux voies convergent, il y a un point unique de défaillance, quel que soit le nombre de sources en amont.
Viennent ensuite les onduleurs, ou ASI (alimentation sans interruption). En double conversion, le courant est redressé en continu puis reconverti en alternatif : la charge est alimentée en permanence par l’étage de sortie, les batteries sont raccordées au bus continu, et la perte du réseau ne provoque aucun temps de transfert. Trois détails changent la garantie réelle :
- le bypass statique renvoie la charge directement sur la source brute en cas de défaut ou de surcharge de l’onduleur : la protection disparaît au moment précis où quelque chose va mal ;
- le bypass manuel de maintenance fait de même, volontairement, pendant toute l’intervention ;
- le mode dit économique laisse la charge sur le bypass et ne passe sur l’onduleur qu’à la détection d’un défaut : le rendement s’améliore, le temps de transfert revient. À faire préciser par écrit.
L’autonomie des batteries se compte en minutes, celle des volants d’inertie en dizaines de secondes. Ce n’est pas une réserve d’énergie, c’est un pont vers les groupes. Avec un volant d’inertie, un groupe qui rate son premier démarrage n’aura pas de seconde chance. Les batteries au plomb vieillissent d’autant plus vite que le local est chaud, et leur autonomie réelle ne se connaît que par un essai de décharge ; les batteries au lithium durent plus longtemps et posent un risque d’emballement thermique qui pèse sur le dossier incendie.
Les groupes électrogènes démarrent, se synchronisent s’ils sont plusieurs, puis reprennent la charge, en un temps qui va de la dizaine de secondes à la minute. Leurs pannes sont rarement spectaculaires : batterie de démarrage morte, pompe de transfert de carburant unique entre la cuve et la nourrice, automate de synchronisation commun à tous les groupes, carburant dégradé par l’eau et les bactéries. Un groupe qui tourne un quart d’heure à vide chaque mois prouve surtout qu’il sait tourner un quart d’heure à vide.
En bout de chaîne, les PDU (Power Distribution Unit, les bandeaux de prises de la baie) distribuent deux voies, A et B, aux deux alimentations de chaque serveur. Le schéma suivant se lit en cherchant deux choses : ce qui est commun aux deux voies, et ce qui n’est pas ondulé (la production de froid).
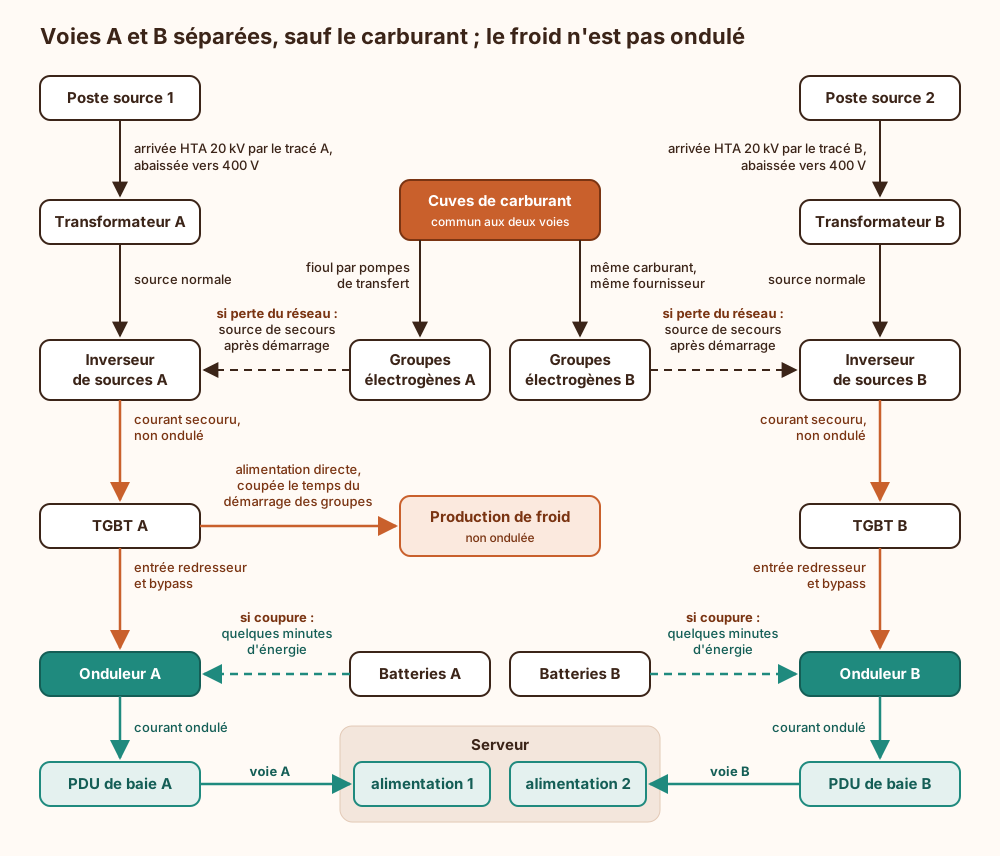
Côté baie, la double alimentation n’est pas un acquis, c’est une discipline. Chaque voie doit pouvoir porter seule la totalité de la charge : chaque voie reste donc sous la moitié de sa capacité, avec de la marge. Une baie chargée à 70 % sur A et 70 % sur B fonctionne à merveille jusqu’à la perte de A, après quoi B disjoncte à son tour. Autres pièges récurrents : les deux cordons branchés sur le même bandeau, les alimentations configurées en mode cumulé plutôt que redondant, l’équipement à alimentation unique branché sur un petit inverseur de baie (qui devient son point unique), et l’arrêt d’urgence de la salle, ou EPO (Emergency Power Off), bouton unique qui coupe les deux voies d’un geste.
La séquence d’une perte de réseau tient en quatre temps. Les batteries portent la charge sans coupure. Les groupes démarrent et l’inverseur bascule. La production de froid, non ondulée, s’est arrêtée et redémarre. Au retour du réseau, tout bascule en sens inverse, et ce second transfert casse aussi souvent que le premier.
Niveaux de redondance N, N+1, 2N, 2N+1 et classement Tier
Section intitulée « Niveaux de redondance N, N+1, 2N, 2N+1 et classement Tier »N désigne la capacité strictement nécessaire à la charge. Le reste est une question de ce qu’on ajoute, et surtout de ce qu’on ne double pas.
| Schéma | Principe | Panne d’un composant | Maintenance d’une voie entière | Angle mort |
|---|---|---|---|---|
| N | Capacité juste suffisante | Coupure | Coupure | Tout |
| N+1 | Un composant de plus que nécessaire | Absorbée | Souvent impossible : la distribution reste unique | Tableau, jeu de barres ou tuyauterie communs |
| 2N | Deux chaînes complètes et indépendantes | Absorbée | Possible, sans redondance pendant l’intervention | Pannes de mode commun, voies chargées au-delà de 50 % |
| 2N+1 | Deux chaînes, chacune en N+1 | Absorbée | Possible, avec redondance résiduelle | Coût, complexité, donc erreurs de manœuvre |
L’Uptime Institute classe les topologies en quatre niveaux, de Tier I à Tier IV. La norme européenne EN 50600, reprise à l’international par la série ISO/IEC 22237, définit quatre classes de disponibilité, déclinées séparément pour l’alimentation (EN 50600-2-2), le contrôle environnemental (EN 50600-2-3) et le câblage télécom (EN 50600-2-4). La correspondance ci-dessous est une approximation de lecture, pas une équivalence officielle.
| Niveau Uptime | Classe EN 50600 la plus proche | Distribution | Maintenance sans arrêt | Tolérance à une panne |
|---|---|---|---|---|
| Tier I | Classe 1 | Une voie, sans redondance | Non | Non |
| Tier II | Classe 2 | Une voie, composants redondants | Partielle | Non |
| Tier III | Classe 3 | Plusieurs voies, une seule suffit | Oui (maintenance concurrente) | Non garantie |
| Tier IV | Classe 4 | Plusieurs voies actives et compartimentées | Oui | Oui, une panne à la fois |
Deux notions portent tout le classement. La maintenance concurrente (Tier III) signifie que chaque composant peut être retiré pour une intervention planifiée sans arrêter la charge ; elle ne dit rien d’une panne qui survient pendant l’intervention. La tolérance aux pannes (Tier IV) signifie qu’une défaillance unique, où qu’elle se produise, n’atteint pas la charge, ce qui impose des voies séparées physiquement et un froid continu.
Ce que ces niveaux ne garantissent pas :
- un taux de disponibilité : les pourcentages à trois décimales qui accompagnent les Tiers dans les plaquettes ne sont pas un critère du référentiel de topologie ;
- la conformité de ce qui a été construit : l’Uptime Institute certifie séparément les documents de conception, l’installation réalisée et l’exploitation. Un certificat de conception atteste des plans. La mention « conçu selon Tier III » sans certificat n’atteste de rien du tout ;
- la qualité de l’exploitation : procédures, formation, effectifs. Or une large part des arrêts implique une erreur de manœuvre ou de procédure, pas la défaillance spontanée d’un composant ;
- la protection contre le sinistre de site (incendie, inondation, interdiction d’accès) et contre les pannes de mode commun.
Le compromis est là. Passer de N+1 à 2N double l’investissement, dégrade le rendement à charge partielle et multiplie les organes à manœuvrer, donc les occasions de se tromper. Ce prix se justifie quand la charge hébergée ne sait pas changer de site. Quand elle sait, l’argent est mieux placé ailleurs (voir la dernière section).
Refroidissement des salles : confinement, eau glacée, liquide et inertie thermique
Section intitulée « Refroidissement des salles : confinement, eau glacée, liquide et inertie thermique »Un serveur restitue en chaleur la quasi-totalité de l’électricité qu’il consomme. L’organisation de base alterne allées froides (faces avant, air aspiré) et allées chaudes (faces arrière, air rejeté). Le confinement ferme l’une des deux par des portes et un toit pour empêcher l’air chaud de revenir en face avant. Sans obturateurs dans les emplacements vides, le confinement reste décoratif : l’air prend le chemin le plus court, et ce chemin passe par le trou.
Deux familles d’armoires traitent l’air. Le CRAC (Computer Room Air Conditioner) embarque son propre compresseur, en détente directe. Le CRAH (Computer Room Air Handler) ne contient qu’une batterie d’eau glacée et des ventilateurs ; le froid vient de groupes froids centralisés. Le free cooling court-circuite le compresseur quand l’air extérieur est assez froid, directement (air extérieur filtré) ou indirectement (échangeur). Le refroidissement adiabatique abaisse la température de l’air en y évaporant de l’eau : excellent pour la facture électrique, au prix d’une dépendance à l’eau. Au-delà de quelques dizaines de kW par baie, l’air ne suffit plus : le direct-to-chip amène un liquide sur des plaques froides posées sur les processeurs (une part de la chaleur reste à évacuer par l’air), l’immersion plonge le serveur entier dans un fluide diélectrique.
Le schéma suivant se lit en repérant ce qui doit rester alimenté pendant une coupure pour que l’eau et l’air continuent de circuler.
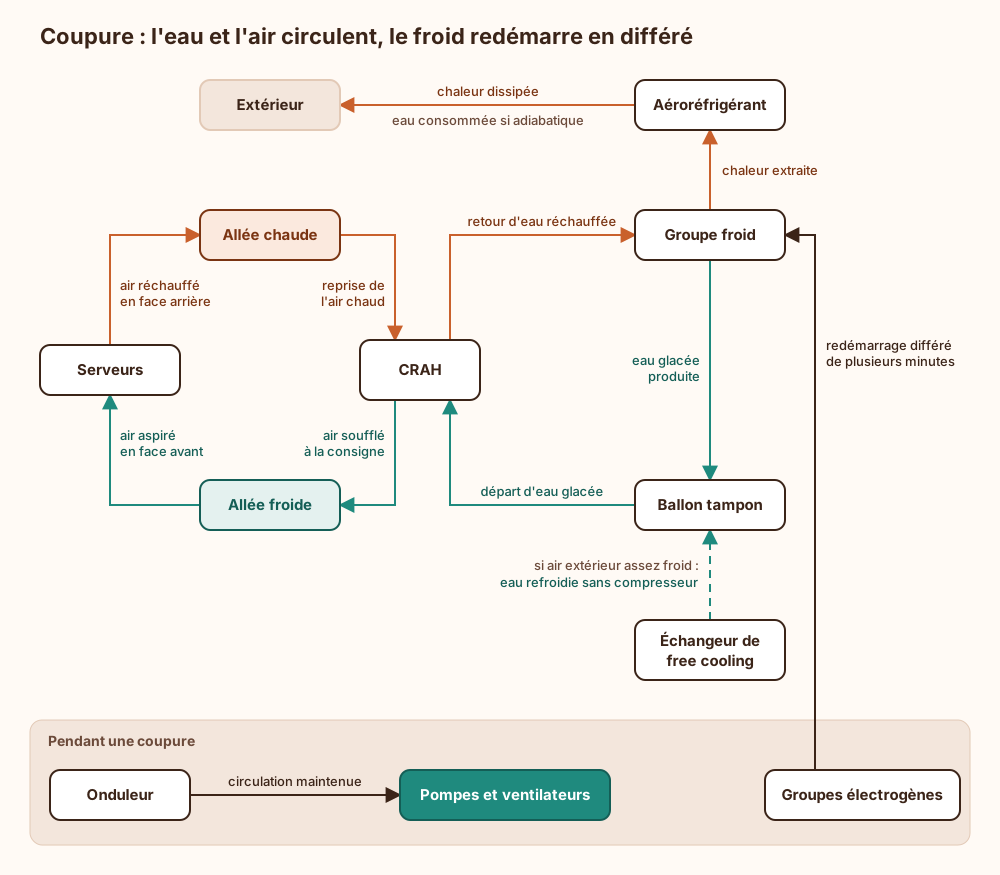
Les plages de température sont celles de l’ASHRAE (American Society of Heating, Refrigerating and Air-Conditioning Engineers) : 18 à 27 °C recommandés, mesurés à l’entrée d’air des équipements, avec des enveloppes admissibles plus larges selon la classe du matériel (jusqu’à 32 °C en A1, 35 °C en A2). La mesure se fait en face avant de la baie, pas au plafond de la salle ni à la reprise de l’armoire.
L’inertie thermique est le point que les contrats oublient. Sans froid, une salle dense peut gagner plusieurs degrés par minute, et les serveurs se mettent en sécurité thermique bien avant que les batteries soient vides. Or un groupe froid ne repart pas à la seconde où le courant revient : ses protections imposent une temporisation de plusieurs minutes. Le froid doit donc être secouru au même titre que le courant : pompes et ventilateurs sur onduleur, ballon tampon d’eau glacée dimensionné pour couvrir le redémarrage, groupes froids repris par les groupes électrogènes. Une salle dont l’électricité est en 2N et le froid en N est une salle en N.
Le PUE (Power Usage Effectiveness), défini par l’ISO/IEC 30134-2, est le rapport annuel entre l’énergie totale du site et l’énergie livrée aux équipements informatiques. Ses limites :
- il dépend du point de mesure (sortie d’onduleur, sortie de PDU, entrée de l’équipement), d’où les catégories de la norme ;
- il se dégrade à charge partielle, donc un site 2N à moitié vide affiche un mauvais chiffre pour de bonnes raisons ;
- la consommation des ventilateurs des serveurs compte au dénominateur : monter la consigne de soufflage améliore le PUE pendant que la consommation totale augmente ;
- il ignore l’eau (indicateur distinct, le WUE, Water Usage Effectiveness) et ne dit rien de la résilience.
Un PUE de conception annoncé sans période ni point de mesure est une intention, pas une mesure. Le lien entre énergie, densité et redondance côté réseau est traité dans la page performance, capacité et sobriété énergétique.
Dépendances externes du site : carburant, eau, télécoms, incendie, accès
Section intitulée « Dépendances externes du site : carburant, eau, télécoms, incendie, accès »L’autonomie d’un site s’arrête là où commencent ses fournisseurs.
Carburant. L’Uptime Institute demande douze heures de stock sur site ; au-delà, tout repose sur le ravitaillement. Lors d’une panne régionale, tous les sites du bassin appellent le même livreur au même moment, et le contrat « prioritaire » est signé par tous. À regarder : autonomie calculée à la charge réelle et non nominale, nombre de fournisseurs, traitement périodique du carburant stocké.
Eau. Refroidissement adiabatique et tours aéroréfrigérantes s’arrêtent avec l’adduction d’eau. Il faut une réserve sur site ou un mode dégradé à sec, et un suivi sanitaire des tours.
Télécoms. Deux opérateurs ne font pas deux chemins. La diversité se juge sur les adductions (deux pénétrations dans le bâtiment, deux chambres de tirage, deux locaux opérateurs) et sur le génie civil en amont. La pelleteuse ne lit pas les contrats de diversité. Les supports eux-mêmes sont décrits dans les pages sur les médias, câbles et fibres et sur les accès terrestres.
Incendie. Détection précoce par aspiration, extinction par gaz ou brouillard d’eau. Les asservissements comptent autant que l’agent extincteur : une détection ferme les clapets, arrête la ventilation et peut couper l’alimentation, ce qui fait d’une fausse alarme une panne de froid. La décharge de gaz suppose une salle étanche et des évents de surpression, et son niveau sonore peut endommager des disques mécaniques.
Accès physique et personnel. Sas, contrôle d’accès individuel, journalisation, vidéo conservée, accompagnement des tiers. Et des gens : un site sans technicien présent la nuit dépend d’un délai de route pour réarmer un disjoncteur.
Automates. Démarrage des groupes, permutation des pompes, bascule des sources : tout est piloté par des automates programmables. Leur programme, leur alimentation et leur réseau sont des dépendances au même titre que le fioul.
Gestion technique du bâtiment, PDU et onduleurs administrables : la surface d’attaque
Section intitulée « Gestion technique du bâtiment, PDU et onduleurs administrables : la surface d’attaque »La GTB (gestion technique du bâtiment, BMS pour Building Management System en anglais) pilote froid, électricité et incendie. Le DCIM (Data Center Infrastructure Management) agrège par-dessus les mesures de la salle. Ces systèmes parlent des protocoles industriels conçus pour des réseaux fermés :
- Modbus, y compris sa variante sur TCP (Transmission Control Protocol), n’a ni authentification ni chiffrement dans sa forme courante (la variante sécurisée par TLS existe, elle reste rare sur le terrain) : qui atteint l’automate écrit dans ses registres ;
- BACnet (Building Automation and Control networks) est dans la même situation dans sa forme classique ; l’extension BACnet Secure Connect ajoute TLS (Transport Layer Security), quand elle est déployée ;
- SNMP (Simple Network Management Protocol) en versions 1 et 2c transmet sa « communauté » en clair ; seule la version 3 authentifie et chiffre.
Les attaques visent la disponibilité, et elles n’ont rien d’exotique : relever une consigne de température, masquer une alarme, commander l’arrêt d’un onduleur par sa carte réseau, éteindre des prises sur un PDU commutable resté avec ses identifiants d’usine. Les portes d’entrée sont connues : télémaintenance des constructeurs, poste de supervision relié à la bureautique, interface web publiée « provisoirement ». Le provisoire est la configuration la plus stable d’un bâtiment.
Contre-mesures, côté exploitant comme côté client :
- cloisonner le réseau industriel (filtrage et segmentation) : aucun routage direct depuis la bureautique ou Internet, télémaintenance par un bastion avec authentification forte et session enregistrée ;
- garder les sécurités en local : un automate doit protéger l’installation sans la supervision, et la supervision ne doit pas pouvoir neutraliser une sécurité câblée ;
- traiter PDU, onduleurs et sondes de baie comme des contrôleurs d’administration : réseau hors bande dédié, SNMP version 3, comptes nominatifs, mots de passe changés et renouvelés, micrologiciels suivis. La logique est celle exposée pour le firmware et les BMC, et la réduction des services exposés suit la page sur le durcissement et la minimisation de surface ;
- synchroniser les horloges : sans heure commune entre automates, PDU et serveurs, la chronologie d’un incident ne se reconstitue pas (voir la sécurité de la synchronisation NTP, NTP pour Network Time Protocol).
Les pannes de mode commun relèvent de la même analyse : deux voies indépendantes sur le papier, une cause unique dans la réalité. Deux voies dans la même gaine technique. Le même micrologiciel sur les onduleurs A et B, mis à jour le même jour. Le même lot de batteries, qui vieillit à l’unisson. Le même fournisseur de fioul, la même cuve, le même automate, le même bouton d’arrêt d’urgence. La redondance protège des pannes aléatoires et indépendantes ; contre une cause commune, elle ne fait que doubler le nombre de victimes.
Exemple : carte des dépendances d’une baie en colocation
Section intitulée « Exemple : carte des dépendances d’une baie en colocation »L’exercice consiste à partir d’une baie et à remonter chaque dépendance jusqu’à un tiers ou jusqu’à un élément partagé. Tout nœud atteint par les deux voies est un point unique, ou un mode commun à faire lever par l’hébergeur.
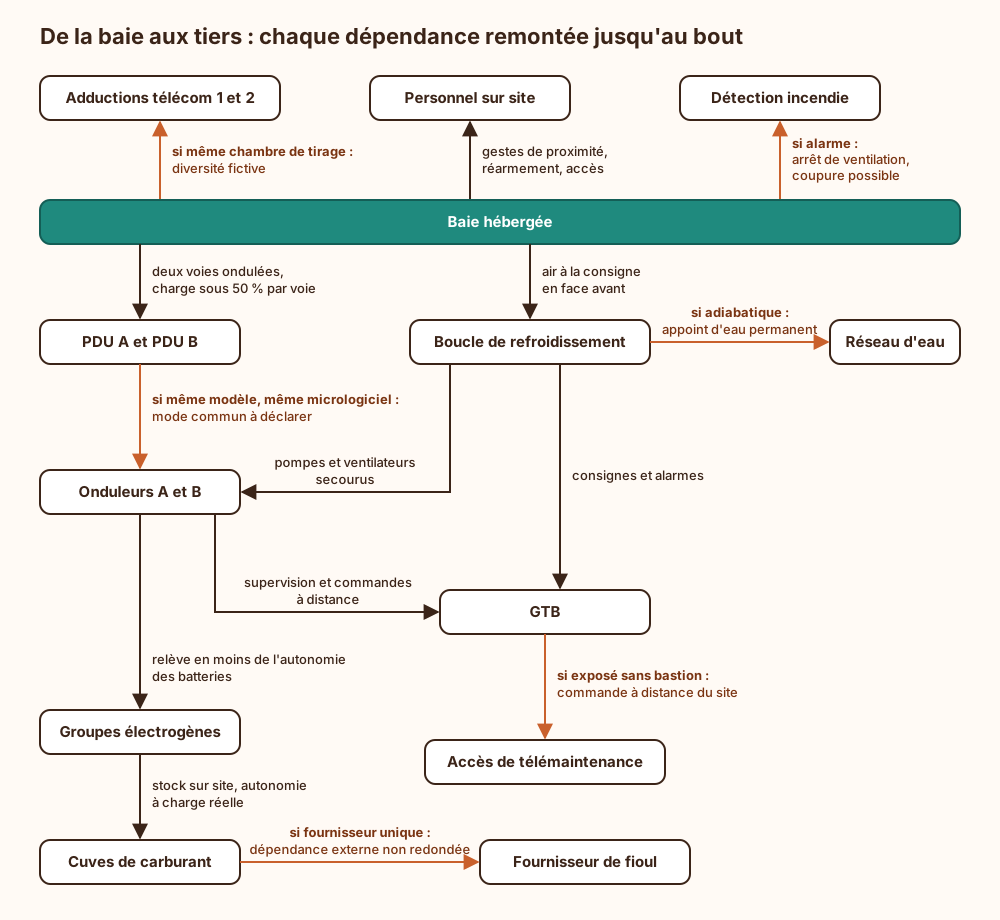
Trois lectures. La GTB est atteinte par l’électricité et par le froid : sa compromission ou sa panne touche les deux chaînes à la fois, c’est le nœud le plus chargé de la carte. Le fournisseur de fioul et le réseau d’eau sont des feuilles sans redondance : l’autonomie du site s’y arrête. Enfin, les conditions entre crochets sont exactement les questions à poser : elles ne figurent dans aucune plaquette et se vérifient sur un plan ou lors d’une visite.
Exigences à poser à un hébergeur et limites d’un site unique
Section intitulée « Exigences à poser à un hébergeur et limites d’un site unique »Avant signature, les prérequis sont documentaires. Il faut obtenir, et lire :
- le schéma unifilaire électrique et le synoptique de la boucle de froid, de l’arrivée HTA à la prise ;
- la nature exacte du certificat (conception, installation construite, exploitation) ou la déclaration de classe EN 50600 par domaine ;
- les tracés des deux voies électriques et des adductions télécom dans le bâtiment ;
- les procès-verbaux des essais des groupes en charge réelle, et d’un essai par coupure effective du réseau, pas seulement d’un démarrage mensuel ;
- l’âge et la technologie des batteries, la date du dernier essai de décharge ;
- l’autonomie carburant à charge réelle, le nombre de fournisseurs, les délais contractuels ;
- le secours du froid : ce qui est ondulé, le volume tampon, le temps de redémarrage ;
- l’état de redondance pendant les maintenances planifiées et le préavis donné ;
- le cloisonnement de la GTB et le régime des accès distants des mainteneurs ;
- les engagements mesurables : température et hygrométrie en face avant, densité par baie, présence humaine, délai des gestes de proximité.
Un hébergeur qui refuse de montrer son unifilaire sous accord de confidentialité vient de répondre à la question.
Côté client, l’exploitation ne se délègue pas entièrement. Vérifier le câblage A/B à l’installation, puis le prouver en coupant une voie avant mise en production. Mesurer le courant par voie et alerter au-dessus de 40 % de la capacité d’une voie. Relever les températures d’entrée d’air par les sondes des serveurs, indépendamment de la supervision de l’hébergeur. Documenter l’ordre de redémarrage après un arrêt complet, parce que l’annuaire qui attend le stockage qui attend l’annuaire est un classique.
Reste la recommandation de fond. La redondance interne protège contre la panne d’un composant. Elle ne protège ni de l’incendie, ni de l’inondation, ni de l’erreur de manœuvre sur l’organe commun, ni de l’interdiction d’accès, ni des modes communs listés plus haut. Deux sites correctement exploités en N+1 avec maintenance concurrente, sur des bassins électriques et des tracés télécom distincts, couvrent davantage de scénarios qu’un site unique en 2N+1, souvent pour un budget du même ordre. La question qui tranche est applicative : la charge sait-elle perdre un site ? Si oui, répartir. Si non (logiciel monolithique, réplication synchrone impossible), payer le 2N et savoir que le sinistre de site reste non couvert. La répartition a ses propres exigences : objectifs de reprise, réplication, bascule testée, traités dans la page continuité, sauvegardes et PRA (PRA pour plan de reprise d’activité) ; et deux sites ne forment pas un quorum, point détaillé dans la page sur le consensus distribué.
Quelle autonomie d’onduleur demander à un hébergeur ?
Section intitulée « Quelle autonomie d’onduleur demander à un hébergeur ? »La question est mal orientée. Quelques minutes suffisent si les groupes démarrent à coup sûr, et aucune autonomie ne suffit s’ils ne démarrent pas. Une heure de batteries ne sert à rien dans une salle dont le froid s’est arrêté : les serveurs se coupent en sécurité thermique avant la fin de la décharge. Les questions qui comptent portent sur les essais en charge des groupes, l’âge des batteries et le secours du froid.
Faut-il superviser soi-même une baie en colocation ?
Section intitulée « Faut-il superviser soi-même une baie en colocation ? »Oui. La supervision de l’hébergeur mesure sa salle, pas la baie, et elle n’est pas un témoin indépendant en cas de désaccord. Des PDU mesurés par voie et les sondes d’entrée d’air remontées par les BMC (Baseboard Management Controller) des serveurs donnent le courant par voie et la température réelle en face avant. Ces mesures servent à l’alerte, à la gestion de capacité et à la reconstitution d’un incident.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans cette lecture de la chaîne, l’hébergement se réduit à une ligne de contrat et à de la confiance. Les deux cordons d’un serveur finissent sur la même voie sans que rien ne le signale, la charge dérive au-delà de ce qu’une voie seule supporte, et la première maintenance de l’hébergeur fait office de test. Une consigne de température modifiée par un accès de télémaintenance oublié passe pour une panne de climatisation, faute de mesure indépendante pour la contredire. Après l’incident, aucune courbe ne permet d’établir si la température ou la tension promises ont été tenues. Et le plan de reprise repose sur un site dont personne n’a regardé par où entrent le courant et la fibre.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Un centre de données reçoit son électricité du réseau public, par des câbles à haute tension. Des transformateurs abaissent cette tension, puis le courant traverse des appareils à batteries avant d’atteindre les ordinateurs. Quand le réseau public tombe, les batteries prennent le relais sans aucune coupure, mais elles ne tiennent que quelques minutes. Ce délai sert à démarrer de gros moteurs diesel, qui produisent le courant tant qu’il reste du carburant dans les cuves. Pour qu’une panne n’arrête rien, tout ce parcours est construit en double, et chaque ordinateur est branché sur les deux parcours en même temps. Les ordinateurs transforment presque toute l’électricité en chaleur. Des machines soufflent de l’air frais devant eux, récupèrent l’air chaud derrière et envoient la chaleur dehors, souvent grâce à de l’eau froide qui circule dans des tuyaux. Si ce froid s’arrête, la salle devient trop chaude en quelques minutes et les ordinateurs s’éteignent d’eux-mêmes, même si le courant est revenu. Le froid doit donc être secouru lui aussi. Le bâtiment dépend encore de livraisons de carburant, d’eau, de câbles de communication, de la protection contre le feu et de techniciens présents. Les automates qui pilotent l’ensemble sont reliés à un réseau : une personne malveillante qui y entre peut couper le courant ou le froid. Enfin, un incendie ou une inondation touche tout le bâtiment d’un coup, et seul un second bâtiment, situé ailleurs, protège contre cela.
À lire aussi
- Sécuriser un SCADA d’eau et d’énergieSécurisation des systèmes SCADA d’eau et d’énergie face aux protocoles historiques, aux effets physiques des commandes et aux exigences de NIS2.
- Calculer le coût d’un LLM local à grande échelleMéthode de dimensionnement et d’optimisation économique d’un déploiement local de modèles de langage à grande échelle.
Pages voisines
La citent
Chaîne d'alimentation et refroidissement d'un datacenter
Elle cite
- Lien dans les deux sens :Médias, câbles, fibres, radio et équipements physiques
- Lien dans les deux sens :Performance, QoS, capacité et sobriété énergétique
- Lien dans les deux sens :Continuité, sauvegardes, PRA/PCA et haute disponibilité
- Accès terrestres, fibre, cuivre et réseaux câblés
- Comment sécuriser firmware UEFI, réseau et BMC
- Consensus distribué et tolérance aux pannes byzantines
- Durcissement Linux et Windows par minimisation de surface
- Filtrage, segmentation, NAC et Zero Trust
- Sécuriser NTP contre le spoofing et la dérive d’horloge
- VPN, tunnels, bastions et interconnexions protégées
- Sécuriser une interface HMI industrielle Windows
: les deux pages se citent l’une l’autre.