
Non-interférence et contrôle de flux d'information en pratique
Non-interférence et contrôle de flux d’information en pratique
Section intitulée « Non-interférence et contrôle de flux d’information en pratique »Le contrôle d’accès décide qui peut lire une donnée ; il ne dit rien de ce que devient l’information une fois lue. Le contrôle de flux d’information suit la donnée jusqu’à ses sorties, et la non-interférence en donne la formulation exacte : ce qui est secret ne doit rien changer à ce qu’un observateur non habilité peut voir. Position défendue ici : c’est le bon outil de raisonnement pour toute frontière entre niveaux de sensibilité, et un mauvais objectif à imposer partout dans le code.
→ Lire l’explication complète de la marmotte
Contrôle d’accès et contrôle de flux d’information : le treillis de Denning
Section intitulée « Contrôle d’accès et contrôle de flux d’information : le treillis de Denning »Un processus habilité à lire un fichier secret et à écrire dans un fichier public ne viole aucune règle d’accès. Il lui suffit pourtant de faire les deux à la suite pour que le secret soit public. Chaque accès est légitime, la composition fuit. Le contrôle d’accès répond à la question du videur (qui entre) ; le contrôle de flux, ou IFC (Information Flow Control), répond à celle qui fâche : où l’information peut-elle aller ensuite, copies, dérivés et déductions compris.
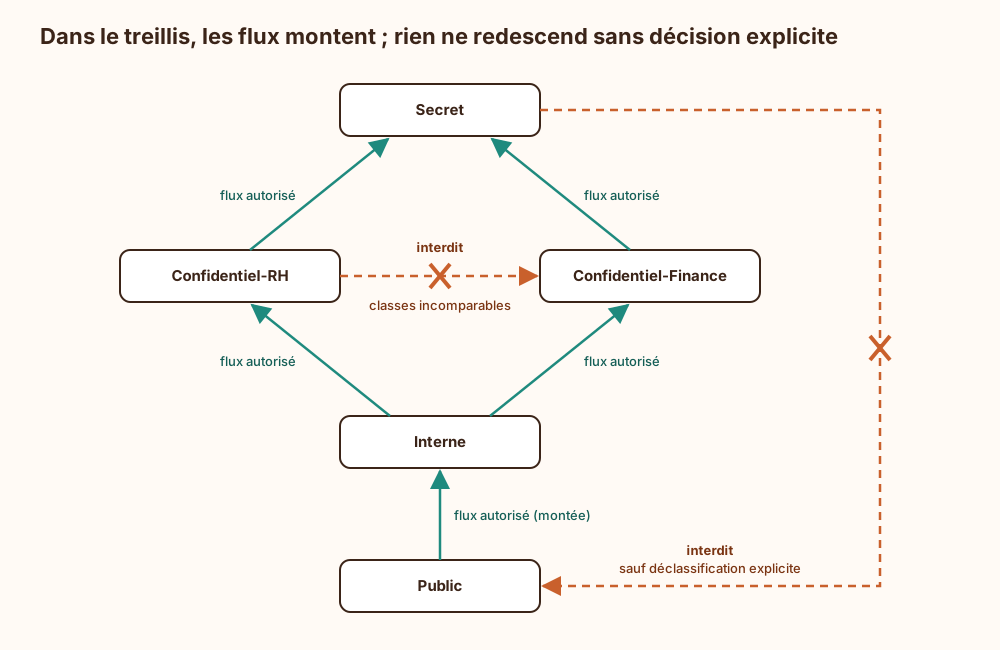
Denning (1976) pose le cadre qui sert encore : un ensemble fini de classes de sécurité, une relation « peut couler vers », et un opérateur de combinaison qui donne la classe d’une donnée calculée à partir de deux autres. L’ensemble forme un treillis : deux classes quelconques ont toujours une plus petite borne supérieure. Conséquence pratique : mélanger une donnée RH et une donnée Finance produit une donnée dont la classe est définie sans débat, celle qui domine les deux.
Le schéma montre un treillis à cinq classes : les flux montent, deux classes de même hauteur peuvent être incomparables, et rien ne redescend sans décision explicite.
Le modèle de Bell-LaPadula applique la même idée par des règles d’accès : pas de lecture vers le haut, pas d’écriture vers le bas. La page Modèles Bell-LaPadula, Biba et Clark-Wilson le détaille. La différence tient au point de contrôle. Bell-LaPadula surveille des opérations de lecture et d’écriture sur des objets. Le contrôle de flux s’intéresse au comportement observable de bout en bout, y compris à ce qui passe sans aucune écriture.
Un treillis à catégories grossit comme l’ensemble des parties : dix catégories indépendantes donnent 1024 combinaisons par niveau. À l’usage, un treillis à quinze étiquettes finit le plus souvent en deux classes réelles : « tout le monde » et « demander à quelqu’un ». Mieux vaut partir de deux à quatre niveaux, avec peu de catégories, et les faire respecter.
Exemple de flux explicite et de flux implicite
Section intitulée « Exemple de flux explicite et de flux implicite »Denning et Denning (1977) montrent qu’un compilateur peut certifier un programme en vérifiant chaque affectation. Ils distinguent deux familles de flux. Le flux explicite est une copie : public := secret. Le flux implicite passe par le flot de contrôle : aucune copie, mais la valeur écrite dépend de la branche prise, donc du secret testé.
Le schéma suit un programme de trois lignes : un test sur secret, puis public := 1 dans une branche et public := 0 dans l’autre.
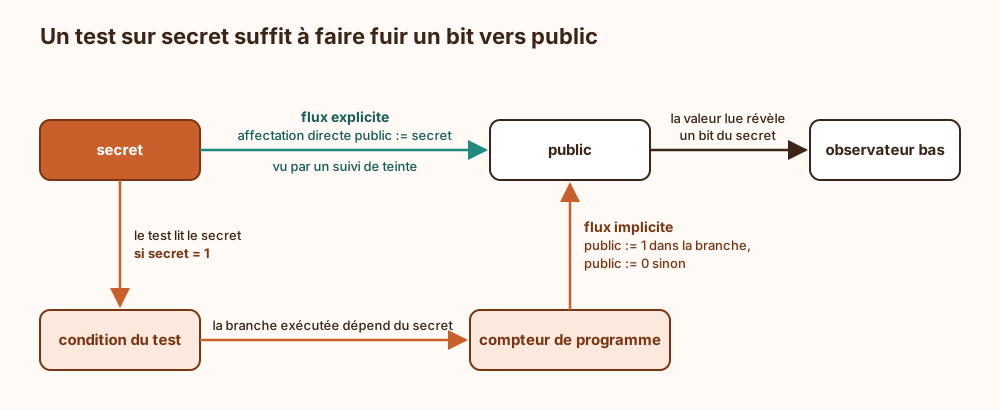
Aucune ligne ne copie secret, et pourtant public en révèle un bit. Dans une boucle, le mot entier y passe. La certification statique traite le cas en étiquetant le compteur de programme. Dans une branche gouvernée par un secret, le contexte est « haut » et toute écriture vers une variable basse est refusée.
Le piège est dans la branche non prise. Si public vaut 0 par défaut et que seule la branche secret = 1 y écrit, l’absence d’écriture informe autant que l’écriture. Un moniteur dynamique ne voit que la branche exécutée. Il ne peut donc pas se contenter de propager des marques : il doit interdire toute écriture basse en contexte haut, ou arrêter le programme. Un outil qui « suit les données » sans traiter ce cas suit les copies, pas l’information.
Non-interférence de Goguen et Meseguer : deux exécutions comparées
Section intitulée « Non-interférence de Goguen et Meseguer : deux exécutions comparées »Goguen et Meseguer (1982) formulent la propriété sur une machine à états et des groupes d’utilisateurs. Un groupe n’interfère pas avec un autre si retirer toutes ses commandes de l’historique ne change rien à ce que l’autre observe. La version courante dans les travaux sur les langages est équivalente dans l’esprit et plus maniable : deux exécutions qui partent des mêmes entrées basses et ne diffèrent que par les entrées hautes doivent produire les mêmes sorties basses.
Le schéma montre le protocole mental : même programme, deux secrets différents, un seul observateur.
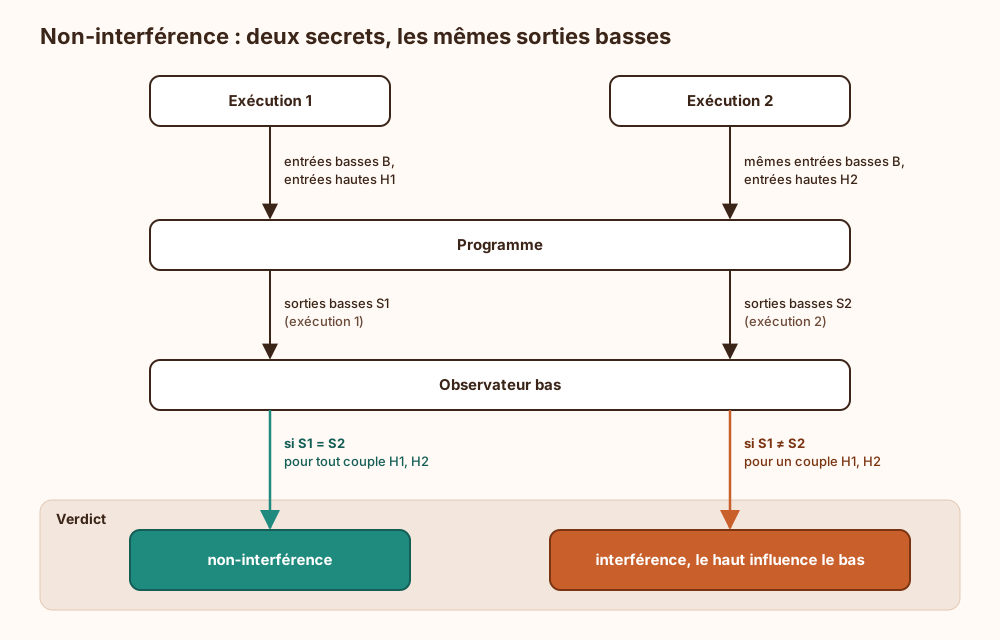
Trois conséquences à garder en tête.
La propriété est duale. En confidentialité, le haut ne doit pas influencer le bas. En intégrité, les entrées non fiables ne doivent pas influencer les sorties de confiance. C’est le même treillis retourné, comme Biba retourne Bell-LaPadula. Une injection SQL (Structured Query Language) est une violation de non-interférence en intégrité : une entrée non fiable détermine la structure d’une requête de confiance.
La propriété est une hyperpropriété, au sens de Clarkson et Schneider : elle porte sur des ensembles d’exécutions, ici des paires, et non sur chaque exécution prise seule. Une trace isolée ne peut ni la prouver ni la réfuter. D’où une règle d’exploitation sèche : aucun journal, aucune sonde regardant une seule exécution de production ne « détecte une violation de non-interférence ». La vérification passe par une preuve, par un système de types, ou par l’analyse du programme composé avec une copie de lui-même (auto-composition), qui ramène la comparaison de deux exécutions à une propriété sur une seule.
La propriété est relative à un observateur. « Mêmes sorties basses » dépend entièrement de ce qu’on appelle une sortie. C’est là que tout se joue.
Variantes de non-interférence selon ce que l’attaquant observe
Section intitulée « Variantes de non-interférence selon ce que l’attaquant observe »Chaque variante est un contrat sur les capacités d’observation de l’attaquant. Un résultat de non-interférence cité sans sa variante ne dit rien.
| Variante | Ce que l’attaquant observe | Ce qui passe quand même | Où on la rencontre |
|---|---|---|---|
| Insensible à la terminaison | Sorties basses des exécutions qui terminent | Le fait de terminer ou non ; un bit par exécution sans sorties intermédiaires, davantage avec | La plupart des systèmes de types de sécurité |
| Sensible à la terminaison | Sorties basses et terminaison | La durée | Systèmes de types qui restreignent les boucles gouvernées par un secret |
| Sensible au temps | Sorties, terminaison, instants et durées | Tout ce que le modèle de machine ignore (cache, prédiction) | Code cryptographique à temps constant |
| Probabiliste (programmes concurrents) | Distribution des sorties selon l’ordonnancement | Canaux que le modèle d’ordonnanceur n’inclut pas | Analyse de programmes à fils d’exécution multiples |
| Intransitive | Flux directs interdits, flux autorisés via un médiateur désigné | Ce que le médiateur laisse sortir | Noyaux de séparation, passerelles |
| Spéculative | Effets des exécutions transitoires sur l’état microarchitectural | Canaux physiques hors modèle | Défenses contre Spectre |
Le reste, canaux cachés de stockage ou de temps, canaux auxiliaires physiques, tombe hors du modèle par construction. La page Quantifier les fuites par théorie de l’information traite la mesure quantitative de ce qui fuit, et Attaques par canaux auxiliaires et secrets le versant matériel.
La variante intransitive mérite l’attention de l’architecte. La non-interférence classique est transitive : si A peut couler vers B et B vers C, alors A peut couler vers C. Une passerelle exige autre chose : le haut peut atteindre le bas uniquement en passant par un composant désigné, jamais directement. L’idée remonte à Haigh et Young, et Rushby (1992) en a donné la formulation de référence. C’est la description formelle de toute architecture à guichet.
Déclassification et modèle décentralisé d’étiquettes
Section intitulée « Déclassification et modèle décentralisé d’étiquettes »La non-interférence stricte interdit à peu près tout ce qu’un système fait pour gagner sa vie. Vérifier un mot de passe produit une réponse publique qui dépend du secret. Chiffrer produit un chiffré public calculé à partir du message et de la clé. Publier un salaire moyen révèle une fonction de données confidentielles. Un système réel n’est donc jamais non interférent. Il l’est à des déclassifications près, et sa sécurité vaut exactement ce que valent ces exceptions.
Sabelfeld et Sands classent la déclassification selon quatre dimensions :
- Quoi : quelle information sort. Le résultat d’une comparaison, pas le mot de passe ; une moyenne sur au moins N individus, pas une ligne.
- Qui : quelle autorité décide de la sortie, et qui peut influencer ce qui sort.
- Où : à quel endroit du code ou du système, et entre quels niveaux.
- Quand : à quel moment. Après paiement, après expiration d’un embargo, après un nombre borné d’essais.
Un point de déclassification qui ne fixe que le « où » est une porte de service. Le cas d’école est la vérification de mot de passe sans limite d’essais. Chaque réponse lâche une fraction de bit, légitimement, et la somme des réponses lâche le secret. La dimension « qui » porte un piège plus fin. Si un attaquant influence l’entrée d’une fonction de déclassification, il choisit ce qui sort. La parade porte un nom, la déclassification robuste (Zdancewic et Myers) : la décision de déclassifier et son contenu ne doivent pas dépendre de données de basse intégrité. Confidentialité et intégrité se retrouvent liées, que cela plaise ou non.
Le modèle décentralisé d’étiquettes, ou DLM (Decentralized Label Model), de Myers et Liskov répond à la question « qui ». Chaque étiquette porte des politiques de la forme « propriétaire : lecteurs autorisés ». Un morceau de code ne peut relâcher que les politiques des entités dont il détient l’autorité. Plusieurs propriétaires qui ne se font pas confiance partagent ainsi un calcul sans autorité centrale de classification. Jif, extension de Java, en est la mise en œuvre de référence.
Mises en œuvre du contrôle de flux : types, teinte, système d’exploitation, matériel
Section intitulée « Mises en œuvre du contrôle de flux : types, teinte, système d’exploitation, matériel »Prérequis communs, quelle que soit la technique : une classification qui existe avant le projet, un inventaire des sources et des puits, un modèle d’observateur écrit, et une base de confiance qui applique les étiquettes (compilateur, moteur d’exécution, noyau ou matériel). Dernier prérequis, le plus souvent oublié : les étiquettes doivent survivre aux frontières. Une donnée sérialisée, mise en file ou stockée en base sans son étiquette ressort vierge. C’est une déclassification par omission.
| Approche | Grain | Flux implicites | Ce que ça coûte | Limite principale |
|---|---|---|---|---|
| Types de sécurité (Jif, FlowCaml) | Variable, expression | Couverts à la compilation | Annotations, langage dédié | Déclassifications nombreuses, écosystème restreint |
| Teinte statique | Chemin source vers puits | En général ignorés | Faux positifs, modélisation des bibliothèques | Aveugle face à du code hostile |
| Teinte dynamique (mode taint de Perl, TaintDroid) | Valeur à l’exécution | Ignorés | Surcoût d’exécution | Ne voit que les chemins exécutés |
| Étiquettes au niveau du système (Asbestos, HiStar, Flume) | Processus, fichier, canal | Couverts par le gros grain | Découpage de l’application en processus | Contamination des étiquettes |
| Temps constant | Instruction | Interdits par discipline | Performance, lutte contre le compilateur | Dépend du modèle de processeur |
| Noyau de séparation (seL4) | Partition | Couverts par la preuve | Configuration statique | Canaux temporels hors preuve |
Types de sécurité. Volpano, Smith et Irvine (1996) reformulent la certification de Denning en système de types et prouvent sa correction : un programme bien typé est non interférent. Le résultat est beau et la facture est connue : annoter tout le code, isoler chaque déclassification, renoncer à la plupart des bibliothèques. À réserver à un composant étroit qui manipule plusieurs niveaux à la fois, pas à un système d’information entier.
Analyse de teinte. C’est le contrôle de flux que tout le monde pratique sans le nommer. Le mode taint de Perl (-T) marque les entrées externes et refuse leur usage dans une commande tant qu’elles n’ont pas été filtrées. C’est de l’intégrité, et le filtre joue le rôle dual de la déclassification, l’endossement. Les analyseurs statiques font de même entre sources et puits. TaintDroid suit les données personnelles sur Android à l’exécution, pour un surcoût annoncé par ses auteurs d’environ 14 % sur un banc de calcul pur, et ne suit que les flux explicites. La teinte convient quand le code est honnête et buggé (injections, fuites accidentelles), car l’information y voyage par copie. Elle ne tient pas face à du code écrit pour fuir. Trois lignes de flux implicite suffisent à la contourner.
Système d’exploitation. Asbestos, HiStar et Flume étiquettent processus, fichiers et canaux de communication. Un processus ne lit une donnée haute qu’en portant lui-même l’étiquette haute, et il la garde ensuite tout entier, flux implicites inclus, puisque le grain est le processus. Le prix s’appelle la contamination des étiquettes : à force de lire, tout monte, et le système converge vers un état où tout est secret, menu de la cantine compris. D’où des applications découpées en petits processus et des déclassificateurs dédiés. Cette discipline se marie bien avec la sécurité par capacités.
Temps constant. La programmation à temps constant est une non-interférence dont l’observateur voit le temps. En pratique, il voit la suite des branchements pris et des adresses mémoire accédées. Trois règles en découlent : pas de branchement sur un secret, pas d’indice de tableau secret, pas d’instruction à durée variable sur un secret. Le compilateur n’a signé aucun de ces engagements. Il peut transformer une sélection sans branchement en saut conditionnel. La vérification se fait donc sur le binaire, pas sur le source.
Microarchitecture. Spectre est une violation de non-interférence au niveau du processeur. L’exécution spéculative emprunte des chemins que la sémantique séquentielle n’emprunte jamais et laisse dans le cache une trace qui dépend du secret. Un programme prouvé non interférent dans le modèle séquentiel fuit dans le modèle réel. Le détail est sur la page Rowhammer, Spectre et Meltdown.
Noyaux de séparation. seL4 dispose d’une preuve de non-interférence intransitive (Murray et collègues, 2013) : les partitions ne s’influencent que par les canaux configurés. Trois réserves : la preuve vaut pour une configuration statique donnée, elle repose sur des hypothèses matérielles, et elle exclut explicitement les canaux temporels. Les méthodes formelles prouvent ce qu’elles modélisent, rien de plus.
Surface d’attaque et limites de la non-interférence
Section intitulée « Surface d’attaque et limites de la non-interférence »Le mécanisme s’attaque par ses bords, rarement par son centre.
- Les déclassificateurs. C’est le seul endroit où le haut descend légalement, donc la cible. Attaques connues : multiplication des requêtes pour additionner des fuites partielles, et contrôle de l’entrée pour choisir ce qui sort. Contre-mesures : budget d’essais ou de requêtes, entrées de haute intégrité uniquement, code court et revu.
- Les canaux hors modèle. Temps, cache, contention de ressources, messages d’erreur, taille des réponses. Contre-mesure : les nommer dans le modèle d’observateur, puis les réduire (temps constant, isolation matérielle, bourrage) ou assumer leur débit.
- La base de confiance. Le compilateur, le moniteur, le noyau qui appliquent les étiquettes. Un bug de mémoire dans le moniteur annule tout. Un langage à sûreté mémoire aide ici, sans donner le contrôle de flux par lui-même.
- Les frontières sans étiquette. Sérialisation, base de données, cache partagé, file de messages. L’étiquette s’y perd et la donnée ressort basse.
Ce que la non-interférence ne garantit pas :
- la confidentialité face à un observateur plus fort que celui du modèle ;
- la justesse de la classification initiale ;
- la justesse de la politique de déclassification ;
- la disponibilité : un moniteur qui arrête le programme sur un flux interdit transforme une fuite en déni de service, et l’arrêt lui-même est observable ;
- la quantité qui fuit : la propriété dit zéro ou pas zéro, jamais combien.
Les produits de DLP (Data Loss Prevention) qui cherchent des motifs dans le trafic sortant n’ont ni étiquettes ni sémantique. Ce n’est pas du contrôle de flux, c’est de la devinette avec un tableau de bord : utile contre l’erreur d’envoi, sans effet contre une donnée transformée avant de sortir.
Contrôle de flux en architecture : passerelles, diodes et points de déclassification
Section intitulée « Contrôle de flux en architecture : passerelles, diodes et points de déclassification »La recommandation tient en quatre gestes. Raisonner en flux à chaque frontière entre domaines de sensibilité différente. Garder le treillis petit. Rendre le sens montant physique quand l’enjeu le justifie. Nommer chaque point où l’information redescend. Le compromis central : la non-interférence offre une garantie de bout en bout qui ne dépend pas de la bonne conduite du code, et elle se paie en étiquetage, en exceptions et en rigidité. Entre domaines, ce prix est acceptable, car les flux y sont peu nombreux et lents à changer. À l’intérieur d’une application ordinaire, il ne l’est presque jamais.
Le schéma décrit une architecture à deux domaines : tout monte par la diode, rien ne descend hors du guichet.
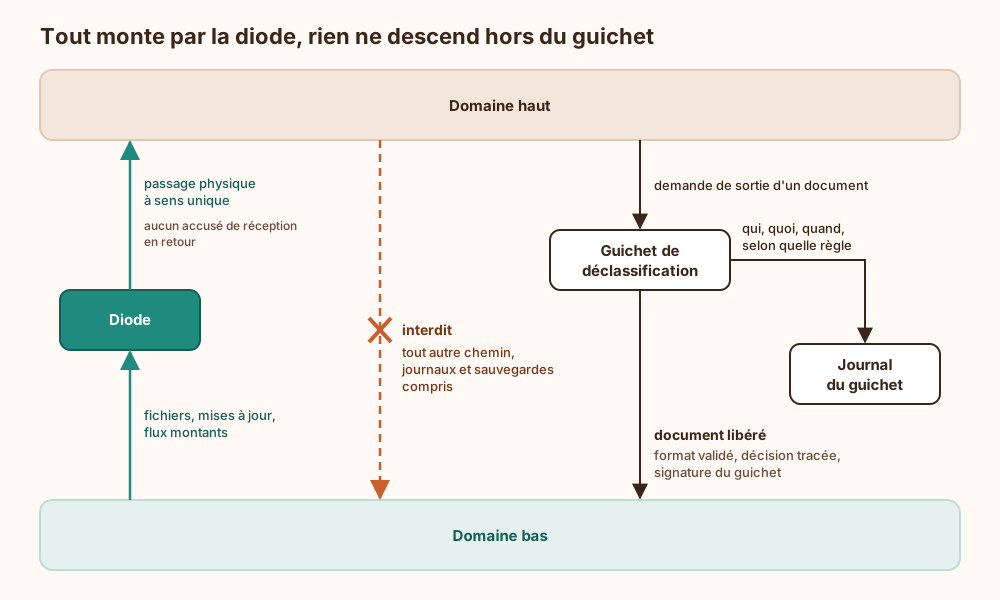
Une diode matérielle impose la non-interférence du haut vers le bas par la physique. Aucun protocole à accusé de réception ne la traverse, TCP (Transmission Control Protocol) en tête : un acquittement est un flux descendant, donc un canal. Il faut des relais de chaque côté, un transport sans retour, de la redondance pour compenser l’absence de retransmission. Il faut aussi accepter que l’émetteur ne sache jamais si le message est arrivé. Un « mode diode » qui laisse passer des acquittements est un pare-feu avec une plaquette.
Le sens montant règle la confidentialité et ouvre la question duale. Ce qui entre dans le domaine haut y arrive avec une intégrité basse. Les mises à jour et fichiers montants passent donc par un endossement : vérification de signature, validation de format, sas d’analyse.
Conditions d’exploitation, là où les architectures réelles fuient :
- Journaux et supervision. Les journaux d’un domaine haut sont hauts. Les envoyer vers un puits central situé plus bas crée un flux descendant permanent, monté par l’équipe d’exploitation en toute bonne foi. Collecte dans le domaine, ou export par le guichet.
- Sauvegardes. Une sauvegarde hérite de la classe la plus haute de ce qu’elle contient. Une infrastructure de sauvegarde mutualisée se retrouve au sommet du treillis, avec les accès qui vont avec. Une restauration qui ne restitue pas les étiquettes déclassifie par accident.
- Clés. La clé de signature du guichet prouve qu’une sortie est légitime. Elle vit dans un module matériel, se renouvelle selon un calendrier connu, et sa compromission oblige à revoir toutes les sorties signées avec elle. Les clés qui chiffrent les données hautes sont hautes.
- Administration. Un administrateur qui opère les deux domaines depuis le même poste est un canal bidirectionnel à haut débit, avec presse-papiers.
- Registre des déclassifications. Chaque point de sortie reçoit un nom, un propriétaire et ses quatre dimensions (quoi, qui, où, quand). Le registre se révise à chaque changement de flux.
Reste la lecture critique des promesses. Devant un « aucune fuite possible », trois questions suffisent : quel observateur, quels canaux hors modèle, quelles déclassifications. Un fournisseur qui ne sait répondre à aucune ne vend pas une preuve, il vend un adjectif. Pour l’hébergement mutualisé face à un voisin hostile, la page Isolation multi-locataire face à un locataire hostile reprend la question côté isolation.
La non-interférence peut-elle se tester ?
Section intitulée « La non-interférence peut-elle se tester ? »Pas sur une exécution. On peut la réfuter par paires : rejouer le même scénario avec deux secrets différents et comparer ce que voit l’observateur bas, durées comprises. Les tests statistiques de temps constant procèdent ainsi. Une paire qui diffère prouve la fuite. Mille paires identiques ne prouvent rien.
Une analyse de teinte sans alerte vaut-elle non-interférence ?
Section intitulée « Une analyse de teinte sans alerte vaut-elle non-interférence ? »Non. Elle établit qu’aucune copie directe ne relie les sources modélisées aux puits modélisés. Les flux implicites, les bibliothèques non modélisées et les canaux temporels restent hors champ. C’est une bonne garantie contre les injections et les fuites accidentelles, pas une propriété de bout en bout.
Un langage à sûreté mémoire apporte-t-il le contrôle de flux ?
Section intitulée « Un langage à sûreté mémoire apporte-t-il le contrôle de flux ? »Non. La sûreté mémoire, décrite sur la page Rust et la sécurité mémoire par construction, empêche de lire ce qui n’a pas été accordé. Elle ne contraint pas la destination d’une valeur lue légitimement. Elle protège en revanche le moniteur qui applique les étiquettes, ce qui en fait un prérequis raisonnable.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans raisonnement en flux, une architecture peut respecter toutes ses règles d’accès et laisser descendre ses données par des chemins que personne n’a dessinés : un export, un cache partagé, un journal, une copie de sauvegarde. Chaque étape est autorisée, donc aucune alerte ne se déclenche. Les déclassifications existent quand même, mais anonymes : pas de propriétaire, pas de budget, pas de trace, donc pas d’audit possible. En cas d’incident, la question « jusqu’où cette donnée a-t-elle pu aller » reste sans réponse, faute d’étiquettes et de points de passage identifiés. Enfin, les promesses d’étanchéité des fournisseurs sont acceptées telles quelles, puisque personne n’a de grille pour demander face à quel observateur elles tiennent.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Protéger une donnée en décidant qui peut la lire ne suffit pas. Celui qui l’a lue peut ensuite l’écrire ailleurs, ou produire un résultat qui la trahit. Le contrôle de flux d’information règle ce problème en donnant un niveau à chaque donnée (public, interne, secret) et en imposant une règle : l’information peut monter vers un niveau plus protégé, jamais redescendre. La règle s’applique aux copies directes, et aussi aux fuites indirectes : si un programme fait un choix selon un secret, puis écrit un résultat public différent selon ce choix, le résultat révèle une partie du secret. Pour vérifier qu’un système est étanche, on compare deux exécutions identiques sauf pour les secrets. Si une personne non autorisée voit exactement la même chose dans les deux cas, les secrets n’influencent rien de visible. Cette vérification demande toujours deux exécutions, donc regarder une seule exécution ne prouve rien. En pratique, il faut parfois laisser sortir un peu d’information, par exemple répondre oui ou non à un mot de passe. Ces sorties volontaires doivent être peu nombreuses, limitées et enregistrées. Quand elles sont oubliées, ou quand l’attaquant mesure quelque chose d’imprévu comme la durée d’un calcul, le secret s’échappe alors que toutes les règles d’accès sont respectées.
À lire aussi
- JavaScript et SQL côté web, ce qu'il faut savoir des deux langagesCe qu'il faut connaître du modèle d'exécution de JavaScript et de SQL pour lire un code web, relire une revue de sécurité ou interpréter un rapport de scan.
Pages voisines
La citent
Non-interférence et contrôle de flux d'information en pratique
Elle cite
- Lien dans les deux sens :Modèles Bell-LaPadula, Biba et Clark-Wilson
- Lien dans les deux sens :Sécurité par capacités contre ACL
- Méthodes formelles TLA+ et Coq (Rocq), où elles valent leur coût
- Quantifier les fuites par théorie de l'information
- Attaques par canaux auxiliaires et secrets
- Isolation multi-locataire face à un locataire hostile
- Rowhammer, Spectre et Meltdown, mécanismes et contre-mesures
- Rust et la sécurité mémoire par construction, garanties et limites
- DLP prévention des pertes de données : détection et limites
- Exploiter une injection SQL aveugle temporelle
: les deux pages se citent l’une l’autre.