
Isolation multi-locataire face à un locataire hostile
Isolation multi-locataire face à un locataire hostile
Section intitulée « Isolation multi-locataire face à un locataire hostile »Une plateforme multi-locataire à forte adversité interne héberge un adversaire qui a déjà un compte valide et exécute son code à côté de celui des autres. La question n’est plus d’empêcher l’entrée, mais de savoir quelle frontière tient à chaque couche (calcul, matériel, plan de contrôle, données) et ce qu’elle laisse passer. Position défendue ici : pour du code non maîtrisé, un noyau partagé n’est pas une frontière, et le plan de contrôle reste la cible la plus rentable quel que soit le palier choisi.
→ Lire l’explication complète de la marmotte
Modèle de menace : locataire hostile et multi-locataire coopératif
Section intitulée « Modèle de menace : locataire hostile et multi-locataire coopératif »Deux situations portent le même nom et n’ont presque rien en commun.
Le multi-locataire coopératif réunit des équipes d’une même organisation, qui se font confiance et dont le code passe en revue. La séparation sert à éviter les accidents : espaces de noms, RBAC (Role-Based Access Control), quotas, politiques réseau. Une séparation logique suffit, et dépenser plus serait du théâtre.
Le multi-locataire à forte adversité interne part de l’hypothèse inverse. L’adversaire est un locataire légitime : client hostile, compte compromis, équipe interne non maîtrisée, code soumis par des tiers, tâche de CI (Continuous Integration) ouverte au public, agent d’IA (intelligence artificielle) qui exécute du code qu’il vient de générer. Ses capacités sont celles de n’importe quel client :
- exécuter du code arbitraire dans son périmètre, autant de fois qu’il le souhaite ;
- appeler l’API (Application Programming Interface) de la plateforme avec un jeton valide ;
- lire la documentation, mesurer les temps de réponse, créer et détruire des ressources en boucle ;
- recommencer avec un autre compte quand le premier est fermé.
Ce modèle exclut deux adversaires traités ailleurs : l’attaquant externe sans compte, et l’opérateur de la plateforme lui-même. Contre ce dernier, la réponse relève des enclaves et de l’exécution confidentielle, conçues pour protéger un locataire de son hébergeur, pas les locataires entre eux.
Le compromis central tient en une ligne : chaque palier d’isolation gagné se paie en densité, en temps de démarrage et en charge d’exploitation. La mutualisation finance la plateforme ; l’isolation la rend habitable. Tout le travail d’architecture consiste à ne payer l’isolation forte que là où l’adversité l’exige.
Échelle des frontières de calcul : conteneur, gVisor, microVM, VM, hôte dédié
Section intitulée « Échelle des frontières de calcul : conteneur, gVisor, microVM, VM, hôte dédié »Une frontière de calcul se juge à une seule chose : la taille et la complexité de l’interface que le code hostile peut solliciter pour atteindre ce qui est partagé.
Le schéma suivant se lit de haut en bas : à chaque palier, ce que le code du locataire touche directement, puis ce qui se trouve derrière.
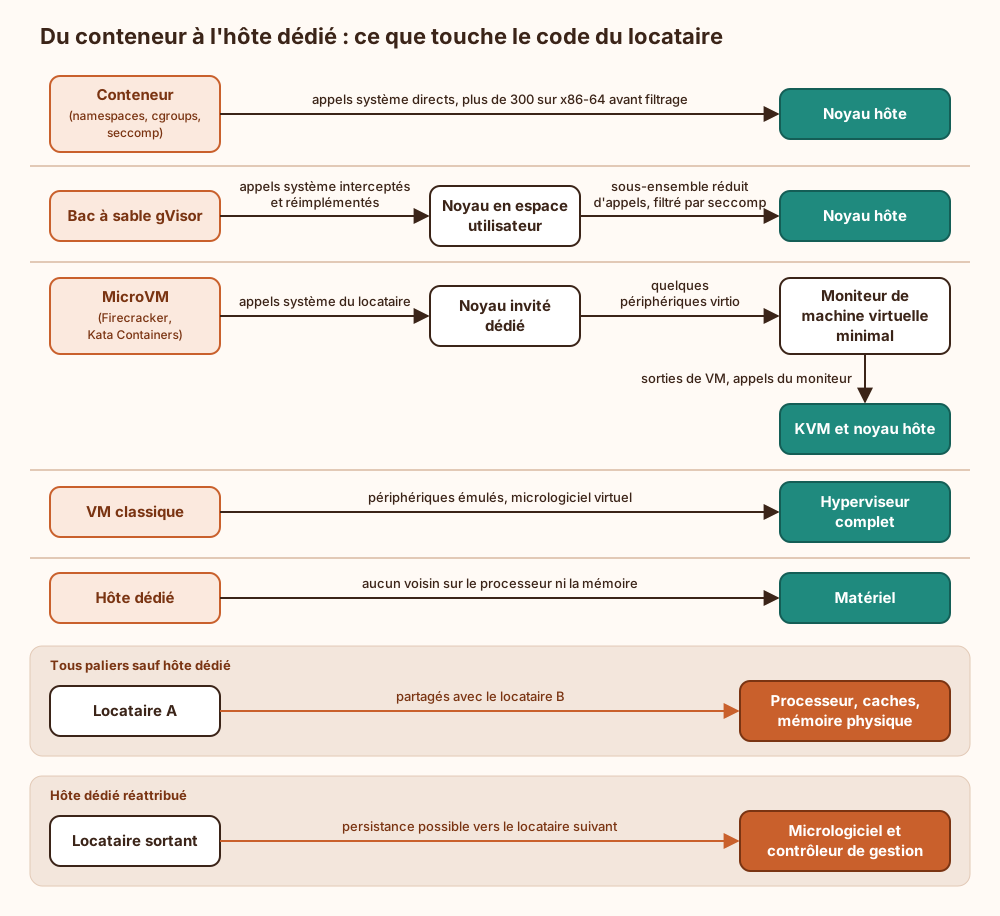
Conteneur. Les namespaces et les cgroups (control groups) sont des vues et des compteurs posés sur un noyau unique ; seccomp (secure computing mode) retire une partie des appels système. Le détail est sur la page isolation des conteneurs. Face à un voisin hostile, une élévation de privilèges locale dans le noyau devient une évasion vers tous les locataires de l’hôte, et ces failles sortent à un rythme régulier.
gVisor. Un noyau écrit en Go, exécuté en espace utilisateur, intercepte les appels système de la charge et les réimplémente. Le noyau hôte ne voit plus qu’un sous-ensemble restreint d’appels, émis par ce noyau intermédiaire et non par le code hostile. Il faut désormais deux failles enchaînées au lieu d’une. Le prix : un surcoût sur les charges gourmandes en appels système et en E/S (entrées/sorties), et une compatibilité incomplète avec les programmes qui tutoient le noyau de près.
MicroVM. Firecracker et Kata Containers donnent à chaque charge son propre noyau invité, au-dessus de KVM (Kernel-based Virtual Machine). L’interface exposée se réduit aux sorties de VM (Virtual Machine) et à une poignée de périphériques virtio. Firecracker pousse la logique au bout : un moniteur écrit en Rust, sans émulation de matériel historique, enfermé à son tour par un processus geôlier. Le démarrage reste bien sous la seconde, ce qui rend le modèle viable pour des tâches éphémères.
VM classique. Même frontière matérielle, mais avec un hyperviseur généraliste et son catalogue de périphériques émulés, qui constitue l’essentiel de la surface d’évasion de VM. Le choix du type d’hyperviseur déplace cette surface sans l’annuler.
Hôte dédié. Plus aucun voisin sur le processeur ni sur la mémoire. Restent le réseau, le stockage, le plan de contrôle, et un piège propre à ce palier : une machine physique réattribuée transporte son micrologiciel et son contrôleur de gestion d’un locataire au suivant.
| Palier | Ce qui reste partagé | Attaque qui passe | Coût |
|---|---|---|---|
| Conteneur | Noyau hôte entier, matériel | Élévation de privilèges noyau, conteneur privilégié ou montage de l’hôte, canaux auxiliaires | Quasi nul, densité maximale |
| gVisor | Noyau hôte derrière une surface réduite, matériel | Faille du noyau utilisateur enchaînée à une faille des appels restants, canaux auxiliaires | Surcoût sur appels système et E/S, compatibilité partielle |
| MicroVM | KVM, moniteur minimal, matériel | Faille de KVM ou d’un périphérique virtio, canaux auxiliaires matériels | Un noyau invité en mémoire par charge, virtualisation matérielle exigée |
| VM classique | Hyperviseur, périphériques émulés, matériel | Faille d’émulation de périphérique, canaux auxiliaires matériels | Démarrage plus lent, image système complète à maintenir |
| Hôte dédié | Micrologiciel, réseau, stockage, plan de contrôle | Persistance dans le micrologiciel, plan de contrôle | La machine entière, quel que soit son taux d’occupation |
Le réseau suit la même échelle sans s’y confondre : un noyau invité par locataire ne dit rien des flux entre locataires. Refus par défaut entre périmètres, sortie filtrée et réseau virtuel par locataire relèvent de l’isolation réseau multi-tenant, à poser en parallèle du palier de calcul.
Le verdict : le conteneur est un outil d’empaquetage et de gestion de ressources. Le présenter comme une frontière de sécurité contre du code hostile revient à confondre une cloison de bureau paysager avec un mur porteur, sous prétexte que les deux délimitent un espace.
SMT, caches et déduplication mémoire : ce qui reste partagé sous la frontière
Section intitulée « SMT, caches et déduplication mémoire : ce qui reste partagé sous la frontière »Une microVM impeccable tourne toujours sur un processeur que le voisin utilise aussi. Trois ressources méritent une décision explicite.
Le cœur physique. Avec le SMT (Simultaneous Multithreading), deux fils d’exécution logiques partagent les structures internes d’un même cœur. Plusieurs familles de failles d’exécution spéculative fuient précisément à cet endroit ; la page Rowhammer, Spectre et Meltdown en détaille les classes. Deux réponses possibles : désactiver le SMT sur les hôtes mutualisés, ou activer l’ordonnancement par cœur (core scheduling, présent dans Linux depuis la série 5.14), qui interdit à deux tâches de locataires différents d’occuper en même temps les deux fils d’un cœur. La seconde préserve la capacité quand les locataires ont des charges à plusieurs fils ; elle ne vaut rien si l’étiquetage des tâches par locataire est faux.
Les caches. Le cache de dernier niveau est commun à tous les cœurs d’un processeur. Les attaques par canaux auxiliaires qui l’exploitent demandent de la colocalisation et de la patience, deux choses qu’un locataire hostile possède en quantité. Aucune configuration ne ferme ce canal ; seul le placement le fait.
La mémoire. La déduplication de pages (KSM, Kernel Samepage Merging) fusionne les pages identiques de plusieurs VM. Le temps d’écriture sur une page fusionnée révèle que le voisin détient la même, ce qui suffit à sonder son contenu. Sur un hôte à locataires hostiles, la déduplication se désactive, sans débat. Même traitement pour l’échange sur disque non chiffré et pour toute ressource non remise à zéro à la réattribution : blocs de stockage, mémoire d’accélérateur graphique, disques éphémères.
La conséquence d’architecture est le placement par locataire : l’ordonnanceur doit connaître l’appartenance de chaque charge et refuser certaines cohabitations. Un ordonnanceur qui optimise uniquement le remplissage place tôt ou tard la charge hostile sur le cœur voisin de la cible, et il le fait avec le sentiment du devoir accompli.
Plan de contrôle mutualisé : identifiant de locataire et adjoint confus
Section intitulée « Plan de contrôle mutualisé : identifiant de locataire et adjoint confus »Les évasions de VM font les conférences. Les fuites entre locataires, elles, passent le plus souvent par l’API. Le plan de contrôle est mutualisé par construction, il détient des droits sur tous les locataires, et il accepte des requêtes de chacun d’eux.
Le défaut type est l’adjoint confus (confused deputy), décrit par Norm Hardy en 1988 : un service privilégié exécute pour le compte d’un demandeur une action que ce demandeur n’a pas le droit de faire, parce qu’il vérifie ses propres droits et non ceux du demandeur. La page sur la sécurité par capacités en donne le cadre théorique. Sa forme la plus banale côté API porte un nom dans le classement OWASP (Open Worldwide Application Security Project) : BOLA (Broken Object Level Authorization), première entrée du Top 10 API 2023. La requête est authentifiée, l’identifiant d’objet appartient à un autre locataire, et personne ne compare les deux. Le contrôle d’accès par objet est traité sur la page BOLA et contrôle d’accès des API.
Le schéma suivant montre où l’identifiant de locataire doit être vérifié : à chaque saut, et pas seulement à l’entrée.
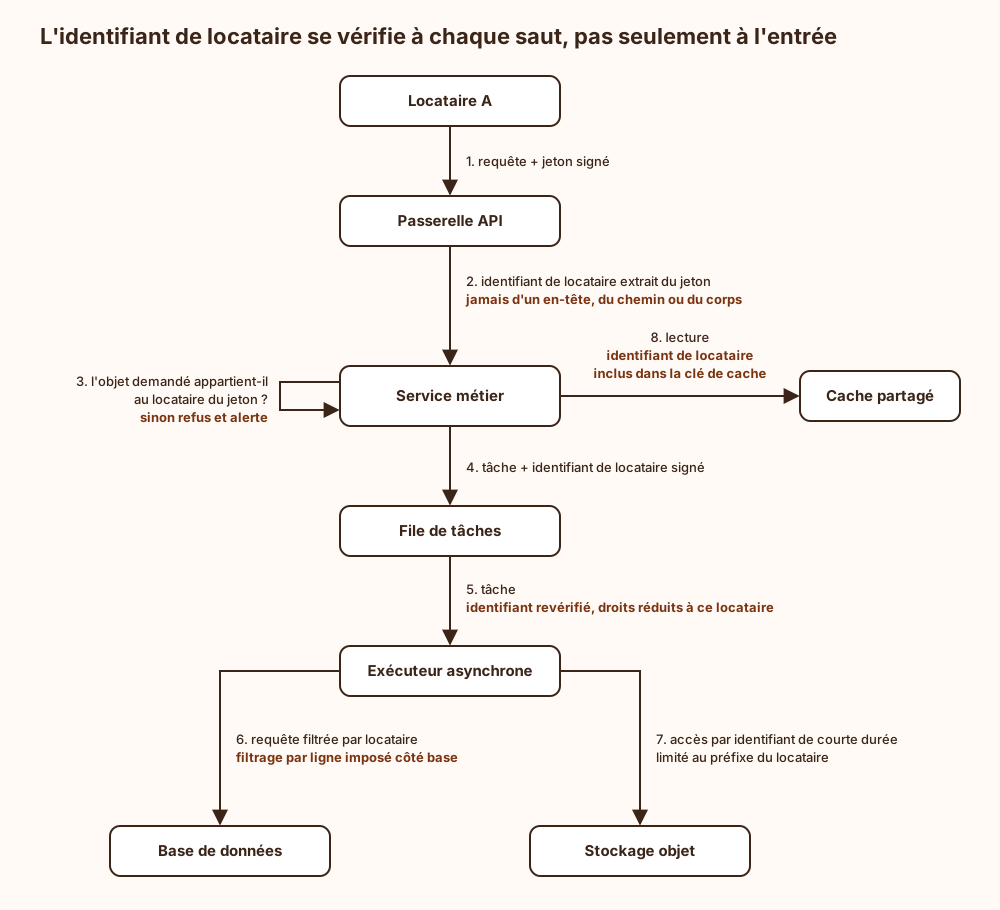
Les règles qui en découlent, toutes vérifiables en revue de code :
- l’identifiant de locataire vient du jeton authentifié, jamais d’un paramètre fourni par le client ;
- chaque service interne revérifie l’appartenance de l’objet ; une passerelle qui filtre pour tout le monde fabrique un seul point de défaillance ;
- les traitements asynchrones perdent le contexte par défaut : une tâche de fond qui tourne avec le compte de service global est un adjoint confus en attente d’instructions ;
- une clé de cache sans identifiant de locataire sert tôt ou tard la réponse de l’un à l’autre ;
- avec un filtrage par ligne fondé sur une variable de session et un groupement de connexions, la variable doit être posée pour la durée de la transaction uniquement, sans quoi elle suit la connexion jusqu’à l’emprunteur suivant.
Deux cibles annexes complètent le tableau. Les identités de nœud d’abord : sur un orchestrateur, l’agent du nœud détient des identifiants permettant de lire les secrets de toutes les charges qui y sont planifiées, et le service de métadonnées de l’hébergeur délivre l’identité de la machine à qui sait le joindre. Une évasion sur un nœud partagé donne donc les secrets des voisins de nœud ; d’où des groupes de nœuds par locataire et un filtrage de l’accès aux métadonnées. Les comptes d’opérateurs ensuite : outils de support avec usurpation d’identité, comptes d’administration permanents, chaîne de déploiement de la plateforme. Un accès d’opérateur doit être temporaire, borné à un locataire, justifié, et journalisé dans un journal que l’opérateur ne peut pas réécrire.
Stockage, clés, journaux et métriques par locataire
Section intitulée « Stockage, clés, journaux et métriques par locataire »Trois modèles de stockage coexistent : base partagée avec colonne de locataire, schéma par locataire, instance par locataire. Le premier coûte le moins et repose entièrement sur l’absence d’oubli dans chaque requête ; il n’est défendable qu’avec un filtrage imposé par la base elle-même. Le troisième seul borne réellement une injection.
Une clé par locataire est nécessaire et régulièrement survendue. Une KEK (Key Encryption Key) par locataire, détenue dans un HSM (Hardware Security Module) ou un service de gestion de clés, qui enveloppe des DEK (Data Encryption Key) par objet, apporte trois choses : l’effacement cryptographique d’un locataire sortant, la borne sur ce qu’expose un vol de support ou de sauvegarde, et une trace d’usage par locataire. Elle n’apporte rien contre un adjoint confus : le service qui déchiffre pour le mauvais demandeur déchiffre très bien. La politique d’usage de la clé doit donc lier l’opération au locataire authentifié, pas à l’identité du service. Le cloisonnement côté module est traité sur la page partitions d’un HSM multi-tenant.
Les journaux et métriques fuient par des chemins moins surveillés :
- un message d’erreur qui cite l’identifiant ou le nom d’une ressource d’un autre locataire ;
- des identifiants séquentiels, qui révèlent le volume d’activité des voisins et se prêtent à l’énumération ;
- un tableau de bord dont le filtre par locataire est appliqué côté navigateur ;
- une métrique agrégée (latence d’un service commun, taux de remplissage) qui, observée assez longtemps, trahit l’activité d’un voisin, ce que formalise la théorie des canaux cachés.
Règle de conception : tout enregistrement d’observabilité porte l’identifiant de locataire dès l’émission, et le filtrage se fait côté serveur.
Voisin bruyant et épuisement de ressources : quotas et limites
Section intitulée « Voisin bruyant et épuisement de ressources : quotas et limites »Dans un contexte coopératif, le voisin bruyant est un problème de performance. Avec un locataire hostile, c’est une attaque en disponibilité à coût marginal nul pour celui qui la mène.
Les limites par charge (processeur, mémoire, nombre de processus, débit disque) couvrent la partie visible. Trois angles morts reviennent constamment :
- les ressources du noyau hôte mal comptabilisées : tables de suivi de connexions, verrous globaux, files d’E/S communes. Un palier à noyau partagé expose ces ressources, un noyau invité les enferme ;
- le plan de contrôle lui-même : créer des objets en boucle sature le magasin de configuration bien avant de saturer un processeur. Il faut des quotas en nombre d’objets et une limitation de débit par locataire sur l’API, avec des files équitables plutôt qu’une limite globale que le premier abuseur consomme pour tous ;
- les services communs : résolution de noms, registre d’images, passerelle de sortie, journalisation. Chacun doit avoir sa limite par locataire, sinon l’inondation de journaux d’un seul locataire devient la panne d’observabilité de tous.
Une limite globale sans répartition par locataire ne protège personne : elle garantit seulement que la panne sera partagée équitablement.
Cloisonnement en cellules et rayon d’impact
Section intitulée « Cloisonnement en cellules et rayon d’impact »Une cellule est une copie complète et autonome de la plateforme (plan de contrôle, plan de données, stockage), à laquelle un sous-ensemble de locataires est affecté. Une compromission, une saturation ou un mauvais déploiement s’arrête à la frontière de la cellule.
Ce que le découpage apporte : un rayon d’impact borné, des déploiements progressifs cellule par cellule, et la possibilité de créer une cellule réservée à un locataire (le plus sensible ou le plus suspect, selon l’humeur). Ce qu’il coûte : une couche de routage en amont, qui redevient un composant partagé et doit rester la plus mince possible (une table locataire vers cellule, rien d’autre) ; une migration entre cellules à outiller ; et autant de plans de contrôle à maintenir que de cellules.
Le découpage en cellules ne remplace aucun palier d’isolation. Il répond à la question que les paliers laissent ouverte : combien de locataires tombent quand la frontière cède. La conduite à tenir ce jour-là relève de la gestion de crise multi-tenant.
Choix du palier d’isolation selon le niveau d’adversité
Section intitulée « Choix du palier d’isolation selon le niveau d’adversité »La décision dépend de trois questions, dans cet ordre : qui écrit le code exécuté, le locataire est-il identifiable et engagé, et la fuite vers un voisin est-elle rattrapable.
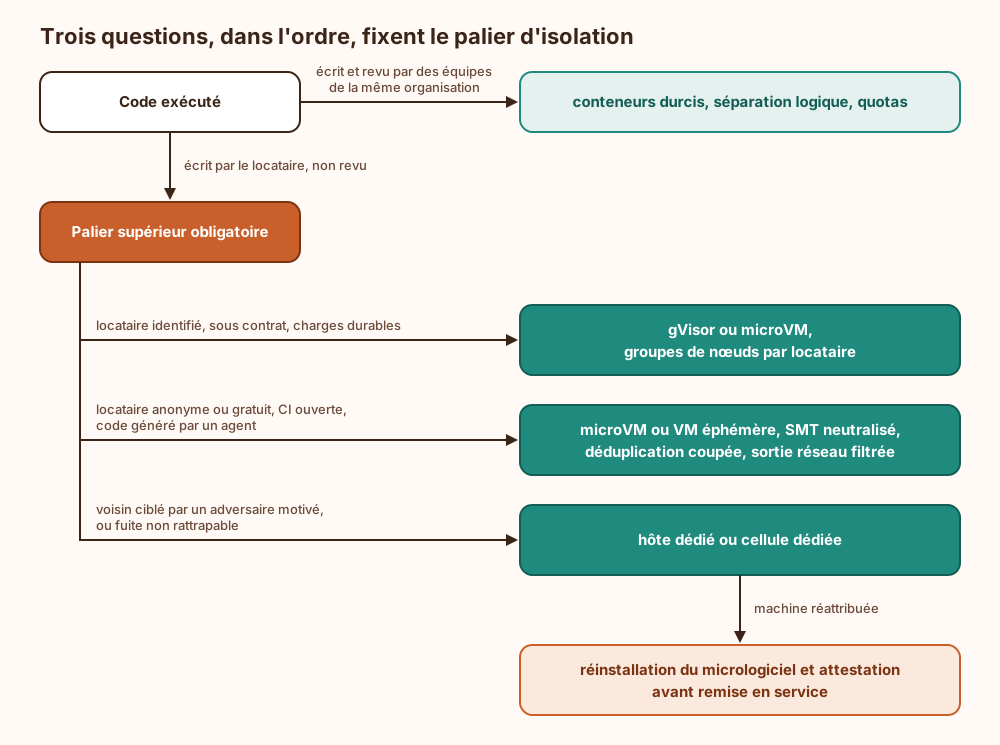
Les conditions de validité de chaque branche :
- Conteneurs durcis : valable tant que personne d’extérieur ne pousse de code. Le jour où une fonction de plugins, de scripts utilisateur ou d’exécution d’agent apparaît, la branche change, et ce changement arrive rarement avec une annonce.
- gVisor contre microVM : les deux se valent face à un locataire identifié. Le choix dépend d’une question pratique : la charge a-t-elle besoin d’une compatibilité complète avec le noyau et de bonnes E/S (microVM), ou la plateforme tourne-t-elle sur des machines sans virtualisation matérielle disponible (gVisor) ? Face à un locataire anonyme, la microVM l’emporte : sa frontière est matérielle et son interface plus étroite.
- MicroVM éphémère : une instance par tâche, détruite à la fin, jamais réutilisée entre deux locataires. Une microVM recyclée pour gagner du temps de démarrage est un conteneur avec un surcoût.
- Hôte dédié : le seul palier qui ferme les canaux auxiliaires matériels entre locataires. Il se justifie quand un adversaire a une raison de viser un voisin précis. Sur une machine réattribuée, le micrologiciel et le contrôleur de gestion doivent être réinstallés puis vérifiés par attestation.
Exemple : classe d’exécution microVM et placement par locataire sur Kubernetes
Section intitulée « Exemple : classe d’exécution microVM et placement par locataire sur Kubernetes »Prérequis : des nœuds exposant la virtualisation matérielle (machines physiques, ou VM avec virtualisation imbriquée), containerd configuré avec l’adaptateur Kata Containers, et un contrôle d’admission capable de refuser un pod. L’extrait déclare une classe d’exécution microVM liée aux nœuds d’un locataire, puis une charge qui l’utilise.
apiVersion: node.k8s.io/v1kind: RuntimeClassmetadata: name: microvm-locataire-ahandler: kata-fc # nom du runtime déclaré dans containerd (kata-qemu, kata-clh, kata-fc)overhead: podFixed: memory: "160Mi" # noyau invité + moniteur : valeur à mesurer, puis décomptée du quota cpu: "250m"scheduling: nodeSelector: locataire: a # la charge ne part que sur les nœuds du locataire A tolerations: - key: locataire # ces nœuds portent la teinte locataire=a:NoSchedule operator: Equal value: a effect: NoSchedule---apiVersion: v1kind: Podmetadata: name: tache-non-maitrisee namespace: locataire-aspec: runtimeClassName: microvm-locataire-a automountServiceAccountToken: false # pas de jeton d'API dans du code non maîtrisé restartPolicy: Never # une microVM par tâche, jamais recyclée containers: - name: tache image: registry.example/locataire-a/tache:1.0 resources: limits: cpu: "1" memory: "512Mi"Trois points font la différence entre cet extrait et une isolation réelle. Le sélecteur de nœud et la teinte (taint) vont par paire : le premier retient la charge chez elle, la seconde empêche celles des autres d’y venir. Le champ runtimeClassName est renseigné par le locataire, donc par l’adversaire : sans règle d’admission qui impose la classe attendue pour chaque espace de noms, il suffit de l’omettre pour retomber sur le noyau partagé. Enfin, la vérification tient en une commande : la version du noyau vue depuis la charge doit différer de celle du nœud.
Limites de l’isolation et conditions d’exploitation
Section intitulée « Limites de l’isolation et conditions d’exploitation »Ce que l’ensemble ne garantit pas :
- l’absence de canal auxiliaire en dessous de l’hôte dédié : le placement réduit le débit du canal, il ne le ramène pas à zéro ;
- la disponibilité : les quotas bornent l’abus, pas la panne d’un composant commun ;
- la protection contre l’opérateur : aucune frontière entre locataires ne protège de celui qui administre l’hôte ;
- la sécurité du locataire lui-même : une clé d’API publiée par son propriétaire franchit toutes les frontières par la grande porte ;
- la permanence : une frontière prouvée un jour ne dit rien de la configuration du lendemain.
Les conditions d’exploitation qui maintiennent le tout :
- Correctifs de l’hôte. Noyau, hyperviseur, moniteur et microcode forment la base de confiance de tous les locataires. Le délai d’application d’un correctif d’évasion est la vraie mesure du palier choisi. Il faut donc savoir vider un hôte (migration à chaud ou purge des charges éphémères) sans négociation préalable avec chaque client.
- Rotation. Clés par locataire, identités de nœud, identifiants de courte durée vers le stockage : une durée de vie brève transforme une fuite en fenêtre. Les accès d’opérateur expirent seuls.
- Supervision par locataire. Un refus d’accès à l’objet d’un autre locataire n’est pas une erreur applicative, c’est un signal : il se compte, se corrèle et déclenche une alerte au-delà d’un seuil. Même traitement pour les appels système refusés et les sorties de VM anormales, observables par eBPF (extended Berkeley Packet Filter) côté hôte.
- Sauvegarde et reprise. Sauvegardes chiffrées avec la clé du locataire, restauration possible pour un seul locataire, et essai de restauration qui vérifie qu’aucune donnée voisine ne revient avec.
- Preuve par essais inter-locataires. Deux locataires témoins, détenus par la plateforme, tentent en continu de se lire l’un l’autre à chaque couche : API, réseau, stockage, cache, journaux, métriques. Toute réussite est un incident. Une isolation qui n’est pas testée de cette façon repose sur un schéma d’architecture, document réputé pour sa résistance aux attaques.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans frontière pensée pour un voisin hostile, la plateforme hérite d’une propriété désagréable : chaque défaut du noyau, du service d’administration ou d’un cache devient un défaut de tous les locataires à la fois. Un correctif de sécurité de l’hôte se transforme en urgence générale, faute de pouvoir dire quels locataires étaient exposés. Un compte abusif ne peut plus être expulsé sans arrêter ses voisins de machine. Après une intrusion, l’absence d’identifiant de locataire dans les journaux interdit de borner le périmètre : la notification part à tous les clients, par défaut. Et la restauration d’un seul locataire devient impossible sans ramener les autres en arrière.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Une plateforme partagée fait tourner sur les mêmes machines les programmes de plusieurs clients, appelés locataires. Le cas difficile est celui où l’un d’eux cherche à nuire aux autres alors qu’il possède un compte parfaitement valide. La protection se construit sur plusieurs niveaux. Premier niveau : séparer l’exécution. Quand les programmes de deux locataires s’adressent au même noyau (le logiciel central qui pilote la machine), une seule erreur dans ce noyau permet de passer de l’un à l’autre. Chaque locataire reçoit donc sa propre machine virtuelle, c’est-à-dire un ordinateur simulé doté de son propre noyau, voire une machine physique entière. Deuxième niveau : le matériel. Même séparés, deux locataires peuvent utiliser le même processeur, et l’un peut deviner des informations en mesurant des durées de calcul ; la plateforme évite donc de les placer sur les mêmes composants. Troisième niveau : le service qui reçoit les demandes de tous. À chaque demande et à chaque étape, il doit vérifier que l’objet demandé appartient bien à celui qui le demande. Quatrième niveau : les données, chiffrées avec une clé différente par locataire, et des journaux séparés. Des plafonds de consommation empêchent un locataire d’accaparer les ressources, et la plateforme est découpée en blocs indépendants pour qu’une intrusion ne touche qu’une partie des clients. Quand un niveau cède, les suivants limitent les dégâts, et des essais automatiques vérifient en continu que l’ensemble tient.
À lire aussi
- Virtualisation réseau, NFV et data planes ouvertsComprendre la virtualisation réseau comme abstraction d’équipements, de fonctions et de chemins : isolation, overlays, NFV, data planes accélérés et plateformes open source.
- Installer WSL 2 sous Windows 10 et 11, configuration et sécuritéGuide pas à pas pour installer WSL 2 sous Windows 10 et 11, avec prérequis, commandes, fichiers de configuration, réseau, proxy, sauvegarde et surface d'attaque.
- EBPF pour observabilité et enforcement LinuxeBPF permet d’observer et de contrôler réseau, processus et charge applicative depuis le noyau Linux, sous contrôle du vérificateur.
- Cloud IaaS, PaaS, SaaS et modèles de déploiement, qui sécurise quoiDéfinition du cloud computing selon le NIST, modèles de service IaaS, PaaS, SaaS et modèles de déploiement, avec ce que chacun délègue réellement en sécurité et ce qu'il laisse au client.
Pages voisines
La citent
Isolation multi-locataire face à un locataire hostile
Elle cite
- Lien dans les deux sens :Évasion de VM et isolation matérielle des hyperviseurs
- Lien dans les deux sens :Comment isoler les clés dans un HSM multi-tenant
- Lien dans les deux sens :Prévenir les BOLA dans une API métier
- Hyperviseur Type 1 ou Type 2 : lequel choisir
- Isolation des conteneurs Docker : namespaces, cgroups et évasions
- Attaques par canaux auxiliaires et secrets
- Attestation distante TPM et démarrage mesuré
- Comment sécuriser firmware UEFI, réseau et BMC
- EBPF pour observer et bloquer dans le noyau Linux
- Quantifier les fuites par théorie de l'information
- Rowhammer, Spectre et Meltdown, mécanismes et contre-mesures
: les deux pages se citent l’une l’autre.