
Rowhammer, Spectre et Meltdown, mécanismes et contre-mesures
Rowhammer, Spectre et Meltdown, mécanismes et contre-mesures
Section intitulée « Rowhammer, Spectre et Meltdown, mécanismes et contre-mesures »Toute l’isolation logicielle (processus, noyau, machine virtuelle, enclave) repose sur deux promesses du matériel : une case mémoire ne change que si on y écrit, et une instruction annulée n’a jamais eu lieu. Rowhammer casse la première, Spectre et Meltdown cassent la seconde. La page décrit le mécanisme de chaque famille, la frontière qu’elle franchit, le prix des correctifs et ce qu’ils laissent ouvert, avec une position d’architecture : la vraie frontière de confiance est le cœur physique et la barrette mémoire, pas la machine virtuelle.
→ Lire l’explication complète de la marmotte
Faute physique en DRAM et exécution transitoire : deux familles à ne pas confondre
Section intitulée « Faute physique en DRAM et exécution transitoire : deux familles à ne pas confondre »Les deux familles arrivent souvent dans la même phrase, parfois sur la même diapositive, et n’ont pourtant presque rien en commun.
Rowhammer est une faute physique dans la DRAM (Dynamic Random Access Memory, la mémoire vive). Des accès répétés à certaines rangées de cellules font basculer des bits dans les rangées voisines. L’attaquant modifie une donnée qu’il n’a pas le droit d’écrire : c’est une atteinte à l’intégrité.
L’exécution transitoire (Spectre, Meltdown et la suite) est un défaut de conception des processeurs performants. Le processeur exécute par avance des instructions qu’il finira par annuler, mais l’annulation ne nettoie pas tout : une trace subsiste dans le cache. L’attaquant lit une donnée qu’il n’a pas le droit de lire : c’est une atteinte à la confidentialité.
La conséquence pratique de cette séparation : les contre-mesures ne se recouvrent pas. Un noyau à jour de tous ses correctifs Spectre ne protège en rien d’une bascule de bit, et une mémoire à correction d’erreurs ne retient aucun secret. Les deux chantiers se pilotent séparément, avec des leviers différents (processeur, microcode et noyau d’un côté ; barrettes, plateforme et placement des charges de l’autre).
Point commun, tout de même : aucune de ces attaques n’exploite un bogue logiciel. Le code de la victime peut être prouvé correct, écrit dans un langage à mémoire sûre et relu trois fois ; la fuite ou la corruption vient d’en dessous.
Rowhammer : des bits qui basculent dans les rangées voisines
Section intitulée « Rowhammer : des bits qui basculent dans les rangées voisines »Une cellule de DRAM est un condensateur minuscule et un transistor. Le condensateur fuit, d’où un rafraîchissement périodique de toute la mémoire (de l’ordre de quelques dizaines de millisecondes). À mesure que la gravure s’affine, les cellules se rapprochent et stockent moins de charge : activer une rangée perturbe électriquement ses voisines et accélère leur fuite. Si une rangée dite agresseur est activée assez souvent entre deux rafraîchissements, une cellule de la rangée victime passe sous le seuil de lecture. Le bit a changé sans que personne n’y ait écrit.
Le schéma montre la configuration la plus efficace, dite double face : la victime est prise en étau entre deux agresseurs.
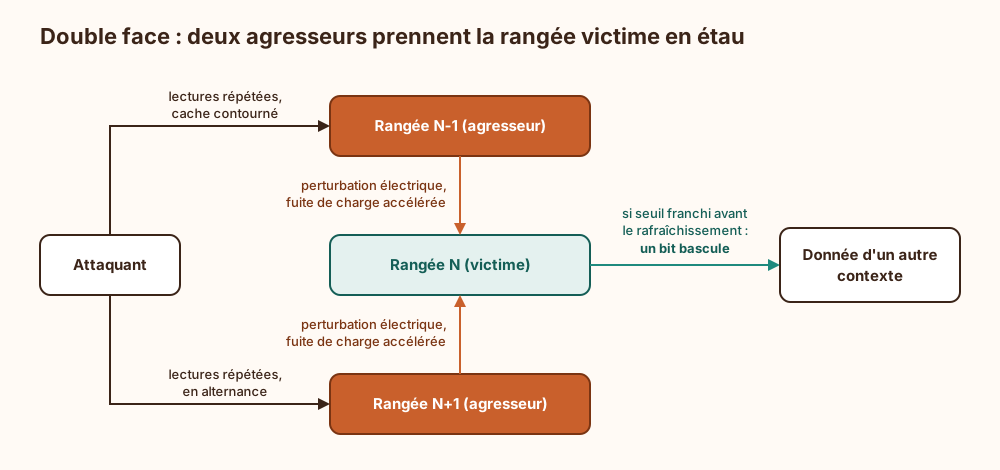
Le phénomène a été caractérisé à grande échelle par Kim et al. en 2014. En 2015, Project Zero en a tiré une élévation de privilèges : remplir la mémoire de tables de pages, puis provoquer une bascule dans une entrée de table pour qu’elle pointe vers une autre table de pages, contrôlée par l’attaquant. À partir de là, lecture et écriture sur toute la mémoire physique. La propriété qui rend l’attaque exploitable, et pas seulement spectaculaire : une cellule fragile bascule de façon reproductible au même endroit. Il reste à amener la donnée visée sur cette cellule, ce que les allocateurs mémoire permettent avec un peu de patience.
La suite a élargi le terrain, variante après variante :
- Rowhammer.js (2015) : déclenchement depuis du JavaScript, sans instruction de vidage du cache.
- Drammer (2016) : exploitation déterministe sur des terminaux ARM.
- Flip Feng Shui (2016) : entre machines virtuelles, en s’appuyant sur la déduplication mémoire de l’hyperviseur pour placer une page de la victime sur une cellule fragile.
- RAMBleed (2019) : Rowhammer comme canal de lecture. La probabilité de bascule dépend des bits voisins ; observer ses propres bascules renseigne sur les données d’à côté. L’intégrité n’est donc plus la seule propriété touchée.
- TRRespass (2020), Half-Double et Blacksmith (2021) : voir ci-dessous.
Côté défenses, deux mécanismes, deux déceptions partielles.
Le TRR (Target Row Refresh), intégré aux barrettes DDR4 (Double Data Rate, quatrième génération), repère les rangées trop sollicitées et rafraîchit leurs voisines. Il a été présenté comme la fin du problème. TRRespass a montré que son compteur ne suit qu’un petit nombre d’agresseurs : en marteler davantage suffit à le déborder. Half-Double a obtenu des bascules à deux rangées de distance, et Blacksmith, avec des motifs à fréquences irrégulières, a fait basculer des bits sur toutes les barrettes DDR4 testées par ses auteurs. Les mécanismes de la DDR5 élèvent le coût sans clore le dossier : des bascules y ont été démontrées aussi.
L’ECC (Error-Correcting Code), mémoire à correction d’erreurs, corrige en général un bit par mot et en détecte deux. Elle gêne beaucoup l’attaquant, sans garantie : trois bascules bien placées dans un même mot peuvent passer inaperçues, et une erreur corrigée reste observable par le temps de correction, ce qui suffit à RAMBleed. L’ECC transforme surtout une corruption silencieuse en événement compté, et cette télémétrie vaut cher.
Position : sur un hôte mutualisé, ECC obligatoire, déduplication mémoire entre locataires désactivée, et aucune confiance dans la mention « TRR » d’une fiche produit. L’expérience montre que « corrigé dans le matériel » signifie souvent « déplacé dans un endroit où personne ne peut vérifier ».
Exécution transitoire : Meltdown, Spectre v1 et Spectre v2
Section intitulée « Exécution transitoire : Meltdown, Spectre v1 et Spectre v2 »Un processeur moderne n’attend pas. Il exécute les instructions dans le désordre dès que leurs opérandes sont prêts, et quand il rencontre un branchement dont la condition n’est pas encore calculée, il prédit la direction et continue. Si la prédiction était bonne, le temps est gagné. Sinon, il annule : registres et mémoire reviennent à l’état d’avant. Ces instructions exécutées puis annulées sont dites transitoires.
L’annulation porte sur l’état architectural, pas sur l’état microarchitectural. Une ligne chargée dans le cache pendant la fenêtre transitoire y reste. Or la présence d’une ligne en cache se mesure au temps d’accès, par exemple avec la technique Flush+Reload : l’attaquant vide une ligne du cache, laisse la victime s’exécuter, puis chronomètre son propre accès à cette ligne. Le principe de la fuite par le temps est posé dans la page sur les attaques par canaux auxiliaires, et le canal du cache est repris côté cryptographie dans Quand l’implémentation parle. Il suffit que l’instruction transitoire accède à une adresse qui dépend du secret pour que le secret sorte.
Le schéma donne l’ordre des opérations, commun à toute la famille.
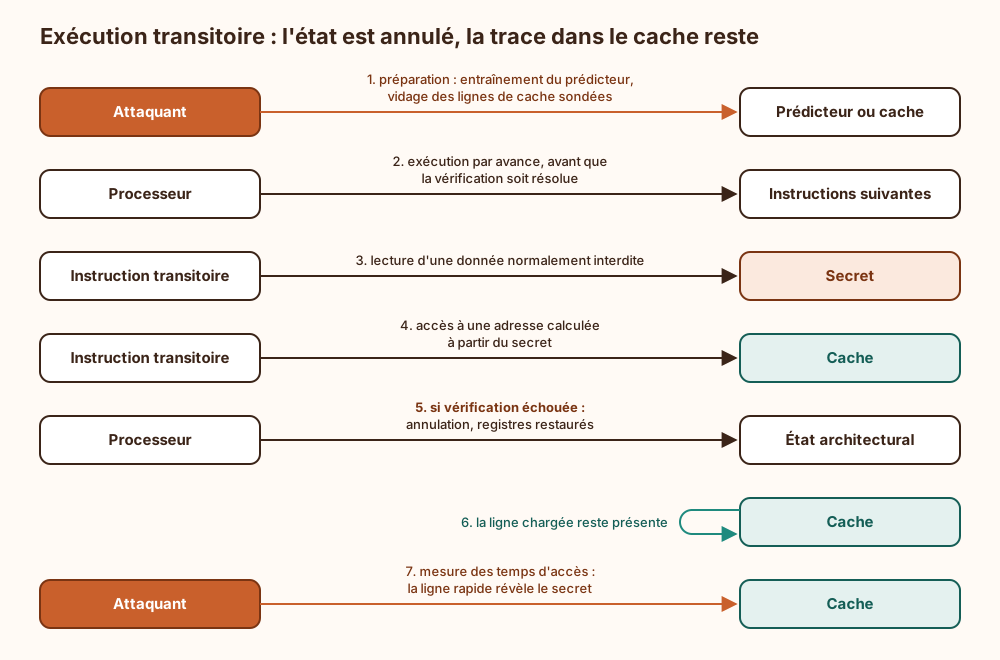
Meltdown. Sur les processeurs touchés (surtout Intel, quelques cœurs ARM ; pas AMD), la vérification du droit d’accès à une page arrive trop tard : une lecture de la mémoire noyau depuis l’espace utilisateur lève bien une exception, mais les instructions suivantes ont déjà utilisé la valeur. Le noyau étant, pour des raisons de performance, projeté dans l’espace d’adressage de chaque processus, toute sa mémoire devenait lisible, donc celle de tous les processus. La correction logicielle est KPTI (Kernel Page Table Isolation) : deux jeux de tables de pages, et en mode utilisateur le noyau n’est quasiment plus projeté. Chaque appel système et chaque interruption paie un changement de tables. Les générations ultérieures corrigent le défaut dans le silicium. Au passage, KPTI referme aussi plusieurs contournements de la randomisation des adresses du noyau, traitée dans la page sur ASLR, DEP et CFI.
Spectre v1 (contournement de vérification de bornes). Le prédicteur parie qu’un test de bornes passera ; pendant la fenêtre transitoire, le code de la victime lit hors du tableau puis utilise la valeur comme index. Tout se passe dans l’espace d’adressage de la victime, avec son propre code, parfaitement légitime. Il n’existe donc pas de correctif global : chaque motif dangereux se durcit un par un (masquage d’index, barrière de spéculation). C’est la variante qui ne finira jamais.
Spectre v2 (injection de cible de branchement). Le prédicteur de branchements indirects est partagé entre contextes. L’attaquant l’entraîne pour que la victime (noyau, hyperviseur, autre processus) saute transitoirement vers un fragment de code de son choix. Les contre-mesures forment une petite ménagerie :
- retpoline : construction du compilateur qui remplace les sauts indirects par un retour piégeant la spéculation ;
- IBRS (Indirect Branch Restricted Speculation) : le code privilégié n’utilise plus les prédictions entraînées par du code moins privilégié ;
- IBPB (Indirect Branch Predictor Barrier) : purge du prédicteur lors d’un changement de contexte ;
- STIBP (Single Thread Indirect Branch Predictors) : un fil d’exécution n’influence plus le prédicteur de son voisin sur le même cœur.
Les trois variantes ont été rendues publiques ensemble en janvier 2018. Spectre touche Intel, AMD et ARM : c’est une propriété de la prédiction de branchement, pas le défaut d’un constructeur.
Descendance de Spectre et Meltdown : L1TF, MDS, Retbleed, Downfall, Zenbleed, Inception
Section intitulée « Descendance de Spectre et Meltdown : L1TF, MDS, Retbleed, Downfall, Zenbleed, Inception »Retenir les noms un par un n’a aucun intérêt, et les logos non plus (chaque faille a désormais le sien, la sécurité matérielle étant devenue une discipline graphique). Ce qui se retient, ce sont quatre lignées.
La lignée Meltdown : lire à travers une faute. L1TF (L1 Terminal Fault, alias Foreshadow, 2018, Intel) exploite une entrée de table de pages marquée absente : le processeur consulte transitoirement le cache de données de premier niveau avec l’adresse qu’elle contient. Tout ce qui s’y trouve est lisible, y compris les données d’une enclave SGX (Software Guard Extensions), du noyau ou d’une autre machine virtuelle. Le cas des enclaves est développé dans la page SGX et TrustZone.
La lignée de l’échantillonnage : lire ce qui traîne dans les tampons. MDS (Microarchitectural Data Sampling, 2019, Intel), révélé par ZombieLoad, RIDL et Fallout, fait fuiter des données périmées restées dans des tampons internes du processeur. L’attaquant ne choisit pas l’adresse : il échantillonne ce qui passe sur le cœur, tous contextes confondus. Downfall (2023, Intel de la 6e à la 11e génération) fait de même avec l’instruction de collecte vectorielle. Ces tampons sont partagés entre les deux fils d’un même cœur.
La lignée Spectre : tromper un autre prédicteur. Speculative Store Bypass (2018) vise la prédiction de dépendance entre écriture et lecture mémoire. Branch History Injection (2022) a montré que la version matérielle renforcée d’IBRS ne suffisait pas. Retbleed (2022, certaines générations AMD et Intel) a montré que les instructions de retour, sur lesquelles retpoline s’appuie, pouvaient elles aussi être détournées. Inception (2023, AMD Zen) combine spéculation fantôme et entraînement en fenêtre transitoire.
Le cas à part : Zenbleed (2023, AMD Zen 2). Une mauvaise récupération après spéculation laisse dans des registres vectoriels des données d’autres contextes. Pas de canal du cache ici : la donnée fuit directement, et vite.
| Famille | Frontière franchie | Contre-mesure | Ce qui reste |
|---|---|---|---|
| Rowhammer | Intégrité de la mémoire d’un autre processus, du noyau, d’une autre machine virtuelle | TRR, ECC, pas de déduplication entre locataires, hôte dédié | Contournements de TRR démontrés, ECC non garantie, DDR5 non immune |
| Meltdown | Utilisateur vers noyau | KPTI, correction dans le silicium | Coût sur les appels système des anciennes générations |
| Spectre v1 | Interne à un espace d’adressage (bac à sable, noyau via ses propres fragments) | Durcissement motif par motif, isolation par processus | Classe ouverte, sans correctif générique |
| Spectre v2, Retbleed, Inception | Utilisateur vers noyau, invité vers hôte, processus vers processus | Retpoline, IBRS, IBPB, STIBP, microcode | Nouvelles variantes régulières, coût cumulé |
| Speculative Store Bypass | Interne à un processus, bac à sable | Désactivation par processus ou globale | Souvent laissée inactive par défaut hors bac à sable |
| L1TF | Utilisateur vers noyau, invité vers hôte, extérieur vers enclave | Inversion des entrées de tables, vidage du cache à l’entrée en machine virtuelle | Fuite entre fils du même cœur |
| MDS, Downfall | Tout contexte passé sur le même cœur | Vidage des tampons, microcode | Fuite entre fils du même cœur, coût sur le calcul vectoriel |
| Zenbleed | Tout contexte passé sur le même cœur | Microcode, à défaut réglage noyau | Rien de connu une fois le microcode appliqué |
Exposition réelle : cloud mutualisé, SMT, navigateurs et serveurs dédiés
Section intitulée « Exposition réelle : cloud mutualisé, SMT, navigateurs et serveurs dédiés »Toutes ces attaques ont un prérequis commun : exécuter du code sur la machine de la victime. La question d’architecture n’est donc pas « la machine est-elle vulnérable » (elle l’est), mais « qui d’autre calcule dessus ».
Cloud mutualisé et virtualisation. C’est le cas le plus exposé : des locataires qui ne se font pas confiance partagent processeur et barrettes. L’hyperviseur porte l’essentiel des contre-mesures, détaillées côté isolation dans la page sur l’évasion de machine virtuelle ; le choix du type d’hyperviseur est traité dans Hyperviseur Type 1 ou Type 2. Le point dur est le SMT (Simultaneous Multithreading, hyperthreading chez Intel) : deux fils logiques partagent un cœur physique, donc son cache de premier niveau, ses tampons et une partie de ses prédicteurs. L1TF et MDS traversent cette cloison, et aucun vidage ne protège deux fils qui tournent en même temps. Deux réponses tiennent : désactiver SMT, ou garantir par l’ordonnanceur que deux fils d’un même cœur n’exécutent jamais deux domaines de confiance différents (le core scheduling de Linux, l’épinglage de cœurs entiers par machine virtuelle).
Conteneurs. Ils partagent le noyau de l’hôte : aucune frontière matérielle supplémentaire, et le noyau lui-même est la cible de Spectre v2. Voir l’isolation par namespaces et cgroups pour ce que cette isolation garantit ou non. Mettre deux locataires hostiles dans deux conteneurs du même hôte, c’est compter sur une frontière que le matériel ne connaît pas.
Navigateurs. JavaScript est du code tiers exécuté localement, des milliers de fois par jour. Les réponses ont été la réduction de la précision des horloges, le retrait temporaire puis le conditionnement de la mémoire partagée entre fils, et surtout l’isolation des sites : un processus par site, pour que Spectre v1 n’ait plus rien d’intéressant à lire dans son propre espace d’adressage. Dégrader les horloges ralentit l’attaquant ; seule la séparation en processus lui retire la cible.
Serveur dédié à code de confiance. Une machine qui n’exécute que son propre code, sans navigateur, sans greffon tiers, sans utilisateurs multiples, n’offre pas de point d’appui à l’attaquant. Les contre-mesures y relèvent de la défense en profondeur contre une compromission préalable.
L’arbre suivant résume la décision de placement.
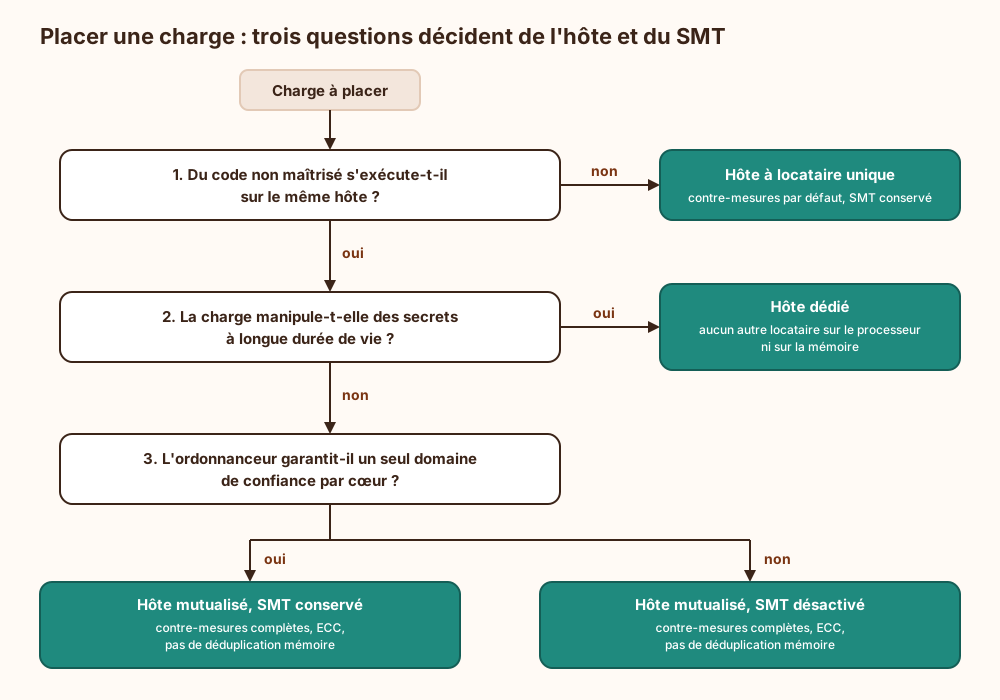
Le compromis central se lit ici. La mutualisation vend de la densité, et la densité est précisément ce que ces attaques exploitent : cœurs partagés, caches partagés, rangées de mémoire contiguës. On gagne du coût par charge, on paie en frontière de confiance. La recommandation : ne jamais faire cohabiter deux niveaux de confiance sur un même cœur physique, et sortir des hôtes mutualisés les charges qui détiennent des secrets durables (clés d’autorité de certification, clés maîtresses, secrets de fédération d’identité). Mieux encore, sortir la clé de la mémoire vive : une clé conservée dans un module cryptographique matériel ne peut pas fuiter par le cache d’un hôte qu’elle ne visite jamais.
Coût des contre-mesures : microcode, noyau, hyperviseur
Section intitulée « Coût des contre-mesures : microcode, noyau, hyperviseur »Une contre-mesure contre l’exécution transitoire n’est jamais un seul correctif. Elle exige trois étages alignés, plus un quatrième en environnement virtualisé :
- Le microcode du processeur, qui apporte les nouvelles commandes (purge du prédicteur, vidage des tampons). Il arrive par le firmware de la carte mère ou par chargement précoce depuis le système ; la chaîne de mise à jour est traitée dans la page sur la sécurité du firmware et du BMC.
- Le noyau, qui utilise ces commandes aux bons moments (changement de contexte, retour en mode utilisateur) et embarque KPTI.
- Le compilateur, pour retpoline et le durcissement des motifs Spectre v1.
- L’hyperviseur, qui doit se protéger lui-même et exposer aux invités les capacités du processeur. Un invité qui ne voit pas la capacité ne peut pas activer la contre-mesure correspondante.
Ce quatrième étage est le piège de production classique. Un modèle de processeur virtuel figé sur une ancienne génération, choisi pour permettre la migration à chaud dans un parc hétérogène, masque les capacités ajoutées par microcode. L’hôte est à jour, le tableau de bord est vert, et les invités tournent sans protection. La vérification se fait dans l’invité, pas sur l’hôte.
Le coût en performance existe et dépend entièrement de la charge. Les charges qui traversent souvent la frontière utilisateur-noyau (entrées-sorties intensives, bases de données, réseau à haut débit) paient le plus cher KPTI et les purges ; le calcul pur, presque rien. Downfall pénalise le code vectorisé qui utilise l’instruction de collecte. Désactiver SMT retire une fraction de la capacité de calcul, à intégrer au dimensionnement. Aucun pourcentage générique ne vaut : la seule mesure honnête est un test de charge avant et après, sur la charge réelle et le processeur réel.
D’où la tentation du paramètre noyau mitigations=off. Elle se défend sur un hôte à locataire unique qui n’exécute que du code de confiance, et nulle part ailleurs. Dès qu’un invité, un conteneur tiers, un navigateur ou un interpréteur de code soumis par un utilisateur entre en scène, la désactivation revient à retirer les portes pour améliorer la circulation.
Exemple : lire l’état des vulnérabilités processeur sous Linux
Section intitulée « Exemple : lire l’état des vulnérabilités processeur sous Linux »Le noyau Linux publie son propre diagnostic, une ligne par famille. La commande se lance sans privilège, sur l’hôte comme dans chaque invité.
# Une ligne par famille : "Not affected", "Mitigation: ..." ou "Vulnerable"grep -r . /sys/devices/system/cpu/vulnerabilities/
# Extrait possible (le libellé exact dépend du processeur et de la version du noyau) :#   .../meltdown:Mitigation: PTI#   .../spectre_v2:Mitigation: Retpolines; IBPB: conditional; STIBP: disabled#   .../mds:Mitigation: Clear CPU buffers; SMT vulnerable#   .../l1tf:Mitigation: PTE Inversion; VMX: conditional cache flushes, SMT vulnerable
# État de SMT : "on", "off", "forceoff" ou "notsupported"cat /sys/devices/system/cpu/smt/control
Trois lectures à faire dans cet ordre. D’abord, toute ligne Vulnerable : c’est une contre-mesure absente, à expliquer ou à corriger. Ensuite, la mention SMT vulnerable : la contre-mesure est active, mais la fuite entre fils du même cœur reste ouverte ; c’est le rappel que la décision SMT n’a pas été prise. Enfin, dans un invité, une ligne du type Vulnerable: Clear CPU buffers attempted, no microcode signale exactement le piège décrit plus haut : le noyau invité essaie, mais l’hyperviseur ne lui expose pas la capacité.
Limite de l’outil : ce répertoire ne dit rien de Rowhammer, et un noyau ancien ignore les familles découvertes après lui. L’absence de fichier ne vaut pas absence de faille.
Ce que les correctifs Spectre, Meltdown et Rowhammer ne garantissent pas
Section intitulée « Ce que les correctifs Spectre, Meltdown et Rowhammer ne garantissent pas »Quatre limites, à garder en tête avant d’écrire « risque traité » dans une analyse.
Les correctifs ferment des variantes, pas la classe. Tant que les processeurs spéculent, de nouveaux chemins de fuite seront trouvés ; la chronologie depuis 2018 en a apporté presque chaque année. Une architecture qui dépend de l’absence de variante inconnue n’a pas de marge.
Spectre v1 n’a pas de correction générale. Le durcissement du noyau couvre les motifs repérés dans le noyau. Les applications qui exécutent du code non maîtrisé dans leur propre processus (interpréteurs, moteurs de règles, bacs à sable de greffons) restent responsables de leur isolation, et la seule qui tienne est la séparation en processus.
La fuite entre fils d’un même cœur survit aux correctifs. Pour L1TF et MDS, les vidages agissent aux transitions, pas pendant l’exécution simultanée. Sans décision explicite sur SMT, la protection est partielle.
Rowhammer n’a pas de correctif logiciel fiable. Aucune mise à jour ne répare une barrette. Les protections sont statistiques, propres à chaque modèle, et non vérifiables depuis le système. La garantie doit venir d’ailleurs : séparation physique des locataires, et vérification d’intégrité applicative (signatures, sommes de contrôle) pour les données dont la corruption serait grave.
Ces attaques ne laissent en outre aucune trace dans les journaux classiques : une lecture par canal auxiliaire n’est pas un accès. Pour mesurer ce qu’un canal peut théoriquement transporter, voir la page sur la théorie de l’information et les canaux cachés.
Exploitation : microcode, supervision et reprise
Section intitulée « Exploitation : microcode, supervision et reprise »Inventaire. Collecter sur tout le parc, hôtes et invités, la révision du microcode, la version du noyau, le contenu du répertoire vulnerabilities et l’état SMT. Sans cet inventaire, la prochaine divulgation se traite à la main, machine par machine, en ouvrant des sessions distantes comme en 2005.
Cycle du microcode. Le microcode se gère comme un correctif de sécurité à part entière, avec son propre suivi. Une mise à jour par le firmware exige un redémarrage ; le chargement depuis le système ne persiste que si l’image de démarrage est régénérée. Dans un parc virtualisé, tous les hôtes d’un même groupe de migration doivent converger avant que les nouvelles capacités soient exposées aux invités, sinon la migration à chaud se bloque ou les capacités restent masquées. La révision chargée peut entrer dans les mesures du démarrage mesuré, pour qu’un hôte en retard soit refusé à l’attestation plutôt que découvert par hasard.
Supervision. Alerter sur toute ligne Vulnerable, sur un SMT réactivé après une mise à jour de firmware (les réglages reviennent volontiers aux valeurs d’usine), et sur les erreurs mémoire corrigées remontées par le sous-système EDAC (Error Detection and Correction) de Linux, sous /sys/devices/system/edac/mc/. Une rafale d’erreurs corrigées sur une même barrette est soit une panne qui s’annonce, soit un martèlement en cours ; dans les deux cas, l’hôte sort de la rotation.
Secrets et rotation. Après la découverte d’une exposition avérée (hôte mutualisé resté sans contre-mesure), les secrets qui ont séjourné en mémoire sur cet hôte se considèrent comme exposés : rotation, sans chercher une preuve de lecture qui n’existera pas.
Sauvegarde et reprise. Une corruption par bascule de bit se propage aux sauvegardes si la donnée est sauvegardée après corruption. Les sommes de contrôle de bout en bout (système de fichiers, base de données) sont le seul moyen de la repérer à la restauration. Côté microcode, conserver la révision précédente et tester le retour arrière : une mise à jour peut dégrader une charge précise, et la découverte se fait rarement à une heure confortable.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans inventaire ni décision de placement, la cohabitation se fait au gré de l’ordonnanceur : une charge qui détient une clé de signature finit sur le même cœur qu’un invité inconnu, et rien ne le signale. Les invités dont l’hyperviseur masque les capacités du processeur tournent sans contre-mesure pendant que l’hôte affiche un état conforme. Faute de compteurs d’erreurs mémoire, une donnée modifiée par une bascule de bit est indiscernable d’une donnée saine et part en sauvegarde telle quelle. Et à la divulgation suivante, impossible de dire quels hôtes sont concernés ni quels secrets y ont séjourné : la rotation devient générale, par défaut de traçabilité.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Un ordinateur fait tourner plusieurs programmes en même temps et leur interdit de lire ou de modifier les données des autres. Cette séparation est organisée par le logiciel, mais elle suppose que les composants se comportent parfaitement. Ce n’est pas toujours vrai, de deux façons.
Première façon : la mémoire vive range chaque information sous forme de minuscules charges électriques, serrées en rangées. Si un programme relit sa propre rangée des centaines de milliers de fois très vite, les rangées d’à côté se dérèglent et une information change de valeur. Le programme a donc modifié une donnée qui ne lui appartenait pas. Si cette donnée décrit les droits d’accès, il peut prendre le contrôle de la machine.
Seconde façon : pour aller plus vite, le processeur commence des calculs avant de savoir s’ils sont autorisés. Quand ils ne l’étaient pas, il les annule. Mais ces calculs ont déplacé des données dans une zone de stockage rapide, et cela reste. En mesurant quelles données se lisent vite, un programme devine le secret manipulé pendant le calcul annulé.
Les fabricants et les systèmes ont ajouté des protections : elles ralentissent certaines machines et ne couvrent pas tout. Quand elles manquent ou échouent, rien ne s’affiche et aucun journal ne l’enregistre. La protection la plus sûre reste de ne pas faire tourner sur la même machine des programmes qui ne se font pas confiance.
À lire aussi
- Isolation multi-locataire face à un locataire hostileQuelle frontière poser à chaque couche d'une plateforme mutualisée quand l'un des locataires est hostile, du noyau partagé à l'hôte dédié, et ce que chaque palier laisse passer.
- Sécuriser les données en mémoire dans le cloudMettre en œuvre le confidential computing pour protéger les données pendant le traitement des workloads cloud.
Pages voisines
La citent
- Isolation multi-locataire face à un locataire hostile
- Non-interférence et contrôle de flux d'information en pratique
Rowhammer, Spectre et Meltdown, mécanismes et contre-mesures
Elle cite
- Lien dans les deux sens :SGX et TrustZone pour isoler du code sensible
- Lien dans les deux sens :Quand l’implémentation parle : temps, cache, fautes et oracles
- Attaques par canaux auxiliaires et secrets
- Attestation distante TPM et démarrage mesuré
- Comment sécuriser firmware UEFI, réseau et BMC
- ASLR DEP NX canaries et CFI contre les exploits mémoire
- Évasion de VM et isolation matérielle des hyperviseurs
- Hyperviseur Type 1 ou Type 2 : lequel choisir
- Isolation des conteneurs Docker : namespaces, cgroups et évasions
- Quantifier les fuites par théorie de l'information
: les deux pages se citent l’une l’autre.