
AI Act : obligations du fournisseur d'un modèle d'IA à usage général (article 53, annexes XI et XII)
AI Act : obligations du fournisseur d’un modèle d’IA à usage général (article 53, annexes XI et XII)
Section intitulée « AI Act : obligations du fournisseur d’un modèle d’IA à usage général (article 53, annexes XI et XII) »Le règlement (UE) 2024/1689 sur l’intelligence artificielle (IA) ne vise pas seulement les applications : il impose aussi des obligations à celui qui met sur le marché le modèle lui-même, celui que d’autres intègrent ensuite. L’article 53 en fixe quatre, détaillées par les annexes XI et XII, et elles concernent aussi bien un laboratoire qui entraîne un modèle de fondation qu’une équipe qui affine un modèle ouvert puis le publie. Le côté de l’organisation qui appelle un modèle par API (Application Programming Interface, interface de programmation) est traité dans la page déployeur ; ici, on se place côté fabricant.
→ Lire l’explication complète de la marmotte
Modèle d’IA à usage général ou système : qui porte l’article 53
Section intitulée « Modèle d’IA à usage général ou système : qui porte l’article 53 »Tout part de deux définitions qu’on confond volontiers. L’article 3 point 63 définit le modèle d’IA à usage général : un modèle qui présente une généralité significative, capable d’exécuter de manière compétente un large éventail de tâches distinctes et intégrable dans une variété de systèmes ou d’applications en aval. Les modèles utilisés pour la recherche, le développement ou le prototypage avant leur mise sur le marché en sont exclus. L’article 3 point 66 définit le système d’IA à usage général : un système bâti sur un tel modèle et capable de servir diverses finalités. L’article 53 vise le premier. Un assistant conversationnel est un système ; les poids qui tournent derrière sont le modèle. Les deux peuvent avoir le même fournisseur, avec deux jeux d’obligations distincts (voir rôles fournisseur et déployeur).
« Généralité significative » ne se mesure pas au doigt mouillé, mais presque. Les lignes directrices de la Commission publiées le 18 juillet 2025 posent un critère indicatif : un calcul d’entraînement supérieur à 10²³ FLOP (opérations en virgule flottante, floating point operations) et une capacité à générer du langage (texte ou audio), du texte vers image ou du texte vers vidéo. Indicatif signifie qu’un modèle au-dessus du seuil peut échapper à la qualification s’il est manifestement étroit, et l’inverse. Ces seuils sont à vérifier dans la version des lignes directrices en vigueur au moment de l’analyse.
Pour l’affinage, les mêmes lignes directrices proposent un second critère indicatif : l’auteur d’une modification devient fournisseur du modèle modifié si le calcul consacré à la modification dépasse un tiers du calcul d’entraînement du modèle d’origine. Ses obligations se limitent alors à la modification. En dessous, il reste un utilisateur du modèle, éventuellement fournisseur du système qu’il construit dessus.
Le schéma suivant se lit de haut en bas ; chaque branche terminale indique ce qui reste dû.
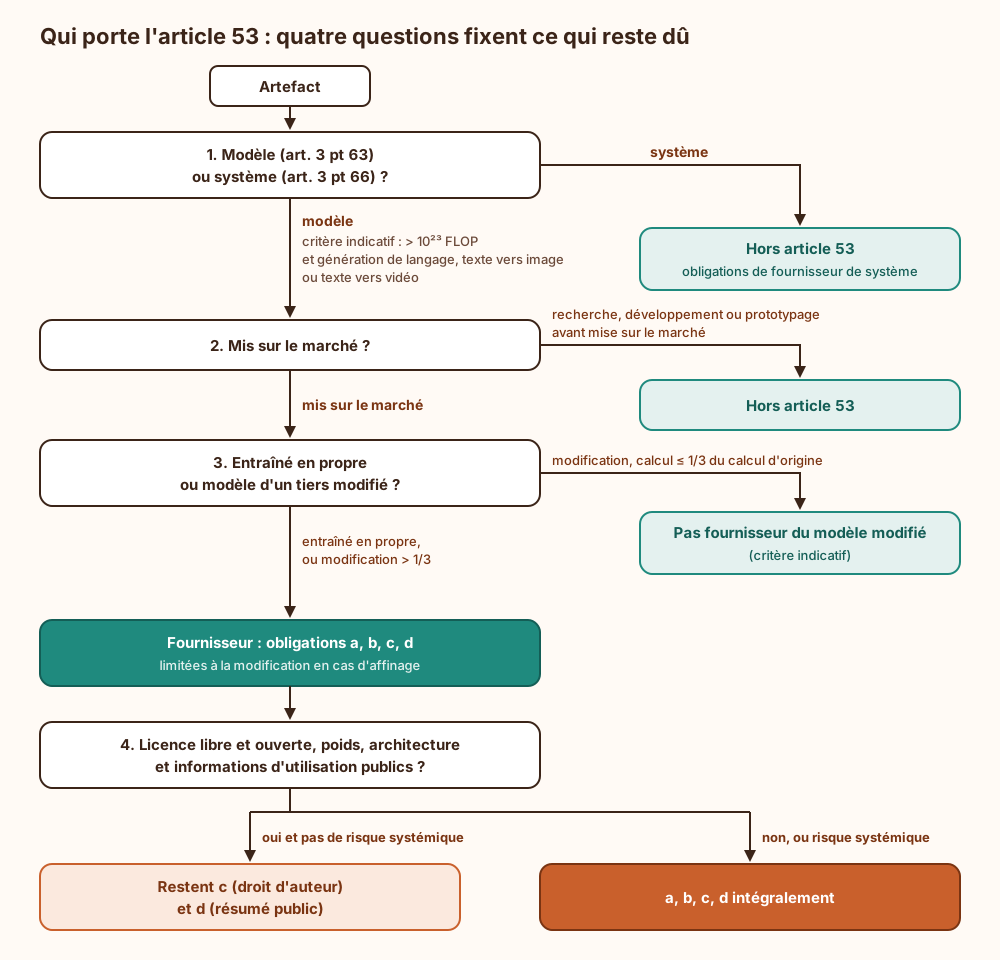
Le piège le plus fréquent se situe à Q2 : un modèle « interne » exposé à des partenaires par une API payante est mis sur le marché, quel que soit le nombre de clients. L’exclusion recherche et prototypage s’arrête au moment où un tiers peut s’en servir.
Les quatre obligations de l’article 53 §1 et leurs destinataires
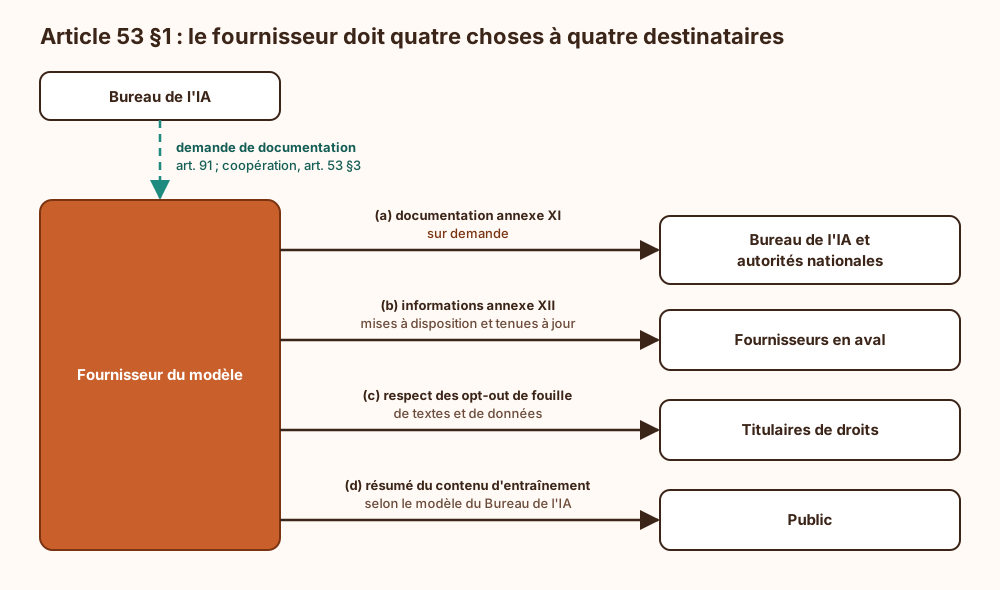
Section intitulée « Les quatre obligations de l’article 53 §1 et leurs destinataires »L’article 53 §1 impose d’élaborer et de tenir à jour quatre livrables, chacun destiné à un lecteur différent. C’est cette répartition qu’il faut retenir, parce qu’elle conditionne ce qu’on écrit, pour qui et avec quel niveau de détail.
- a) Documentation technique du modèle : processus d’entraînement et d’essai, résultats d’évaluation, au minimum les éléments de l’annexe XI. Elle est fournie sur demande au Bureau de l’IA et aux autorités nationales compétentes. Pas de publication.
- b) Informations pour les fournisseurs en aval : de quoi comprendre les capacités et les limites du modèle et remplir leurs propres obligations, au minimum l’annexe XII, sans préjudice des secrets d’affaires. Elle est mise à disposition de ceux qui intègrent le modèle.
- c) Politique de respect du droit d’auteur et des droits voisins : notamment identifier et respecter, y compris par des technologies de pointe, la réservation de droits prévue à l’article 4 §3 de la directive (UE) 2019/790, c’est-à-dire l’opt-out de fouille de textes et de données.
- d) Résumé suffisamment détaillé du contenu d’entraînement, public, établi selon le modèle fourni par le Bureau de l’IA (publié par la Commission le 24 juillet 2025).
Le schéma montre qui reçoit quoi ; la flèche entrante rappelle que la documentation a) n’existe pour l’autorité qu’à la demande, mais doit exister avant.
| Obligation (art. 53 §1) | Destinataire | Contenu minimal | Exemption licence libre et ouverte (§2) |
|---|---|---|---|
| a) Documentation technique | Bureau de l’IA, autorités nationales, sur demande | Annexe XI section 1 | Oui (sauf risque systémique) |
| b) Information de l’aval | Fournisseurs qui intègrent le modèle | Annexe XII | Oui (sauf risque systémique) |
| c) Politique droit d’auteur | Titulaires de droits (opposable) | Identification et respect des réservations de l’art. 4 §3 directive 2019/790 | Non |
| d) Résumé du contenu d’entraînement | Public | Modèle du Bureau de l’IA | Non |
L’article 53 §3 ajoute une obligation de coopération avec la Commission et les autorités ; le §7 renvoie la confidentialité des informations transmises à l’article 78. Les §5 et §6 autorisent des actes délégués sur les méthodes de mesure et la modification des annexes XI et XII : la liste minimale peut donc bouger, et un modèle de documentation figé pour toujours est une fiction.
Annexe XI face à annexe XII : deux documents, deux lecteurs
Section intitulée « Annexe XI face à annexe XII : deux documents, deux lecteurs »L’annexe XI section 1 s’applique à tous les fournisseurs. Elle exige une description générale (tâches visées et types de systèmes d’intégration, politiques d’utilisation acceptable, date de publication et méthodes de distribution, architecture et nombre de paramètres, modalités et format des entrées et sorties, licence) puis une description détaillée : moyens techniques d’intégration, spécifications de conception et d’entraînement (méthodes, choix de conception, ce que le modèle optimise), données d’entraînement, d’essai et de validation (type, provenance, organisation, nettoyage et filtrage, nombre de points de données, obtention et sélection, détection des biais), ressources de calcul en FLOP, temps d’entraînement et consommation d’énergie connue ou estimée, l’estimation pouvant partir des ressources de calcul. La section 2 de l’annexe XI ne concerne que les modèles à risque systémique ; elle relève d’une page dédiée à venir.
L’annexe XII, destinée à l’aval, reprend la description générale et y ajoute l’interaction avec le matériel ou les logiciels extérieurs au modèle et les versions logicielles pertinentes. Sa partie détaillée couvre les moyens techniques d’intégration, les modalités, le format et la taille maximale des entrées et sorties (la fenêtre de contexte), et les données d’entraînement (type, provenance, méthodes d’organisation). Elle ne contient ni les ressources de calcul, ni l’énergie, ni les détails de conception de l’entraînement.
Le schéma sépare ce qui ne va qu’à l’autorité, ce qui ne va qu’à l’aval et le tronc commun.
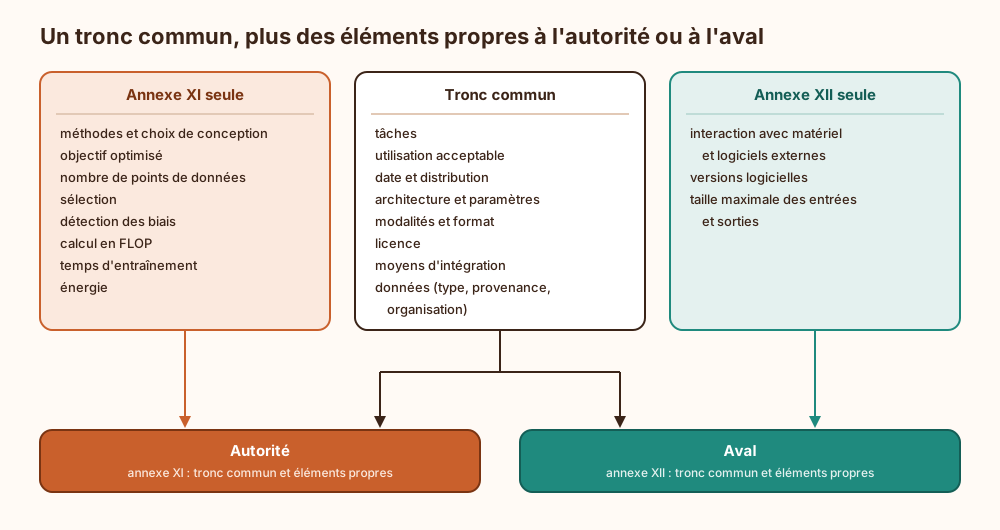
Recommandation de la page : produire une source unique et deux vues générées, plutôt que deux documents rédigés séparément. Deux documents écrits à la main divergent dès la deuxième version du modèle, et la première demande du Bureau de l’IA a toutes les chances de tomber sur la version que personne n’a mise à jour. Le formulaire de documentation du modèle (Model Documentation Form) du chapitre transparence du code de bonnes pratiques fournit justement une structure unique avec des champs marqués par destinataire ; c’est le point de départ le plus économique. La logique documentaire côté systèmes à haut risque, voisine mais distincte, est décrite dans documentation technique.
Exemption open source de l’article 53 §2 : ce qu’elle couvre vraiment
Section intitulée « Exemption open source de l’article 53 §2 : ce qu’elle couvre vraiment »L’article 53 §2 exempte des points a) et b), et d’eux seuls, les modèles publiés sous une licence libre et ouverte permettant de consulter, utiliser, modifier et distribuer le modèle, dont les paramètres (poids compris), l’architecture et les informations d’utilisation sont publics. Les points c) et d) restent dus. Aucune exemption pour un modèle à risque systémique.
« Poids ouverts » ne vaut pas licence libre et ouverte. Une licence qui interdit certains usages, plafonne le nombre d’utilisateurs ou réserve l’usage commercial ne remplit pas la condition, même si les poids sont téléchargeables par n’importe qui. Le marketing a dit « open », l’article 53 §2 lit la licence ; ce n’est pas le même lecteur.
Recommandation de la page : même exempté de a) et b), maintenir l’annexe XII en pratique. Sans elle, les intégrateurs ne peuvent pas remplir leurs propres obligations, et le modèle perd ses utilisateurs professionnels plus sûrement qu’à cause d’une amende.
Politique droit d’auteur et résumé public du contenu d’entraînement
Section intitulée « Politique droit d’auteur et résumé public du contenu d’entraînement »Le point c) est celui qui exige le plus d’ingénierie. Respecter l’opt-out de l’article 4 §3 de la directive 2019/790 suppose que le pipeline de collecte lise les réservations exprimées de manière lisible par machine (fichier robots.txt, métadonnées, protocoles de réservation) au moment de la collecte, et en garde la trace. Sans horodatage de collecte conservé, rien ne permet de prouver après coup qu’une réservation était absente au moment de la collecte, et aucun filtrage a posteriori ne reconstitue cette preuve. Le chapitre droit d’auteur du code de bonnes pratiques détaille des engagements concrets sur ce point.
Le point d) est public, donc lu par les titulaires de droits, les concurrents et la presse. Le modèle du Bureau de l’IA impose une granularité : catégories de sources, principaux jeux de données, domaines collectés. « Des données diverses issues d’Internet » ne résume rien ; c’est un horoscope. Le compromis central se joue ici : plus le résumé est précis, plus il expose la recette ; plus il est vague, plus il appelle les contestations et l’examen du Bureau de l’IA. Recommandation de la page : viser la précision exigée par le modèle et protéger le reste par le canal confidentiel de la documentation a), couverte par l’article 78, plutôt que de rogner le résumé public.
Exploitation de la conformité : traçabilité, secrets d’affaires et surface d’attaque
Section intitulée « Exploitation de la conformité : traçabilité, secrets d’affaires et surface d’attaque »Les prérequis se situent en amont de toute rédaction. Sans eux, l’annexe XI se remplit de mémoire, et calculer des FLOP à partir de souvenirs de facture d’hébergement est un sport peu fiable.
- Lignage des données : inventaire versionné des sources, horodatage de collecte, état de l’opt-out à cet instant, règles de filtrage appliquées, décompte des points de données.
- Journal d’entraînement : configuration, calcul consommé, durée, énergie mesurée ou estimée, rattachés à un identifiant de version du modèle.
- Registre des évaluations : protocoles et résultats, rattachés à la même version.
- Gouvernance documentaire : chaque version publiée du modèle déclenche une révision des vues annexe XI et XII. La logique est proche de la gouvernance des données exigée pour le haut risque.
La documentation elle-même est une surface d’attaque. L’annexe XI concentre la provenance des données, les filtres et les choix de conception : exactement ce qu’il faut à un attaquant pour cibler une source et préparer un empoisonnement des données d’entraînement de la prochaine version, ou pour contourner les filtres. Contre-mesures : stockage chiffré, accès nominatif journalisé, diffusion à l’autorité par un canal authentifié, et séparation stricte entre la vue confidentielle et la vue aval. L’annexe XII publiée révèle les versions logicielles et la taille maximale des entrées : de quoi calibrer des attaques par saturation de contexte ou viser une dépendance vulnérable. Les versions restent dues à l’aval : les dépendances vulnérables se corrigent donc avant d’être documentées, pas après.
Conservation et reprise : pour un fournisseur établi hors Union européenne (UE), l’article 54 impose un mandataire dans l’Union, désigné par mandat écrit avant la mise sur le marché, qui conserve une copie de la documentation de l’annexe XI pendant dix ans après la mise sur le marché (exemption open source prévue à l’article 54 §6, sauf risque systémique). Recommandation de la page : appliquer la même durée en interne quelle que soit l’implantation, avec une sauvegarde hors du périmètre de l’équipe d’entraînement, car un modèle retiré reste un modèle dont l’autorité peut demander l’historique.
Code de bonnes pratiques, contrôle et calendrier d’application
Section intitulée « Code de bonnes pratiques, contrôle et calendrier d’application »L’article 53 §4 permet de s’appuyer sur des codes de bonne pratique (article 56) pour démontrer la conformité, jusqu’à publication d’une norme harmonisée. Le code de bonnes pratiques pour l’IA à usage général, dans sa version finale du 10 juillet 2025, compte trois chapitres : transparence, droit d’auteur, sûreté et sécurité (ce dernier pour le risque systémique seulement). La Commission et le Comité IA l’ont jugé adéquat le 1er août 2025. L’adhésion est volontaire ; sans elle, il faut démontrer la conformité par d’autres moyens appropriés, soumis à l’appréciation de la Commission. Recommandation de la page : pour un fournisseur de taille modeste, adhérer ou au minimum reprendre la structure du code coûte nettement moins cher que de construire et défendre une méthode propre.
Dates (détail dans le calendrier) : obligations applicables depuis le 2 août 2025 ; amendes de l’article 101 applicables depuis le 2 août 2026, jusqu’à 3 % du chiffre d’affaires annuel mondial ou 15 M€, le montant le plus élevé étant retenu ; modèles mis sur le marché avant le 2 août 2025 : conformité au plus tard le 2 août 2027 (article 111 §3). Le contrôle relève du Bureau de l’IA, au sein de la Commission (article 88). L’omnibus numérique (règlement (UE) 2026/1744, en vigueur depuis le 27 juillet 2026) n’a pas réécrit l’article 53 ; il renforce la supervision par le Bureau de l’IA des systèmes bâtis sur un modèle à usage général du même fournisseur.
Ce que l’article 53 ne garantit pas
Section intitulée « Ce que l’article 53 ne garantit pas »L’article 53 est une obligation de transparence documentaire, pas de qualité. Il ne garantit pas que le modèle soit exact, robuste, exempt de biais ou sûr face aux injections ; la documentation peut décrire honnêtement un modèle médiocre. Il ne garantit pas la licéité des données au regard de la protection des données personnelles, qui relève d’un autre texte. Il ne transfère aucune obligation de l’intégrateur au fournisseur : un système à haut risque bâti sur un modèle bien documenté reste à évaluer par son propre fournisseur (voir classification haut risque), et les obligations de marquage des contenus générés relèvent de l’article 50. Le reste vient des contrats, des évaluations de l’intégrateur et des obligations propres aux systèmes.
Exemple : une PME qui affine un modèle ouvert, publie, puis vend par API
Section intitulée « Exemple : une PME qui affine un modèle ouvert, publie, puis vend par API »Cas fictif. Une PME (petite ou moyenne entreprise) française affine un modèle ouvert existant, déjà qualifié de modèle à usage général, sur un corpus juridique francophone. Deux trajectoires, et une question préalable qui conditionne tout : le calcul de l’affinage. Les seuils sont ceux des lignes directrices, indicatifs et à vérifier dans la version en vigueur.
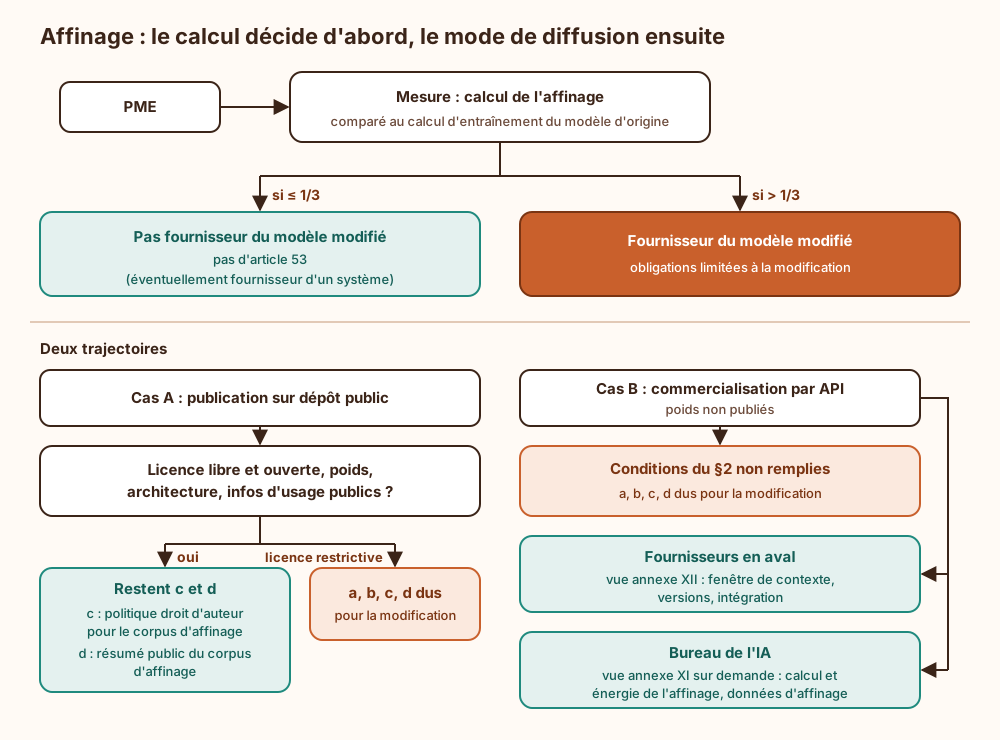
Lecture. Un affinage léger, de type LoRA (Low-Rank Adaptation), reste en général très loin du tiers du calcul d’origine : la PME n’est alors pas fournisseur du modèle modifié, et l’article 53 continue de peser sur le fournisseur d’origine. Si l’affinage dépasse le seuil, la PME devient fournisseur, mais seulement pour ce qu’elle a ajouté : données d’affinage, calcul et énergie de l’affinage, évaluations du modèle modifié.
Dans le cas A, une licence réellement libre et ouverte avec poids publics la dispense de a) et b) ; elle doit tout de même publier un résumé de son corpus d’affinage selon le modèle du Bureau de l’IA et documenter sa politique droit d’auteur, ce qui suppose d’avoir vérifié les opt-out des sources juridiques collectées. Dans le cas B, l’exposition par API sans poids publics fait tomber les conditions du §2 : les quatre obligations s’appliquent à la modification. Le considérant 103 du règlement et les lignes directrices traitent par ailleurs la monétisation comme un facteur qui peut faire perdre le bénéfice de l’exemption même avec une licence ouverte ; point à vérifier avant de miser sur le cas A pour une offre payante. En proposant une interface conversationnelle, la PME devient en outre fournisseur d’un système, avec ses obligations propres. Le choix entre affiner et augmenter par recherche documentaire, qui évite souvent la question, est discuté dans affinage ou RAG local.
Ce que l’intégrateur en aval doit réclamer au fournisseur du modèle
Section intitulée « Ce que l’intégrateur en aval doit réclamer au fournisseur du modèle »L’annexe XII donne à l’intégrateur une base contractuelle : ce qui suit relève du minimum légal dû par le fournisseur (sauf exemption §2), la liste étant une recommandation de la page pour le vérifier.
- Tâches visées et politique d’utilisation acceptable, pour confronter le cas d’usage prévu.
- Date de publication, méthode de distribution et identifiant de version, avec engagement de notification des changements (recommandation : l’exiger par contrat, le texte impose la mise à jour, pas le préavis).
- Interactions avec matériel et logiciels externes, versions logicielles pertinentes.
- Architecture et nombre de paramètres.
- Modalités, format et taille maximale des entrées et sorties.
- Moyens techniques d’intégration.
- Type, provenance et méthodes d’organisation des données d’entraînement.
- Licence, et lien vers le résumé public du contenu d’entraînement et vers la politique droit d’auteur.
Un fournisseur qui refuse ces éléments en invoquant le secret d’affaires confond la réserve prévue par l’article 53 §1 b) avec un droit au silence : la réserve module le détail, elle ne supprime pas la liste. Les obligations propres à l’intégrateur sont dans la page déployeur ; la grille d’évaluation complète dans évaluer un fournisseur d’IA générative, et la traduction contractuelle dans le contrat et DPA fournisseur.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans lignage des données tenu au fil de l’entraînement, la documentation de l’annexe XI devient impossible à reconstituer : la demande du Bureau de l’IA reste sans réponse vérifiable, et une estimation d’énergie sans journal de calcul ne se défend pas. Sans vérification des réservations de droits au moment de la collecte, aucun filtrage tardif ne prouve leur respect, et le résumé public devient une pièce opposable contre son auteur. Côté aval, l’absence de vue annexe XII laisse les intégrateurs sans fenêtre de contexte ni versions documentées : ils ne peuvent ni évaluer leurs propres risques ni détecter qu’un changement silencieux de version a modifié le comportement de leur application.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Une entreprise qui fabrique un programme d’intelligence artificielle capable de faire beaucoup de choses différentes, et que d’autres entreprises réutilisent dans leurs propres applications, a des devoirs précis en Europe depuis août 2025. D’abord, il faut savoir si on est concerné : le programme doit être assez polyvalent, avoir demandé beaucoup de calcul pour apprendre, et être proposé à d’autres, pas seulement testé en laboratoire. Quelqu’un qui retouche le programme d’un autre ne devient responsable que si sa retouche a demandé beaucoup de calcul, plus d’un tiers de l’apprentissage d’origine. Ensuite viennent quatre devoirs. Tenir un dossier détaillé (comment le programme a appris, sur quelles données, avec combien d’électricité) que l’autorité européenne peut réclamer. Donner aux entreprises qui réutilisent le programme une fiche qui dit ce qu’il sait faire, ses limites et comment le brancher. Respecter le choix des auteurs qui ont refusé que leurs textes servent à l’apprentissage. Publier un résumé des données utilisées. Si le programme est distribué librement, avec tout son contenu public et une vraie licence ouverte, les deux premiers devoirs tombent, pas les deux derniers. Si l’entreprise ne tient pas ses registres pendant l’apprentissage, elle ne peut plus rien prouver ensuite, et depuis août 2026 l’amende peut atteindre 3 % de son chiffre d’affaires mondial ou 15 millions d’euros, le montant le plus élevé étant retenu.
À lire aussi
- AI Act : champ d'application, qui est concerné et qui en sort (article 2)Lecture de l'article 2 du règlement (UE) 2024/1689, de la territorialité aux exclusions défense, recherche et logiciel libre, avec la condition qui fait tomber chacune.
- AI Act : maîtrise de l'IA et obligation de former le personnel (article 4)Ce que l'article 4 de l'AI Act, réécrit par l'omnibus de juillet 2026, exige des fournisseurs et déployeurs pour la maîtrise de l'IA de leur personnel, et comment le mettre en œuvre.
- AI Act : définition du système d'IA (article 3, point 1)Ce que l'article 3, point 1 de l'AI Act appelle un système d'IA, ses sept éléments, les quatre familles exclues par la Commission et la méthode pour qualifier un logiciel.
- AI Act : mandataire, importateur et distributeur d'une IA à haut risque (articles 22 à 24)Ce que les articles 22 à 24 du règlement (UE) 2024/1689 imposent au mandataire, à l'importateur et au distributeur d'un système d'IA à haut risque, et comment l'outiller.
Pages voisines
La citent
- AI Act : champ d'application, qui est concerné et qui en sort (article 2)
- AI Act : définition du système d'IA (article 3, point 1)
- AI Act : mandataire, importateur et distributeur d'une IA à haut risque (articles 22 à 24)
AI Act : obligations du fournisseur d'un modèle d'IA à usage général (article 53, annexes XI et XII)
Elle cite
- Lien dans les deux sens :AI Act : modèle d'IA à usage général présentant un risque systémique (articles 51, 52 et 55, annexe XIII)
- Lien dans les deux sens :AI Act et modèle d'IA à usage général appelé par API
- Lien dans les deux sens :AI Act : qui contrôle, Bureau de l'IA, Comité IA et autorités nationales (articles 64 à 70 et 74)
- Lien dans les deux sens :Fine-tuning en IA, définition, usages et limites
- AI Act : calendrier d'application 2025-2030 et ce qui s'applique déjà
- AI Act : classer un système d'IA à haut risque (article 6, annexes I et III)
- AI Act : documentation technique d'une IA à haut risque (article 11, annexe IV)
- AI Act : fournisseur, déployeur, importateur et requalification en fournisseur
- AI Act : gouvernance des données d'entraînement (article 10)
: les deux pages se citent l’une l’autre.