
AI Act : exactitude, robustesse et cybersécurité d'une IA à haut risque (article 15)
AI Act : exactitude, robustesse et cybersécurité d’une IA à haut risque (article 15)
Section intitulée « AI Act : exactitude, robustesse et cybersécurité d’une IA à haut risque (article 15) »L’article 15 du règlement (UE) 2024/1689 sur l’intelligence artificielle (IA), dit AI Act, impose à tout système d’IA à haut risque un niveau « approprié » d’exactitude, de robustesse et de cybersécurité, maintenu tout au long de son cycle de vie. Le texte ne fixe aucun seuil chiffré : il exige des chiffres déclarés, une résilience démontrée et une résistance aux attaques propres à l’apprentissage automatique. Cette page détaille ce que chaque paragraphe demande, quelles attaques il vise et quels tests mener pour que la déclaration de conformité repose sur autre chose qu’un tableau de bord flatteur.
→ Lire l’explication complète de la marmotte
Article 15 : trois exigences, cinq paragraphes, aucun seuil chiffré
Section intitulée « Article 15 : trois exigences, cinq paragraphes, aucun seuil chiffré »Le §1 pose l’obligation : exactitude, robustesse et cybersécurité à un niveau approprié, avec un fonctionnement constant sur tout le cycle de vie. Le mot « constant » pèse autant que « approprié ». Un modèle performant le jour de l’évaluation puis dégradé six mois plus tard par la dérive des données ne remplit pas le §1. Le §2 confie à la Commission, avec les autorités de métrologie et d’étalonnage, le soin d’encourager des critères de référence et des méthodes de mesure. Le texte, lui, reste muet sur les seuils. Les normes harmonisées sont en cours d’élaboration au CEN-CENELEC (Comité européen de normalisation et Comité européen de normalisation électrotechnique), au sein du comité technique conjoint JTC 21 (Joint Technical Committee), sur demande de normalisation de la Commission.
Les trois exigences n’ont ni les mêmes preuves, ni les mêmes destinataires. La carte ci-dessous indique, pour chacune, le paragraphe qui la porte et l’endroit où elle doit laisser une trace écrite.
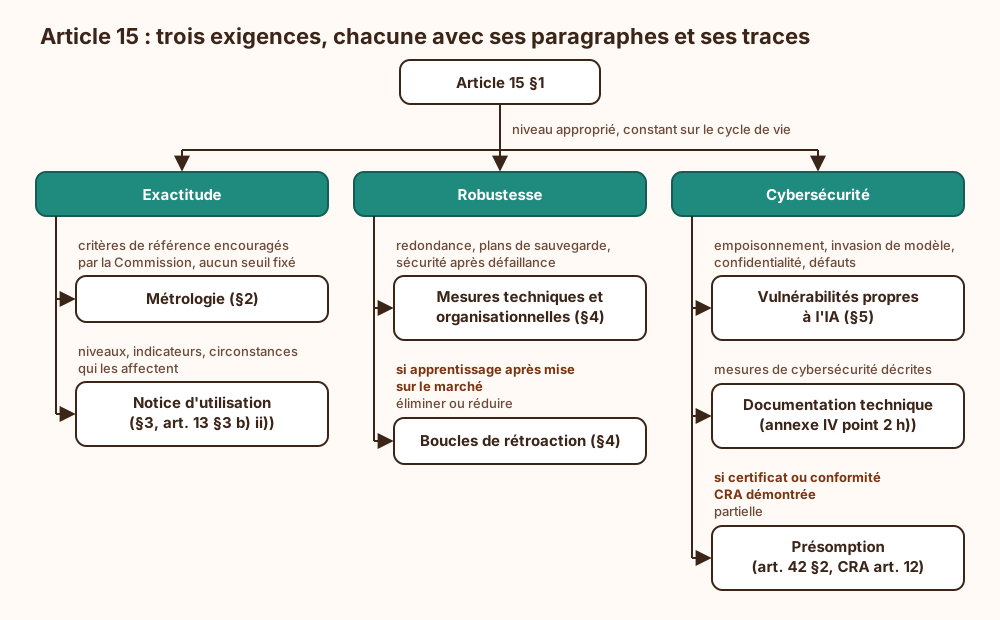
La lecture à retenir : l’exactitude se prouve devant le déployeur (dans la notice), la cybersécurité devant l’autorité (dans la documentation technique), et la robustesse dans les deux. Le compromis central du sujet se situe là. Durcir un modèle contre les entrées piégées, par exemple par entraînement adverse, coûte souvent quelques points d’exactitude sur les données ordinaires. Gonfler l’exactitude affichée en masquant les sous-populations où le modèle échoue rend la notice fausse. La recommandation de cette page est sans ambiguïté : déclarer une exactitude un peu plus basse mais ventilée et stable, plutôt qu’un chiffre global brillant qui s’effondre au premier segment mal couvert. Ce choix vaut tant que l’écart reste dans la tolérance définie par la gestion des risques ; au-delà, il faut revoir l’architecture, pas le discours.
L’obligation pèse sur le fournisseur (art. 16 a)), qui veille à la conformité aux articles 8 à 15. Un manquement relève de l’art. 99 §4 : jusqu’à 15 M€ ou 3 % du chiffre d’affaires annuel mondial, le montant le plus élevé étant retenu, le plus faible pour les PME (petites et moyennes entreprises, art. 99 §6). La répartition des rôles est détaillée dans fournisseur et déployeur, la qualification du système dans classification haut risque.
Point de calendrier au 10 octobre 2026 : le règlement (UE) 2026/1744 (omnibus numérique, en vigueur depuis le 27 juillet 2026) ne modifie pas l’article 15, mais il reporte l’application du haut risque au 2 décembre 2027 pour l’annexe III et au 2 août 2028 pour l’annexe I. Les détails figurent sur la page calendrier. Le report modifie l’échéance, mais le travail reste le même.
Ne pas confondre non plus avec l’art. 55 §1 d) : les modèles d’IA à usage général présentant un risque systémique ont leur propre obligation de cybersécurité, distincte de l’article 15.
Prérequis avant de mesurer l’exactitude ou la robustesse
Section intitulée « Prérequis avant de mesurer l’exactitude ou la robustesse »Aucune mesure prévue par l’article 15 ne tient sans quatre briques déjà en place.
- Versionnement liant données, code et modèle. Chaque modèle déployé doit pouvoir être relié au jeu d’entraînement exact (empreintes cryptographiques des fichiers), au code d’entraînement et aux hyperparamètres. Sans ce lien, impossible de prouver qu’un réentraînement n’a pas introduit d’empoisonnement, ni de revenir à la version précédente.
- Jeu de référence gelé. Il s’agit d’un jeu de test figé, jamais réutilisé pour l’entraînement, segmenté par population et par condition. Il sert d’étalon à chaque nouvelle version. Si le jeu de test bouge à chaque version, on mesure en réalité deux grandeurs à la fois.
- Registre de risques. Les seuils de tolérance par segment viennent de la gestion des risques (art. 9), pas de l’équipe de science des données le jour de la livraison.
- Gouvernance des données. La provenance, les biais et la représentativité relèvent de l’art. 10, traité dans gouvernance des données. L’article 15 ne refait pas ce travail : il le suppose acquis.
À cela s’ajoute la journalisation de l’art. 12 (journalisation) : sans traces d’entrées et de sorties en production, aucune dérive ni aucune campagne d’attaque ne se détecte après coup.
Indicateurs d’exactitude dans la notice : par population et par condition
Section intitulée « Indicateurs d’exactitude dans la notice : par population et par condition »Le §3 impose d’indiquer les niveaux et les indicateurs d’exactitude dans la notice d’utilisation. L’art. 13 §3 b) ii) précise le contenu attendu : le niveau d’exactitude, de robustesse et de cybersécurité qui a servi de référence pour les tests et la validation et qui peut être attendu, ainsi que les circonstances connues et prévisibles qui peuvent l’affecter.
Ce second volet est le plus souvent bâclé. Une moyenne globale masque presque toujours un segment où le modèle échoue. Un modèle juste à 94 % en moyenne peut l’être à 70 % sur une population représentant 5 % des cas, et la moyenne ne laissera rien paraître. La page recommande donc les règles suivantes :
- Ventiler par population (tranches d’âge, profils de revenus, dossiers peu fournis) et par condition (données manquantes, saisie dégradée, période de dérive connue).
- Choisir l’indicateur selon le coût de l’erreur. Taux de faux positifs et de faux négatifs séparés plutôt qu’un score agrégé. Pour un score de probabilité, ajouter la calibration (une probabilité annoncée de 10 % doit correspondre à environ 10 % d’événements observés).
- Donner un intervalle de confiance et la taille de chaque segment. Une précision mesurée sur trente cas n’est pas un indicateur, c’est une anecdote.
- Dater le jeu de référence et nommer les conditions hors domaine pour lesquelles aucun chiffre ne vaut.
Les tableaux de bord de fournisseurs affichant un unique « taux de précision » à deux décimales relèvent de la plaquette commerciale. Le §3 demande une notice qui permette au déployeur de savoir où il ne faut pas faire confiance au système, et c’est exactement ce que la plaquette évite de dire.
Robustesse, sécurité après défaillance et boucles de rétroaction
Section intitulée « Robustesse, sécurité après défaillance et boucles de rétroaction »Le §4 exige une résilience « autant que possible » face aux erreurs, défaillances et incohérences, internes ou provenant de l’environnement (interaction avec des personnes ou d’autres systèmes), par des mesures techniques et organisationnelles : redondance, plans de sauvegarde, mesures de sécurité après défaillance. Le considérant 75 précise l’intention : pouvoir interrompre le fonctionnement en sécurité lorsque le système sort de limites déterminées.
Où placer la sécurité après défaillance. Pour un système qui décide sur des personnes, l’état sûr n’est presque jamais « décision négative par défaut ». C’est l’abstention avec renvoi vers un humain. Concrètement, il faut un détecteur de hors-domaine en amont du modèle (variables manquantes, valeurs hors des bornes vues à l’entraînement, distance anormale à la distribution d’entraînement) qui court-circuite le score et route le dossier vers le circuit défini par le contrôle humain (art. 14). Ce détecteur doit être un composant séparé, versionné et testé à part : s’il se trouve dans le même artefact que le modèle, une régression du modèle peut l’emporter avec elle.
Redondance. Il est inutile de dupliquer le même modèle sur deux serveurs pour se croire redondant : la même erreur sera simplement reproduite deux fois. La redondance qui protège réellement repose sur une règle métier de repli, déterministe et documentée, ou sur le modèle de la version précédente, conservé et signé, prêt à être réactivé.
Boucles de rétroaction. Le §4 vise explicitement les systèmes qui continuent d’apprendre après leur mise sur le marché : il faut éliminer ou réduire, dans la mesure du possible, le risque que des sorties biaisées alimentent les entrées futures, et traiter ces boucles par des mesures d’atténuation appropriées. En pratique, le piège concerne aussi les réentraînements périodiques. Un modèle qui refuse une population n’observe jamais le devenir de cette population, et le réentraînement suivant apprend que cette population n’existe pas. Les contre-mesures sont les suivantes : séparer les étiquettes issues de décisions du modèle des étiquettes indépendantes, comparer chaque nouveau jeu d’entraînement à la distribution du jeu de référence gelé, et, recommandation de cette page plus que lettre du texte, s’interdire l’apprentissage en ligne non supervisé sur un système à haut risque. Le gain de fraîcheur ne compense pas la perte de traçabilité.
Surface d’attaque propre à l’IA : empoisonnement, invasion de modèle, confidentialité
Section intitulée « Surface d’attaque propre à l’IA : empoisonnement, invasion de modèle, confidentialité »Le §5 exige de résister aux tiers non autorisés qui tentent de modifier l’utilisation, les sorties ou la performance du système en exploitant ses vulnérabilités. Il nomme celles qui sont propres à l’IA : l’empoisonnement des données (jeu d’entraînement), l’empoisonnement de modèle (composants préentraînés), les exemples contradictoires ou « invasion de modèle » (la version française officielle traduit ainsi model evasion), les attaques visant la confidentialité et les défauts du modèle. Les mesures doivent permettre de prévenir, détecter, contrer, résoudre et maîtriser ces attaques. Le considérant 76 ajoute l’inférence d’appartenance et rappelle que l’infrastructure TIC (technologies de l’information et de la communication) sous-jacente reste une cible : un modèle irréprochable servi par une API (interface de programmation) sans authentification ne protège rien.
Le schéma suit le cycle de vie d’un système et associe à chaque point d’entrée de l’attaquant la contre-mesure correspondante.
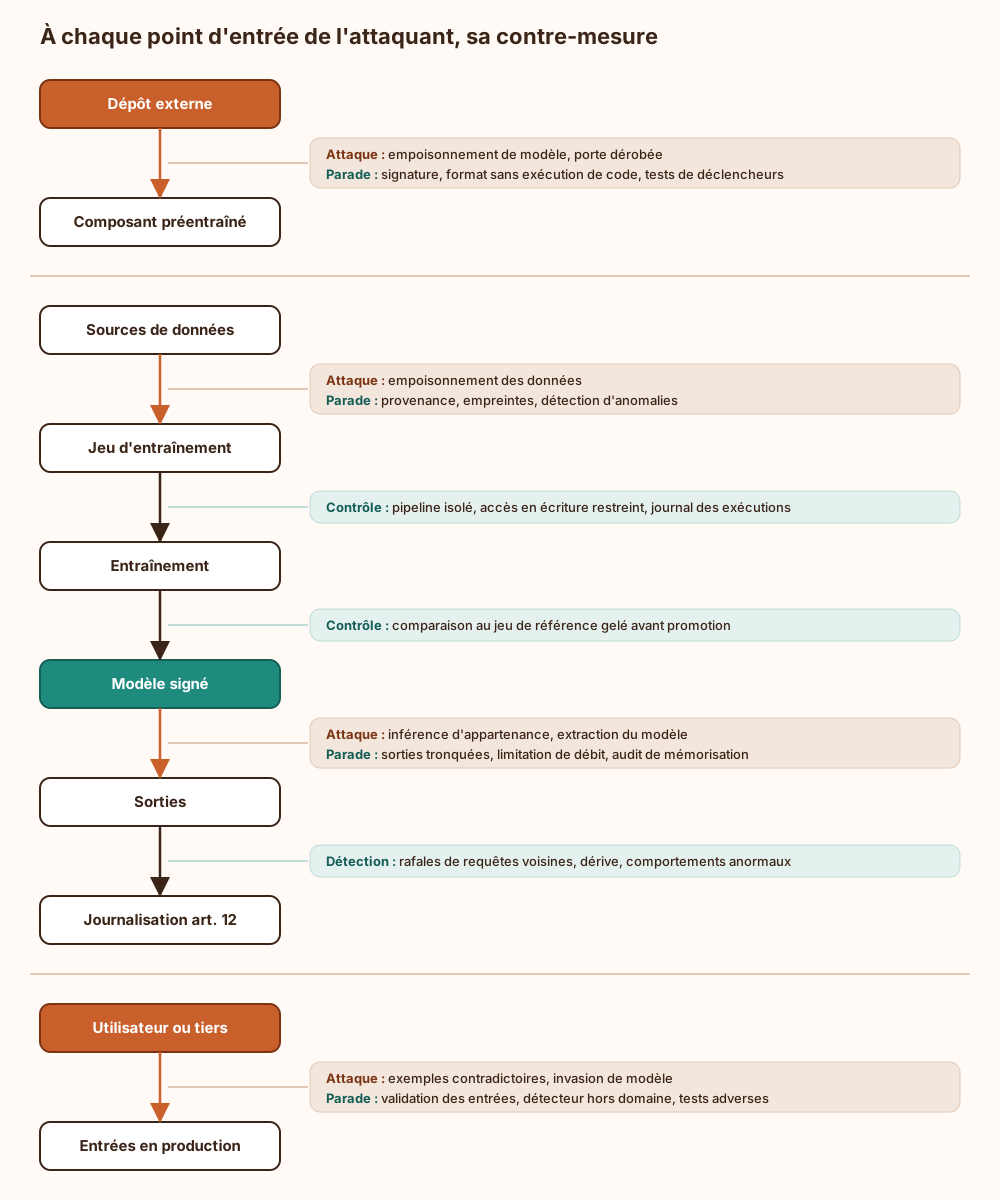
Ce qu’il faut y lire : chaque attaque vise une étape distincte, et aucune contre-mesure unique ne les couvre toutes. La technique d’empoisonnement est détaillée dans empoisonnement des données d’entraînement ; cette page n’en retient que les conséquences réglementaires.
Composants préentraînés. Un fichier de poids sérialisé avec pickle peut exécuter du code arbitraire au chargement : charger un modèle téléchargé revient alors à exécuter un programme inconnu. Il faut exiger un format de poids sans exécution de code (safetensors), vérifier une empreinte ou une signature avant tout chargement et tracer l’origine de chaque composant dans la documentation technique. La traçabilité des poids est abordée dans filigrane des poids de modèle. Un modèle de fondation « de confiance » parce qu’il a beaucoup d’étoiles sur une forge publique reste un exécutable d’origine inconnue doté d’une excellente réputation.
Exemples contradictoires. Sur des données tabulaires, l’invasion de modèle ne passe pas par des pixels imperceptibles. Elle passe par la manipulation des variables que l’utilisateur contrôle : montants déclarés, ordre des saisies, création de comptes pour gonfler un historique. Le test pertinent consiste à identifier les variables modifiables par la personne évaluée et à mesurer de combien la décision bascule quand on les déplace dans des bornes plausibles. Les garanties de robustesse certifiée existent, mais elles ne couvrent que de petites perturbations bornées et ne disent rien d’un revenu déclaré faux mais vraisemblable.
Confidentialité et défauts du modèle. L’inférence d’appartenance révèle qu’une personne figurait dans le jeu d’entraînement, ce qui suffit parfois à divulguer qu’elle était cliente ou en contentieux. L’extraction du modèle reconstruit son comportement à partir de requêtes répétées. Les parades consistent à renvoyer la décision et les principaux motifs plutôt qu’un score à six décimales, à limiter le débit par identité, à réduire le surapprentissage (un facteur majeur de mémorisation) et à intégrer un audit d’inférence d’appartenance aux tests de validation. Une tension réelle existe : plus les explications sont détaillées, plus l’extraction est facile. Il faut la trancher dans le registre de risques, pas par défaut.
Système bâti sur un LLM
Section intitulée « Système bâti sur un LLM »Pour un système à haut risque reposant sur un LLM (Large Language Model, grand modèle de langage), l’injection de prompt directe (l’utilisateur rédige l’instruction malveillante) et indirecte (l’instruction se cache dans un document, une page ou un courriel traité par le système) relèvent des entrées destinées à induire le modèle en erreur au sens du §5. L’extraction des instructions système et la fuite de données mémorisées sont des attaques sur la confidentialité. Aucun filtre ne supprime l’injection de prompt : c’est une propriété de l’architecture (voir l’injection de prompt comme propriété). La conformité passe donc par des garde-fous programmatiques qui bornent ce qu’une sortie piégée peut déclencher, par un red teaming rejoué à chaque version et par un contrôle de la mémorisation. Pour cartographier les tests, trois taxonomies servent de référence commune : MITRE ATLAS (Adversarial Threat Landscape for Artificial-Intelligence Systems), le Top 10 OWASP (Open Worldwide Application Security Project) pour les applications LLM et la taxonomie de l’apprentissage automatique adverse du NIST (National Institute of Standards and Technology, AI 100-2).
Présomptions de conformité : Cybersecurity Act, CRA et leurs limites
Section intitulée « Présomptions de conformité : Cybersecurity Act, CRA et leurs limites »Deux mécanismes allègent la preuve, et seulement sur le volet cybersécurité.
- Art. 42 §2. Un système certifié, ou couvert par une déclaration de conformité, dans un schéma de cybersécurité du règlement (UE) 2019/881 (Cybersecurity Act) dont les références sont publiées au Journal officiel est présumé conforme aux exigences de cybersécurité de l’article 15, dans la mesure de ce que couvre le certificat.
- Règlement (UE) 2024/2847, dit CRA (Cyber Resilience Act), article 12. Un produit comportant des éléments numériques classé système d’IA à haut risque, qui satisfait aux exigences essentielles du CRA, est réputé conforme aux exigences de cybersécurité de l’article 15 dans la mesure où c’est démontré dans la déclaration UE de conformité. Les obligations générales du CRA s’appliquent au 11 décembre 2027 (voir Cyber Resilience Act et les considérants 77 et 78).
Ces présomptions sont partielles. Elles ne disent rien de l’exactitude ni de la robustesse, et un certificat orienté produit ne couvre en général ni l’empoisonnement, ni l’invasion de modèle, ni l’inférence d’appartenance si son périmètre ne les mentionne pas. La recommandation est donc de lire le périmètre du certificat ligne à ligne et de documenter dans l’annexe IV point 2 h) ce qui reste couvert par des tests propres. Afficher « certifié » sans périmètre revient à présenter un permis de conduire pour justifier l’état des freins.
Ce que l’article 15 ne garantit pas et la frontière avec les articles 9, 10, 12 et 14
Section intitulée « Ce que l’article 15 ne garantit pas et la frontière avec les articles 9, 10, 12 et 14 »L’article 15 ne garantit pas l’absence de biais dans les données : c’est l’art. 10. Il ne fixe pas le niveau de risque acceptable : c’est l’art. 9, qui fournit les seuils que l’article 15 mesure. Il ne garantit pas la détection a posteriori : sans les journaux de l’art. 12, une campagne d’extraction lente reste invisible. Enfin, il ne garantit pas qu’un humain reprenne la main quand le système s’abstient : c’est l’art. 14.
L’article 15 ne garantit pas davantage la sécurité de l’infrastructure classique (gestion des identités, cloisonnement réseau, gestion des secrets), qui reste du ressort du socle de sécurité de l’organisation. Les détecteurs à base d’apprentissage ont leurs propres angles morts, décrits dans les limites du ML en détection. Enfin, les mesures déclarées n’ont de valeur que si elles figurent dans la documentation technique : un test non documenté n’existe pas pour l’autorité.
Exploitation : réentraînement, clés, supervision et reprise
Section intitulée « Exploitation : réentraînement, clés, supervision et reprise »- Chaque réentraînement constitue une nouvelle évaluation. La version doit être rejouée sur le jeu de référence gelé, segment par segment, avec la suite adverse, l’audit de mémorisation et la vérification des composants. Une régression au-delà de la tolérance fixée par l’art. 9 bloque la promotion, sans dérogation orale.
- Clés de signature des modèles. Il faut les conserver dans un module matériel, les séparer des identités qui entraînent et assurer leur rotation selon la politique de gestion de clés. L’environnement d’inférence refuse tout artefact non signé. Si l’équipe qui entraîne signe elle-même, la signature ne prouve rien d’autre que sa bonne humeur.
- Supervision. Il faut suivre en continu la dérive des entrées et des sorties par segment, le taux d’abstention (une hausse soudaine signale une dérive ou une sonde), les rafales de requêtes quasi identiques (signature d’une extraction) et les incidents de sécurité. Les outils sont décrits dans observabilité LLM en production.
- Sauvegarde et reprise. Il faut conserver les jeux d’entraînement versionnés, les modèles signés et le détecteur hors domaine des versions précédentes. La reprise après empoisonnement découvert tardivement exige de pouvoir réentraîner sans les données suspectes, ce qui suppose d’avoir gardé leur provenance.
- Mise à jour de la notice. Toute variation significative des indicateurs doit se répercuter dans la notice. Une notice qui décrit la version de lancement d’un système réentraîné plusieurs fois devient fausse sans que personne ne l’ait modifiée.
Exemple : notation de solvabilité (annexe III, point 5 b))
Section intitulée « Exemple : notation de solvabilité (annexe III, point 5 b)) »Cas fictif : un fournisseur met sur le marché un système d’évaluation de la solvabilité de personnes physiques, classé haut risque au titre de l’annexe III, point 5 b). Le schéma montre le traitement d’une demande et le cycle de réentraînement, avec les points de contrôle exigés par l’article 15.
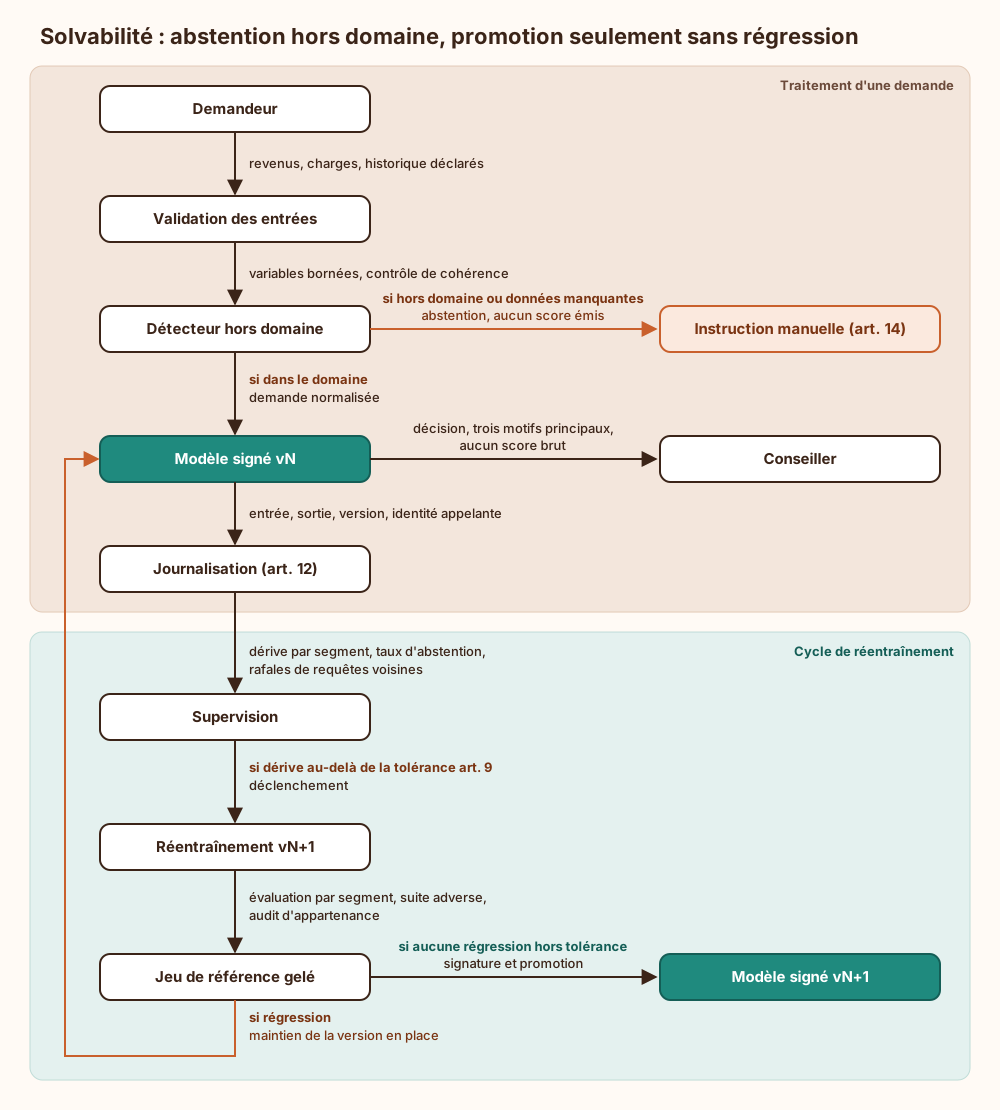
La notice déclare un taux de faux négatifs et de faux positifs par tranche de revenus, par ancienneté bancaire (avec un segment distinct pour les dossiers peu fournis) et en présence de données manquantes, avec les intervalles de confiance et la date du jeu de référence. Elle indique aussi les conditions dans lesquelles aucun chiffre n’est garanti. Le test d’invasion de modèle porte sur les variables déclaratives : un revenu majoré de manière plausible ne doit pas faire basculer la décision plus souvent que la tolérance fixée. Les étiquettes du réentraînement ne proviennent que des dossiers accordés : le jeu de référence gelé et la comparaison des distributions servent donc de garde-fou contre la boucle de rétroaction qui ferait disparaître les populations refusées. Pour limiter l’extraction, la réponse au conseiller se limite à la décision et à trois motifs.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans jeu de référence gelé, un réentraînement empoisonné passe en production avec des chiffres globaux inchangés, et rien ne permet de dater la version fautive ni de revenir à une version saine. Sans détecteur hors domaine, le modèle émet un score sur des dossiers qu’il n’a jamais appris à traiter, et ce score a la même apparence qu’un score fiable. Sans limitation des sorties, un tiers reconstitue le modèle par requêtes successives puis prépare hors ligne les entrées qui le font basculer. Sans indicateurs ventilés, la notice affiche une performance que le déployeur ne retrouvera jamais sur ses propres segments, et l’écart n’apparaît qu’au contrôle, sous forme de manquement aux obligations du fournisseur.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Certains programmes informatiques apprennent à décider à partir d’exemples, par exemple accorder ou non un prêt. La loi européenne sur ces programmes, dans son article 15, exige trois choses de ceux qui servent à prendre des décisions graves sur des personnes. D’abord, ils doivent annoncer honnêtement à quel point ils se trompent, et pas seulement en moyenne : le taux d’erreur doit être donné groupe par groupe, car un programme peut bien fonctionner pour la majorité et très mal pour une minorité. Ensuite, quand une demande ne ressemble à rien de ce qu’il a appris, le programme doit refuser de répondre et transmettre le dossier à une personne, au lieu d’inventer un résultat. Enfin, il doit résister aux tricheurs. Un tricheur peut glisser de faux exemples dans les données d’apprentissage pour fausser les décisions futures. Il peut modifier un programme récupéré sur Internet avant qu’on l’utilise. Il peut aussi gonfler légèrement les informations qu’il fournit pour obtenir un oui, ou interroger le programme des milliers de fois pour en recopier le fonctionnement et découvrir qui figurait dans les données d’apprentissage. Chaque fois que le programme réapprend, on le teste à nouveau sur un ensemble d’exemples qui ne change jamais. Si les résultats se dégradent, on garde l’ancienne version. Sans ces contrôles, les erreurs et les tricheries restent invisibles jusqu’au jour où quelqu’un en subit les conséquences.
À lire aussi
- Apprentissage automatique et réseaux de neurones, attaques du modèleComment un réseau de neurones apprend à partir de données (poids, perte, descente de gradient, rétropropagation) et où se placent l'empoisonnement, l'évasion, l'extraction et l'inversion sur le cycle de vie du modèle.
- AI Act : modèle d'IA à usage général présentant un risque systémique (articles 51, 52 et 55, annexe XIII)Classification d'un modèle d'IA à usage général à risque systémique selon l'AI Act : seuil de 10²⁵ FLOP, critères de l'annexe XIII, notification de l'article 52 et obligations de l'article 55.
- AI Act : articuler les obligations de sécurité avec NIS 2, le CRA et le RGPDComment le règlement (UE) 2024/1689 sur l'IA s'articule avec NIS 2, le Cyber Resilience Act et le RGPD : qui relève de quoi, quels ponts présument la conformité, ce qu'il faut refaire, comment notifier un incident en parallèle et mutualiser les preuves.
- AI Act : définition du système d'IA (article 3, point 1)Ce que l'article 3, point 1 de l'AI Act appelle un système d'IA, ses sept éléments, les quatre familles exclues par la Commission et la méthode pour qualifier un logiciel.
Pages voisines
La citent
- AI Act : articuler les obligations de sécurité avec NIS 2, le CRA et le RGPD
- AI Act : bacs à sable réglementaires et mesures PME (art. 57 à 63)
- AI Act : évaluation de la conformité, déclaration UE et marquage CE d'une IA à haut risque (articles 17, 43 et 49)
- AI Act : modèle d'IA à usage général présentant un risque systémique (articles 51, 52 et 55, annexe XIII)
AI Act : exactitude, robustesse et cybersécurité d'une IA à haut risque (article 15)
Elle cite
- AI Act : contrôle humain d'une IA à haut risque (article 14)
- AI Act : documentation technique d'une IA à haut risque (article 11, annexe IV)
- AI Act : gouvernance des données d'entraînement (article 10)
- AI Act : journalisation automatique d'une IA à haut risque (articles 12, 19 et 26)
- AI Act : système de gestion des risques d'une IA à haut risque (article 9)
- AI Act : calendrier d'application 2025-2030 et ce qui s'applique déjà
- AI Act : classer un système d'IA à haut risque (article 6, annexes I et III)
- AI Act : fournisseur, déployeur, importateur et requalification en fournisseur