
AI Act : gouvernance des données d'entraînement (article 10)
AI Act : gouvernance des données d’entraînement (article 10)
Section intitulée « AI Act : gouvernance des données d’entraînement (article 10) »L’article 10 de l’AI Act (règlement (UE) 2024/1689 sur l’intelligence artificielle) impose aux systèmes d’IA (intelligence artificielle) à haut risque des jeux de données d’entraînement, de validation et de test gouvernés, documentés et adaptés à leur destination. Depuis le règlement (UE) 2026/1744, le traitement de données sensibles pour corriger les biais ne relève plus de l’article 10, paragraphe 5, supprimé, mais d’un nouvel article 4 bis. Cette page détaille ce que le texte exige, ce qu’il faut construire pour le démontrer et ce qu’il ne garantit pas.
→ Lire l’explication complète de la marmotte
Périmètre de l’article 10 : qui, quoi, à partir de quand
Section intitulée « Périmètre de l’article 10 : qui, quoi, à partir de quand »L’article 10 ne vise que les systèmes à haut risque au sens de l’article 6 ; la qualification se fait en amont, voir la classification haut risque. L’obligation pèse sur le fournisseur, celui qui développe le système ou le fait développer et le met sur le marché sous son nom. Un déployeur qui modifie substantiellement un système ou change sa destination peut basculer dans ce rôle ; la mécanique est décrite dans rôles fournisseur et déployeur.
Le texte couvre trois familles de jeux : entraînement, validation et test (§1). Le §6 tranche un point que beaucoup d’équipes ignorent : pour un système à haut risque qui n’entraîne pas de modèle, seules les exigences relatives aux jeux de test s’appliquent. Le cas d’un système bâti sur un modèle tiers appelé par API, sans entraînement ni affinage par le fournisseur du système, avec un corpus de recherche documentaire (RAG, Retrieval-Augmented Generation), reste discuté : une lecture répandue le range sous le §6, puisque ce fournisseur n’entraîne rien, mais le texte ne le dit pas expressément et les lignes directrices de la Commission font foi. Le corpus documentaire, lui, n’est pas un jeu d’entraînement au sens de l’article 10. En revanche, sa qualité pèse sur la gestion des risques de l’article 9 et sur la robustesse de l’article 15. Le jeu de test, lui, reste pleinement exigible. Le cas du déployeur appuyé sur une API est traité dans AI Act et déploiement d’un modèle par API.
Calendrier : les exigences du haut risque s’appliquent au 2 décembre 2027 pour les systèmes de l’annexe III et au 2 août 2028 pour ceux de l’annexe I. Le détail, et les effets de l’omnibus, figurent dans le calendrier de l’AI Act. Un jeu de données constitué aujourd’hui sans traçabilité ne se reconstitue pas en 2027 ; la provenance perdue l’est définitivement.
Ce que l’article 10 exige des jeux de données
Section intitulée « Ce que l’article 10 exige des jeux de données »Le §2 liste huit sujets que les pratiques de gouvernance doivent couvrir. On les regroupe utilement en trois blocs d’ingénierie.
Provenance et hypothèses (points a, b et d) : les choix de conception, les processus de collecte, l’origine des données et, pour les données personnelles, la finalité initiale de la collecte. Il faut aussi les hypothèses sur ce que les données sont censées mesurer et représenter. Ce dernier point est le plus souvent absent. Un historique de décisions humaines mesure des décisions humaines, pas la grandeur que le modèle prétendra prédire. L’écrire noir sur blanc évite qu’un proxy se fasse passer pour la vérité terrain.
Préparation et adéquation (points c, e et h) : annotation, étiquetage, nettoyage, mise à jour, enrichissement, agrégation ; évaluation de la disponibilité, de la quantité et de l’adéquation ; détection des lacunes qui empêchent le respect du règlement et manière de les combler. Chaque opération de préparation est une transformation qui doit laisser une trace, sinon le jeu final n’est plus explicable.
Biais (points f et g) : examen des biais susceptibles de nuire à la santé, à la sécurité, aux droits fondamentaux ou de conduire à une discrimination interdite. Le texte insiste sur les boucles de rétroaction, quand les sorties du système influencent ses entrées futures. S’y ajoutent les mesures de détection, de prévention et d’atténuation.
Les §3 et §4 fixent le résultat attendu. Les jeux sont « pertinents, suffisamment représentatifs et, dans toute la mesure possible, exempts d’erreurs et complets » au regard de la destination. Ils ont les propriétés statistiques appropriées, y compris pour les personnes ou groupes visés. Ils tiennent compte du cadre géographique, contextuel, comportemental ou fonctionnel d’utilisation. Le §3 admet que ces caractéristiques soient atteintes par une combinaison de jeux plutôt que jeu par jeu : un jeu de test enrichi peut compenser une sous-représentation dans l’entraînement, à condition de le documenter.
Le « dans toute la mesure possible » n’est pas une échappatoire. En pratique, il se lit comme une obligation de moyens documentée : le fournisseur montre ce qu’il a mesuré, ce qu’il a corrigé et pourquoi le résidu est acceptable. Vingt ans de projets data apprennent que « les données sont propres » est la phrase prononcée juste avant la découverte d’une colonne de dates au format américain dans un tiers des lignes. Les erreurs de ce genre ne lèvent aucune exception, elles faussent le résultat en silence : voir la qualité des données et l’erreur silencieuse.
La preuve atterrit ailleurs dans le règlement. L’article 11 et l’annexe IV, point 2 d), exigent dans la documentation technique des fiches de données : provenance, étendue, caractéristiques, méthodes d’obtention et de sélection, étiquetage, nettoyage. L’article 17 fait entrer la gestion des données dans le système de gestion de la qualité. L’article 10 dit quoi faire ; l’annexe IV dit quoi montrer.
Lignage des jeux de données : le compromis central
Section intitulée « Lignage des jeux de données : le compromis central »Le compromis est le suivant. Une traçabilité fine (chaque version de jeu identifiée de manière immuable, chaque transformation enregistrée, chaque modèle rattaché à la version exacte qui l’a entraîné) coûte du stockage, des outils et de la discipline dans les pipelines. En échange, elle permet de répondre en minutes à la seule question qu’un audit posera : sur quelles données exactement ce modèle a-t-il appris, et qu’est-ce qui a changé depuis ? Sans elle, chaque fiche de données de l’annexe IV est une reconstitution narrative, invérifiable et fausse dès la ré-exécution suivante du pipeline.
Position : traiter un jeu de données comme un artefact de build. Chaque version est identifiée par l’empreinte cryptographique de son contenu (manifeste listant l’empreinte SHA-256 de chaque fichier ou partition, puis empreinte du manifeste). Elle est stockée en écriture unique, et la fiche de données est générée par le pipeline, pas rédigée à la main après coup. Un tableur de suivi maintenu par une personne n’est pas un lignage : c’est un souvenir.
Cette approche tient à deux conditions. Le stockage doit supporter l’immutabilité (verrouillage d’objet ou équivalent), et l’empreinte doit porter sur les données réellement lues par l’entraînement, pas sur une copie amont qui a pu diverger. Le schéma ci-dessous montre le cycle de vie attendu ; on y lit que la fiche de données et l’enregistrement du modèle consomment tous deux l’empreinte du manifeste, ce qui les lie sans ambiguïté.
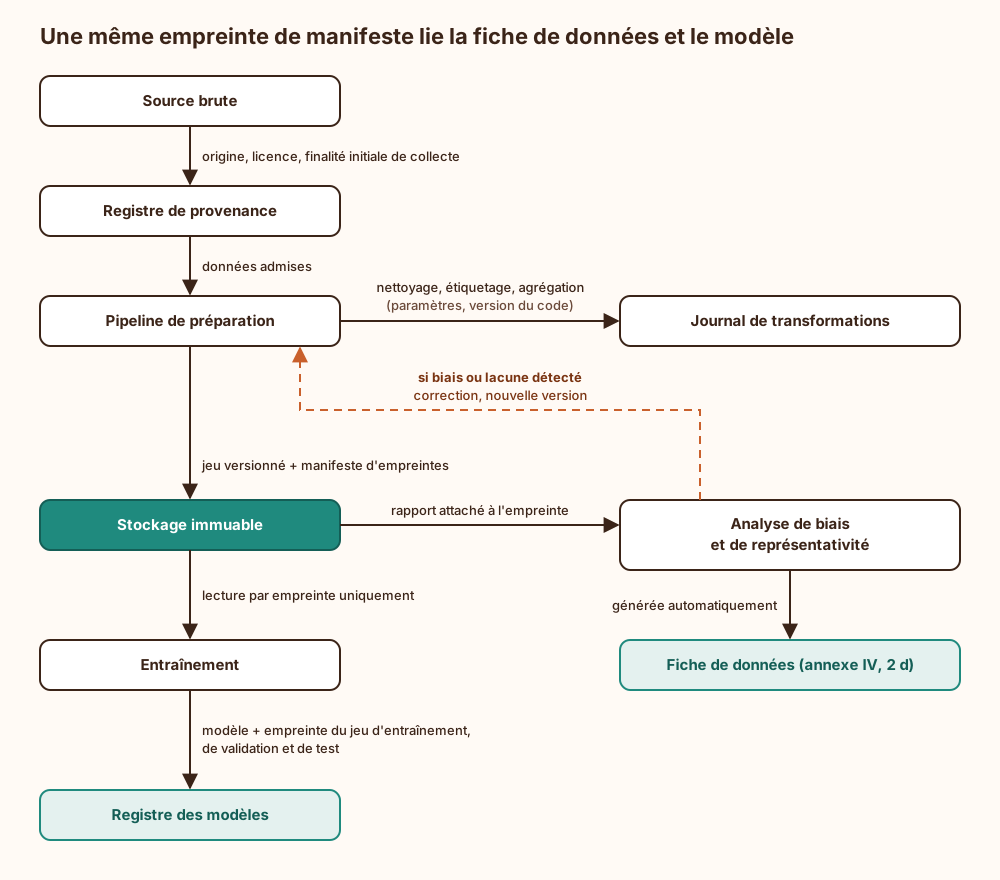
Deux pièges reviennent systématiquement. Le premier est la contamination entre entraînement et test : des doublons ou quasi-doublons présents des deux côtés gonflent les métriques et rendent l’évaluation de représentativité sans valeur. La séparation doit se faire par entité (personne, dossier, site), pas par ligne. Le second est la mise à jour silencieuse : un jeu « rafraîchi » sous le même nom casse le lien avec le modèle déjà en production. La règle d’or : un nouveau contenu produit une nouvelle empreinte, toujours.
ISO/IEC 5259 (qualité des données pour l’analytique et l’apprentissage automatique) fournit un vocabulaire et des métriques de qualité exploitables comme référence de travail. Elle n’apporte aucune présomption de conformité. Les normes harmonisées préparées au CEN-CENELEC (Comité européen de normalisation et Comité européen de normalisation électrotechnique), au sein de son comité technique JTC 21 (Joint Technical Committee 21), n’apportent de présomption de conformité (article 40) qu’une fois leur référence publiée au JO (Journal officiel de l’Union européenne) ; la liste se vérifie sur EUR-Lex. Présenter un projet de norme comme un bouclier relève de la diapositive commerciale.
Biais et données sensibles : le régime de l’article 4 bis
Section intitulée « Biais et données sensibles : le régime de l’article 4 bis »Mesurer un biais envers un groupe suppose souvent de connaître l’appartenance à ce groupe : origine raciale ou ethnique, santé, convictions religieuses, orientation sexuelle. Ce sont des catégories particulières au sens de l’article 9 du RGPD (Règlement général sur la protection des données). La tension avec la minimisation est réelle, et la page gestion des risques la mentionne.
L’ancien article 10, §5 qui l’encadrait est supprimé par le règlement (UE) 2026/1744, en vigueur depuis le 27 juillet 2026. Le régime actuel est l’article 4 bis. Son §1 autorise les fournisseurs de systèmes à haut risque à traiter exceptionnellement ces données, dans la mesure strictement nécessaire à la détection et à la correction des biais au titre de l’article 10, §2, f) et g). Il faut des garanties appropriées et que toutes les conditions suivantes soient réunies :
- a) impossibilité d’y parvenir efficacement avec d’autres données, y compris synthétiques ou anonymisées ;
- b) limitations techniques à la réutilisation et mesures de sécurité et de vie privée de pointe, dont la pseudonymisation ;
- c) mesures de sécurité, contrôles stricts et documentation des accès ;
- d) aucune transmission, aucun transfert, aucun accès par d’autres parties ;
- e) suppression une fois le biais corrigé ou à la fin de la durée de conservation, selon la première échéance ;
- f) mention, dans le registre des activités de traitement, des raisons pour lesquelles le traitement était strictement nécessaire.
Le §2 étend la même faculté, aux mêmes conditions, aux fournisseurs et déployeurs des autres systèmes et modèles d’IA ainsi qu’aux déployeurs de systèmes à haut risque. Il faut des biais touchant la santé, la sécurité, les droits fondamentaux ou conduisant à une discrimination interdite. Ce paragraphe ne crée aucune obligation de rechercher les biais : c’est une permission, pas un devoir. Pour un système à haut risque, le devoir vient de l’article 10, §2, f) et g).
Le RGPD, article 9 compris, continue de s’appliquer en plus. L’article 4 bis encadre le traitement côté AI Act ; il ne dispense ni de l’analyse de la base légale, ni de l’analyse d’impact relative à la protection des données (AIPD), qu’un tel traitement déclenche en pratique presque toujours. Pour une situation donnée, la lecture du texte consolidé sur EUR-Lex et un avis juridique restent la seule réponse.
Position d’architecture : la condition a) se plaide par écrit, avec des essais. Il faut documenter la tentative sur données synthétiques, sur agrégats ou sur variables de substitution, et la raison de son échec (biais non détecté, intervalle de confiance trop large). Si l’exception est retenue, les données sensibles vivent dans une enclave séparée du pipeline d’entraînement principal. Seuls des indicateurs agrégés de biais en sortent, jamais des lignes. Une pseudonymisation ne rend pas une donnée anonyme (la différence est détaillée ici) : un identifiant stable joint à quelques attributs quasi identifiants suffit à réidentifier. C’est précisément pourquoi le texte l’exige comme garantie et non comme sortie du régime.
Surface d’attaque et limites de l’article 10
Section intitulée « Surface d’attaque et limites de l’article 10 »L’article 10 est une exigence de qualité, pas une exigence de sécurité. Les attaques sur les données relèvent de l’article 15, dont le §5 vise explicitement l’empoisonnement. Elles traversent pourtant chaque étape du lignage.
| Attaque | Point d’entrée | Contre-mesure |
|---|---|---|
| Empoisonnement de jeu tiers | Source brute, jeu public téléchargé | Empreinte vérifiée à l’ingestion, provenance signée quand elle existe, détection d’anomalies de distribution |
| Retournement d’étiquettes | Annotation externalisée | Double annotation sur échantillon, mesure d’accord inter-annotateurs, traçabilité par annotateur |
| Altération post-validation | Stockage du jeu | Écriture unique, lecture par empreinte, journal d’accès |
| Boucle de rétroaction exploitée | Sorties réinjectées en entraînement | Quarantaine des données issues du système, réentraînement sur jeu figé et comparé |
| Réidentification dans l’enclave | Jeu pseudonymisé article 4 bis | Pas de sortie ligne à ligne, agrégats avec seuil minimal d’effectif, accès nominatifs journalisés |
| Inférence d’appartenance | Modèle entraîné exposé | Limitation des sorties de confiance, évaluation dédiée avant mise en service |
Le détail des techniques d’empoisonnement et de leurs signaux se trouve dans empoisonnement des données d’entraînement. Pour un corpus documentaire, voir sécuriser un corpus RAG.
Ce que l’article 10 ne garantit pas :
- La performance du modèle : un jeu irréprochable n’empêche pas un modèle inexact ou fragile ; exactitude et robustesse relèvent de l’article 15, et les tests associés de l’article 9.
- La licéité de la collecte : la finalité initiale doit être documentée (§2 b), mais sa compatibilité avec la réutilisation se juge au regard du RGPD. Les droits de propriété sur les données se jugent ailleurs encore.
- L’équité en production : la représentativité est évaluée au moment de la constitution du jeu. La dérive de population après mise en service se détecte par la surveillance après commercialisation (article 72), pas par la fiche de données.
- La sécurité des pipelines : intégrité du stockage, gestion des identités et des secrets des chaînes de traitement relèvent de la sécurité classique.
Exploitation : clés, journaux, sauvegardes et suppression
Section intitulée « Exploitation : clés, journaux, sauvegardes et suppression »Le lignage repose sur des empreintes et, idéalement, sur des signatures de manifestes. La clé de signature doit vivre hors du pipeline qui produit les jeux (module matériel ou service de gestion de clés). Sinon un pipeline compromis signe ses propres falsifications, ce qui revient à confier le registre des entrées au cambrioleur. La rotation de cette clé impose de conserver les clés publiques historiques : un manifeste de 2027 doit rester vérifiable pendant toute la durée de conservation de la documentation technique, soit dix ans après la mise sur le marché ou la mise en service (article 18).
L’enclave de l’article 4 bis exige une journalisation exhaustive des accès (condition c) dans un puits séparé, non modifiable par les administrateurs de l’enclave. Une alerte doit être prévue sur tout export autre qu’agrégé.
Le piège le plus coûteux est la suppression de la condition e). Effacer les données sensibles de l’enclave ne suffit pas si elles dorment dans les sauvegardes, les instantanés de volumes et les caches de préparation (le cycle de vie d’une donnée en recense les copies habituelles). La méthode qui tient : chiffrer ces données avec une clé dédiée au traitement, puis détruire cette clé à l’échéance (effacement cryptographique). Cela suppose qu’aucune copie de la clé ne figure dans les sauvegardes du service de gestion de clés lui-même. La date de destruction de la clé et la référence du biais corrigé alimentent alors le registre de la condition f).
Côté reprise : les jeux versionnés font partie du périmètre de sauvegarde au même titre que le code. Un modèle dont le jeu d’entraînement a disparu reste exploitable mais devient indémontrable.
Exemple : décision d’usage de données sensibles chez Gravillon Analytique
Section intitulée « Exemple : décision d’usage de données sensibles chez Gravillon Analytique »Gravillon Analytique, éditeur fictif, fournit un système de tri de candidatures, classé haut risque au titre de l’annexe III, point 4 a). L’analyse de biais (article 10, §2, f) révèle un écart de taux de présélection inexpliqué entre tranches d’âge. Elle soupçonne aussi un écart lié au handicap, une donnée de santé donc sensible. Le schéma suit la décision : on y lit que l’exception de l’article 4 bis n’intervient qu’après échec documenté des alternatives, et que chaque branche laisse une trace dans le registre.
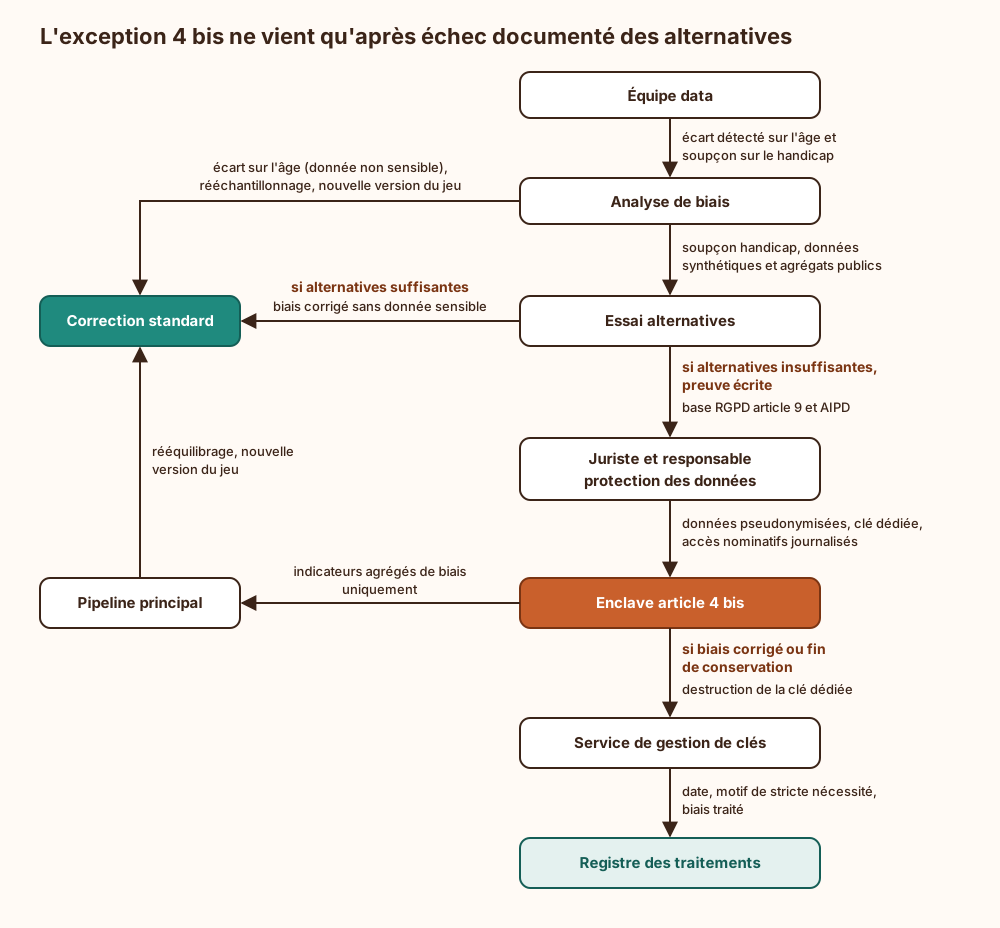
L’écart sur l’âge se traite sans régime d’exception, l’âge n’étant pas une catégorie particulière au sens de l’article 9 du RGPD. Le soupçon sur le handicap suit le chemin long. Si les données synthétiques permettent de mesurer et corriger l’écart, l’enclave n’est jamais ouverte, et c’est le meilleur résultat possible. Sinon, l’enclave ne laisse sortir que des indicateurs agrégés, et la destruction de la clé matérialise la suppression exigée par la condition e).
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans lignage par empreinte, aucun modèle ne se rattache de façon prouvable aux données qui l’ont formé. Un empoisonnement découvert après coup ne permet alors ni de délimiter les versions touchées ni de revenir à un jeu sain : le seul retour possible est le réentraînement complet sur des données dont l’intégrité reste invérifiable. Les boucles de rétroaction non surveillées laissent le système amplifier ses propres écarts à chaque réentraînement. Côté données sensibles, une enclave sans effacement cryptographique laisse survivre ces données dans les sauvegardes au-delà de l’échéance légale. Enfin, la fiche de données exigée par l’annexe IV devient une reconstitution impossible à défendre face à une autorité de surveillance.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Certains programmes informatiques apprennent à prendre des décisions graves, par exemple trier des candidatures, en étudiant beaucoup d’exemples passés. Une loi européenne oblige ceux qui fabriquent ces programmes à surveiller ces exemples de près. D’abord, ils doivent noter d’où vient chaque donnée, pourquoi elle avait été récoltée et ce qu’on a modifié dessus : corrections, étiquettes ajoutées, regroupements. Ensuite, ils vérifient que les exemples représentent bien toutes les personnes concernées, sans oublier un groupe. Si un groupe est mal traité, ils doivent le repérer et corriger. Pour garder la preuve, chaque version des données reçoit une empreinte, une sorte de code calculé à partir de son contenu : si une seule ligne change, le code change. Le programme entraîné est rattaché à ce code précis. Parfois, pour vérifier qu’un programme ne défavorise pas des personnes malades ou handicapées, il faudrait utiliser des informations très privées. La loi l’autorise seulement si aucune autre méthode ne marche, dans un espace fermé et surveillé, sans partage, et avec effacement à la fin. Quand ce travail manque, on ne peut plus prouver sur quoi le programme a appris, une donnée piégée glissée par un attaquant passe inaperçue, et des informations privées peuvent traîner dans des copies de secours.
À lire aussi
- AI Act : documentation technique d'une IA à haut risque (article 11, annexe IV)Ce que l'article 11 et l'annexe IV du règlement (UE) 2024/1689 imposent au fournisseur d'un système d'IA à haut risque en matière de documentation technique, et comment la produire et l'exploiter sans qu'elle se périme.
- AI Act : contrôle humain d'une IA à haut risque (article 14)Concevoir le contrôle humain d'un système d'IA à haut risque au sens de l'article 14 du règlement (UE) 2024/1689, du partage fournisseur et déployeur jusqu'au bouton d'arrêt.
- AI Act : bacs à sable réglementaires et mesures PME (art. 57 à 63)Ce que les articles 57 à 63 de l'AI Act, modifiés par le règlement (UE) 2026/1744, prévoient pour les bacs à sable réglementaires de l'IA, les essais en conditions réelles et les allègements destinés aux PME, avec les exigences d'architecture qui en découlent.
- AI Act : exactitude, robustesse et cybersécurité d'une IA à haut risque (article 15)Ce que l'article 15 du règlement (UE) 2024/1689 exige d'un système d'IA à haut risque en exactitude, robustesse et cybersécurité, de l'empoisonnement des données aux attaques sur la confidentialité, et comment le mettre en œuvre.
Pages voisines
La citent
- AI Act : contrôle humain d'une IA à haut risque (article 14)
- AI Act : documentation technique d'une IA à haut risque (article 11, annexe IV)
- AI Act : exactitude, robustesse et cybersécurité d'une IA à haut risque (article 15)
- AI Act : journalisation automatique d'une IA à haut risque (articles 12, 19 et 26)
- AI Act : articuler les obligations de sécurité avec NIS 2, le CRA et le RGPD
- AI Act : évaluation de la conformité, déclaration UE et marquage CE d'une IA à haut risque (articles 17, 43 et 49)
- AI Act : obligations du déployeur d'une IA à haut risque (article 26)
AI Act : gouvernance des données d'entraînement (article 10)
Elle cite
- AI Act : système de gestion des risques d'une IA à haut risque (article 9)
- AI Act : calendrier d'application 2025-2030 et ce qui s'applique déjà
- AI Act : classer un système d'IA à haut risque (article 6, annexes I et III)
- AI Act : fournisseur, déployeur, importateur et requalification en fournisseur
- AI Act : normes harmonisées et organismes notifiés (articles 28 à 41)