
Continuité, sauvegardes, PRA/PCA et haute disponibilité
Continuité, sauvegardes, PRA/PCA et haute disponibilité
Section intitulée « Continuité, sauvegardes, PRA/PCA et haute disponibilité »Un service tombe pour trois grandes familles de raisons : un composant casse, un humain se trompe, un attaquant détruit. La haute disponibilité répond à la première, les sauvegardes aux deux autres, et les plans de continuité organisent le tout autour de deux chiffres que la direction doit avoir choisis avant l’incident plutôt que découverts pendant. Cette fiche part des composants, disques, cartes réseau, serveurs, alimentation, remonte vers les sauvegardes et leur résistance aux rançongiciels, puis aborde le PCA (Plan de Continuité d’Activité) et le PRA (Plan de Reprise d’Activité) sous l’angle du réseau.
→ Lire l’explication complète de la marmotte
Disponibilité des composants
Section intitulée « Disponibilité des composants »Mesurer la disponibilité
Section intitulée « Mesurer la disponibilité »La disponibilité est la fraction du temps pendant laquelle un service rend effectivement le service attendu. Les « neuf » se traduisent en durées d’arrêt annuelles qui parlent davantage :
| Disponibilité | Arrêt toléré par an | Par mois (30 jours) |
|---|---|---|
| 99 % | 3 jours 15 heures | 7 heures 12 minutes |
| 99,9 % | 8 heures 46 minutes | 43 minutes |
| 99,99 % | 53 minutes | 4 minutes 19 secondes |
| 99,999 % | 5 minutes 15 secondes | 26 secondes |
Les composants en série multiplient leurs disponibilités : un service qui dépend d’un pare-feu, d’un commutateur et d’un serveur, chacun disponible à 99,9 %, plafonne à 0,999³ ≈ 99,7 %. Les composants en parallèle se complètent : deux serveurs à 99 % dont un seul suffit donnent 1 − 0,01² = 99,99 %, à condition que leurs pannes soient indépendantes. Toute la difficulté est là.
Repérer les points uniques de panne
Section intitulée « Repérer les points uniques de panne »Un SPOF (Single Point Of Failure, point unique de panne) est un élément dont la défaillance arrête le service à lui seul. La méthode consiste à suivre une requête de bout en bout et à poser à chaque étape la question « et si cela disparaît ? » : lien opérateur, routeur de bordure, pare-feu, commutateur de cœur, alimentation de la baie, serveur, contrôleur de stockage, base de données, mais aussi annuaire, DNS (Domain Name System), serveur de temps et certificat. Les SPOF les plus traîtres ne sont pas matériels : une seule clé de licence, un seul administrateur qui connaît la procédure, un seul compte de nuage dont la suspension coupe tout.
L’alimentation illustre bien la logique : deux blocs d’alimentation par serveur, branchés sur deux circuits distincts, chacun secouru par un onduleur, eux-mêmes derrière un groupe électrogène. Brancher les deux blocs sur la même multiprise transforme une redondance coûteuse en décoration.
Stockage : miroir, parité et secteurs
Section intitulée « Stockage : miroir, parité et secteurs »Le RAID (Redundant Array of Independent Disks) répartit les données sur plusieurs disques pour survivre à la perte de certains d’entre eux :
| Niveau | Principe | Disques perdus tolérés | Capacité utile avec 6 disques de 8 To |
|---|---|---|---|
| RAID 1 | miroir | tous sauf un | 8 To (les six disques portent la même copie) |
| RAID 5 | parité simple répartie | 1 | 40 To |
| RAID 6 | double parité | 2 | 32 To |
| RAID 10 | miroirs agrégés | 1 par miroir | 24 To |
La parité est un OU exclusif calculé sur les blocs de données : connaissant tous les blocs sauf un, et leur parité, on reconstruit le manquant. Pendant la reconstruction, tous les disques restants sont relus intégralement, et sur des disques de grande capacité une erreur de lecture irrécupérable devient probable ; c’est pourquoi le RAID 5 est déconseillé sur de gros disques au profit du RAID 6 ou du RAID 10. Le miroir de contrôleurs double en plus la carte qui pilote les disques, autre SPOF classique.
Les disques eux-mêmes neutralisent les secteurs défectueux en les réaffectant à une réserve ; l’attribut SMART (Self-Monitoring, Analysis and Reporting Technology) Reallocated_Sector_Ct en tient le compte, et sa croissance annonce une panne. Un nettoyage périodique (zpool scrub, ou echo check > /sys/block/md0/md/sync_action avec mdadm) relit tout le volume pour détecter les erreurs latentes avant qu’une reconstruction ne les découvre. La fiabilisation du stockage passe aussi par les sommes de contrôle de bout en bout, comme celles de ZFS ou Btrfs, qui détectent une corruption silencieuse là où le RAID classique rend fidèlement la donnée abîmée.
La confidentialité des échanges et des systèmes de fichiers interfère avec la disponibilité : un volume chiffré dont la clé n’existe que sur le serveur détruit est perdu avec lui. Les clés et phrases de récupération font partie de ce qu’il faut sauvegarder, ailleurs.
Réseau et serveurs redondants
Section intitulée « Réseau et serveurs redondants »Côté réseau, le teaming NIC (Network Interface Card), appelé bonding sous Linux, agrège plusieurs cartes. Le mode active-backup bascule sur la carte de secours si la principale perd le lien, sans configuration du commutateur ; le mode 802.3ad utilise LACP (Link Aggregation Control Protocol, normalisé aujourd’hui dans l’IEEE 802.1AX) pour agréger la bande passante, ce qui suppose que les deux liens arrivent sur le même commutateur logique, une pile ou une paire en MLAG (Multi-Chassis Link Aggregation). Deux cartes reliées au même commutateur ne protègent pas de la panne de ce commutateur.
La redondance serveur prend deux formes. Le load balancing (répartition de charge) distribue les requêtes entre plusieurs serveurs actifs et retire de la rotation ceux qui échouent aux contrôles de santé. Le basculement actif/passif maintient un nœud de secours qui reprend l’adresse de service, souvent par VRRP (Virtual Router Redundancy Protocol, RFC 5798 pour la version 3) : l’adresse virtuelle passe au routeur ou au serveur de secours en quelques secondes. La virtualisation ajoute la migration à chaud et le redémarrage automatique des machines virtuelles sur un autre hôte, mais concentre beaucoup de services sur un stockage partagé qui devient le SPOF suivant.
Tolérance et reprise
Section intitulée « Tolérance et reprise »La tolérance de panne absorbe la défaillance sans interruption perceptible : le RAID continue, le second lien prend le relais. La reprise rétablit le service après une interruption : on restaure, on redémarre ailleurs, on bascule sur un autre site. La première coûte en matériel permanent, la seconde en temps d’arrêt. Aucune des deux ne protège contre une donnée effacée par erreur ou chiffrée par un attaquant, puisque la redondance réplique fidèlement le désastre.
Sauvegarde et restauration
Section intitulée « Sauvegarde et restauration »Complète, incrémentale, différentielle
Section intitulée « Complète, incrémentale, différentielle »Une sauvegarde complète copie tout. Une incrémentale copie ce qui a changé depuis la dernière sauvegarde, quelle qu’elle soit. Une différentielle copie ce qui a changé depuis la dernière complète. Sur une semaine avec une complète le dimanche :
| Volume sauvegardé chaque jour | Restauration du jeudi | |
|---|---|---|
| Incrémentale | faible, constant | complète du dimanche + lundi + mardi + mercredi + jeudi |
| Différentielle | croissant au fil de la semaine | complète du dimanche + différentielle du jeudi |
L’incrémentale économise le stockage et la fenêtre de sauvegarde, mais allonge la chaîne de restauration : un maillon illisible rend inutilisables tous les suivants. Les outils modernes à déduplication (Borg, restic et les solutions commerciales) brouillent la distinction en présentant chaque sauvegarde comme complète tout en ne stockant que les blocs nouveaux.
Immutabilité et sanctuarisation
Section intitulée « Immutabilité et sanctuarisation »Un rançongiciel moderne cherche les sauvegardes avant de chiffrer quoi que ce soit, avec les identifiants d’administration qu’il a volés. Une sauvegarde qu’un administrateur du domaine peut effacer est une sauvegarde que l’attaquant effacera. Deux protections se combinent.
L’immutabilité rend une copie non modifiable et non supprimable pendant une durée fixée, y compris par un administrateur : stockage WORM (Write Once Read Many), verrouillage d’objets en mode conformité chez les fournisseurs de stockage objet, dépôts de sauvegarde durcis. La sanctuarisation isole l’infrastructure de sauvegarde du reste : comptes d’administration dédiés hors de l’annuaire de production, authentification forte, réseau séparé, et au moins une copie hors ligne. La règle dite 3-2-1 résume l’ensemble : trois copies, sur deux supports différents, dont une hors site ; sa variante 3-2-1-1-0 ajoute une copie hors ligne ou immuable et zéro erreur aux tests de vérification.
La réplication n’est pas l’immutabilité : elle recopie en temps réel les suppressions et les chiffrements, ce qui en fait un excellent outil de disponibilité et un très mauvais outil de sauvegarde. La fiche sauvegardes et tests de restauration détaille la vérification côté données.
PRA, PCA et réseau
Section intitulée « PRA, PCA et réseau »RTO, RPO et scénarios
Section intitulée « RTO, RPO et scénarios »Le PCA décrit comment l’activité continue pendant l’incident, éventuellement en mode dégradé : site de secours, procédures manuelles, sous-traitance temporaire. Le PRA décrit comment rétablir les systèmes après l’incident. Le premier est une démarche de l’organisation entière, le second un sous-ensemble essentiellement technique ; la norme ISO 22301 encadre le management de la continuité d’activité.
Deux objectifs fixent les exigences. Le RTO (Recovery Time Objective) est la durée maximale acceptable entre l’arrêt et le retour du service, appelée aussi DMIA (durée maximale d’interruption admissible). Le RPO (Recovery Point Objective) est la quantité maximale de données qu’on accepte de perdre, exprimée en temps, ou PDMA (perte de données maximale admissible). Un RPO de 24 heures se satisfait d’une sauvegarde nocturne ; un RPO de quelques secondes impose une réplication synchrone ou quasi synchrone, et donc, pour se prémunir contre la destruction, des instantanés immuables en plus.
L’atelier consiste à construire une matrice RTO/RPO par service, en partant de l’impact métier et non de la technique disponible :
| Service | Impact d’un arrêt | RTO | RPO | Moyens |
|---|---|---|---|---|
| Boutique en ligne | perte de chiffre d’affaires immédiate | 1 h | 5 min | deux sites actifs, réplication de base, DNS de bascule |
| Messagerie | gêne forte, pas de perte directe | 4 h | 1 h | service hébergé, sauvegarde tierce |
| Paie | critique en fin de mois | 24 h | 24 h | sauvegarde nocturne immuable, restauration testée |
| Intranet documentaire | gêne modérée | 72 h | 24 h | sauvegarde nocturne |
| Configuration réseau | prérequis de tout le reste | 2 h | dernière modification | export automatique, copie hors site |
Chaque ligne se confronte ensuite à des scénarios : panne d’un équipement, perte d’un site (incendie, inondation), coupure d’un opérateur, rançongiciel sur tout le domaine. Le rançongiciel est le plus exigeant, car il interdit de faire confiance aux systèmes restants et suppose de reconstruire l’annuaire avant le reste. Certains secteurs ajoutent des exigences propres ; le règlement européen DORA (Digital Operational Resilience Act), applicable depuis janvier 2025, impose ainsi aux acteurs financiers des tests de résilience réguliers.
Le réseau dans la reprise
Section intitulée « Le réseau dans la reprise »Le réseau est à la fois un prérequis et un SPOF fréquent. L’atelier « deux liens WAN (Wide Area Network) et deux pare-feu » se dessine ainsi :
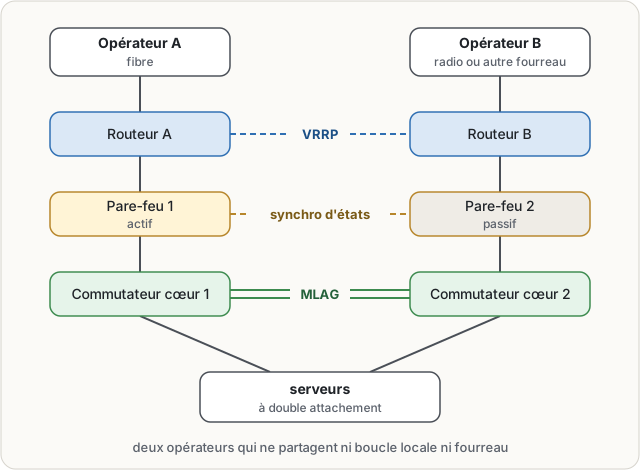
Plusieurs conditions rendent ce schéma réel. Les deux opérateurs ne doivent pas partager la même boucle locale ni le même fourreau : deux contrats qui empruntent la même tranchée cèdent ensemble à la même pelleteuse, phénomène bien documenté. Le basculement de l’adresse publique exige soit un multihébergement en BGP (Border Gateway Protocol) avec ses propres adresses (voir BGP, Internet et anycast), soit une bascule DNS avec un TTL (Time To Live) court, sachant que certains clients ignorent ce TTL (voir DNS, DHCP, NTP). La paire de pare-feu doit synchroniser les états de connexion, faute de quoi chaque bascule coupe toutes les sessions. Enfin, un site de secours doit disposer de règles de filtrage, de routes et de certificats à jour, ce qui suppose qu’ils soient gérés comme le site principal et non recopiés une fois à l’installation.
Procédure de restauration d’une configuration réseau
Section intitulée « Procédure de restauration d’une configuration réseau »Une configuration réseau non sauvegardée se reconstruit de mémoire, c’est-à-dire mal. La procédure type tient sur une page :
- Sauvegarde automatique : un outil de collecte récupère la configuration de chaque équipement après chaque modification et chaque nuit, la verse dans un dépôt versionné, avec une copie hors site.
- Inventaire : modèle, version logicielle, numéro de série et accès console de chaque équipement, conservés hors du réseau qu’ils décrivent.
- Restauration : équipement de remplacement à la même version logicielle, accès console, chargement de la dernière configuration validée, réinjection des secrets (clés, certificats, mots de passe) depuis le coffre, puisqu’ils sont souvent masqués dans les exports.
- Vérification : comparaison de la configuration active avec la référence, tests de connectivité et de filtrage prévus à l’avance, contrôle des voisinages de routage.
- Traçabilité : durée réelle mesurée et comparée au RTO.
Tester régulièrement
Section intitulée « Tester régulièrement »Seul un test de restauration transforme une sauvegarde en garantie. Les tests vont du plus simple au plus complet : restaurer un fichier au hasard chaque semaine, une machine entière chaque mois dans un réseau isolé, un service complet avec ses dépendances chaque trimestre, et un exercice de bascule de site au moins une fois par an. Chaque test mesure la durée réelle, révèle les dépendances oubliées et met à jour la procédure. La supervision des sauvegardes elles-mêmes, échecs, volumes anormaux, suppressions massives, relève de la gestion et supervision du réseau.
Pièges et confusions
Section intitulée « Pièges et confusions »Confondre sauvegarde et continuité conduit à disposer de toutes les données et d’aucun moyen de les remettre en service dans les délais. Ne jamais tester la restauration laisse découvrir le jour J un format illisible ou une clé perdue. Créer une redondance dépendant du même opérateur, du même fourreau, du même fournisseur d’énergie ou du même compte d’administration reproduit le SPOF à un étage où personne ne le cherche.
Le PCA n’est pas le PRA : maintenir l’activité pendant la crise et rétablir les systèmes après sont deux plans distincts, qui se répondent. La haute disponibilité n’est pas une sauvegarde : elle supprime l’arrêt, pas la perte. La réplication n’est pas l’immutabilité : la première copie tout, y compris le pire, la seconde refuse de l’oublier.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans sauvegarde isolée ni immuable, un rançongiciel qui atteint les serveurs chiffre aussi les copies accessibles depuis eux, et la réplication, fidèle, propage la destruction partout en temps réel. Sans objectifs de reprise écrits, la durée d’arrêt et la quantité de données perdues se découvrent pendant la crise au lieu d’être choisies avant. Sans test de restauration, une sauvegarde reste une hypothèse : un format devenu illisible, une clé de chiffrement conservée sur le serveur détruit ou une configuration réseau jamais sauvegardée ne se révèlent qu’au moment où l’on en a besoin. Une infrastructure qui n’a jamais doublé ses composants critiques transforme enfin la panne d’un seul équipement en arrêt de tout le service.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Un service informatique dépend de nombreux éléments : le réseau, les serveurs, les disques, l’alimentation électrique. La première étape consiste à repérer les éléments uniques dont la panne arrête tout, puis à les doubler. Les disques peuvent être écrits en double, ou accompagnés de données de contrôle, appelées parité, qui permettent de reconstruire un disque perdu. Plusieurs serveurs peuvent rendre le même service, avec un répartiteur qui envoie les demandes vers ceux qui fonctionnent. Cette redondance permet de continuer malgré une panne, mais elle ne protège pas contre une erreur ou une attaque : une donnée effacée, ou chiffrée par un rançongiciel, l’est aussitôt sur la copie. C’est le rôle des sauvegardes, qui gardent des états passés. Une sauvegarde complète copie tout ; une incrémentale ne copie que ce qui a changé depuis la dernière sauvegarde ; une différentielle, ce qui a changé depuis la dernière complète. Pour résister à un attaquant, certaines copies doivent être impossibles à modifier ou placées hors de sa portée. Le plan de continuité décrit comment maintenir l’activité pendant l’incident, le plan de reprise comment la rétablir après. Deux valeurs guident ces plans : la durée d’arrêt acceptable et la quantité de données qu’on accepte de perdre. Seuls des tests de restauration réguliers prouvent que tout cela fonctionne.
À lire aussi
- DORA et résilience opérationnelle numérique financièreDORA encadre la résilience opérationnelle numérique des entités financières, leurs prestataires et leurs dispositifs de gestion des risques informatiques.
- Sécurité des systèmes bancaires et financiersLes systèmes bancaires et financiers combinent exigences PCI DSS, DORA, disponibilité continue et lutte antifraude temps réel.
- Gérer une crise cloud multi-tenantGestion de crise lors d'un incident cloud multi-tenant affectant indirectement la disponibilité d'un service.
- Tester une restauration après sinistre simuléGuide pratique pour préparer, exécuter et mesurer un test de restauration après un sinistre simulé dans un environnement isolé.
Pages voisines
La citent
- Monolithe ou microservices : choisir sans se mentir
- Accès terrestres, fibre, cuivre et réseaux câblés
- Comprendre pourquoi les systèmes communiquent
- Géographie d'internet, câbles sous-marins et points d'atterrissement
- GRE, IPsec ou GRE dans IPsec pour un tunnel site à site
- NIS2 pour les petites structures
Continuité, sauvegardes, PRA/PCA et haute disponibilité
Elle cite
- Lien dans les deux sens :Chaîne d'alimentation et refroidissement d'un datacenter
- Lien dans les deux sens :La règle 3-2-1 à l'épreuve du rançongiciel
- BGP, Internet, anycast et sécurité des annonces
- Configurer une sauvegarde restic résistante au ransomware
- DNS, DHCP, NTP : services d'infrastructure réseau
- Gestion réseau, supervision et référentiels d’exploitation
: les deux pages se citent l’une l’autre.